
架构与系统设计 / 系统课时
领域服务能不能访问 Repository
领域服务能不能访问 Repository
领域服务有时必须判断“系统里是否已经存在某个业务事实”,这往往需要读取仓储。但依赖 Repository 不等于可以把查询编排、报表检索和持久化细节塞进领域服务。本篇给出可操作的边界:什么时候可以依赖仓储,什么时候应该把查询留在应用层。
学习目标
- 判断领域服务依赖 Repository 是否合理
- 识别“业务事实查询”和“技术性复杂查询”的边界
- 用窄接口避免领域服务被数据库细节污染
可以依赖,但依赖的是领域抽象
在分层架构中,领域层可以声明 Repository 接口,基础设施层提供实现。因此,领域服务依赖一个定义在领域层的 Repository 抽象,并不会形成“领域层依赖基础设施层”。
真正需要警惕的是依赖内容。领域服务应该询问与业务规则直接相关的事实,例如“这个邮箱是否已经被注册”“某个聚合是否存在”。它不应该知道 SQL、ORM、分页、缓存键,也不应该自行拼接复杂筛选条件。
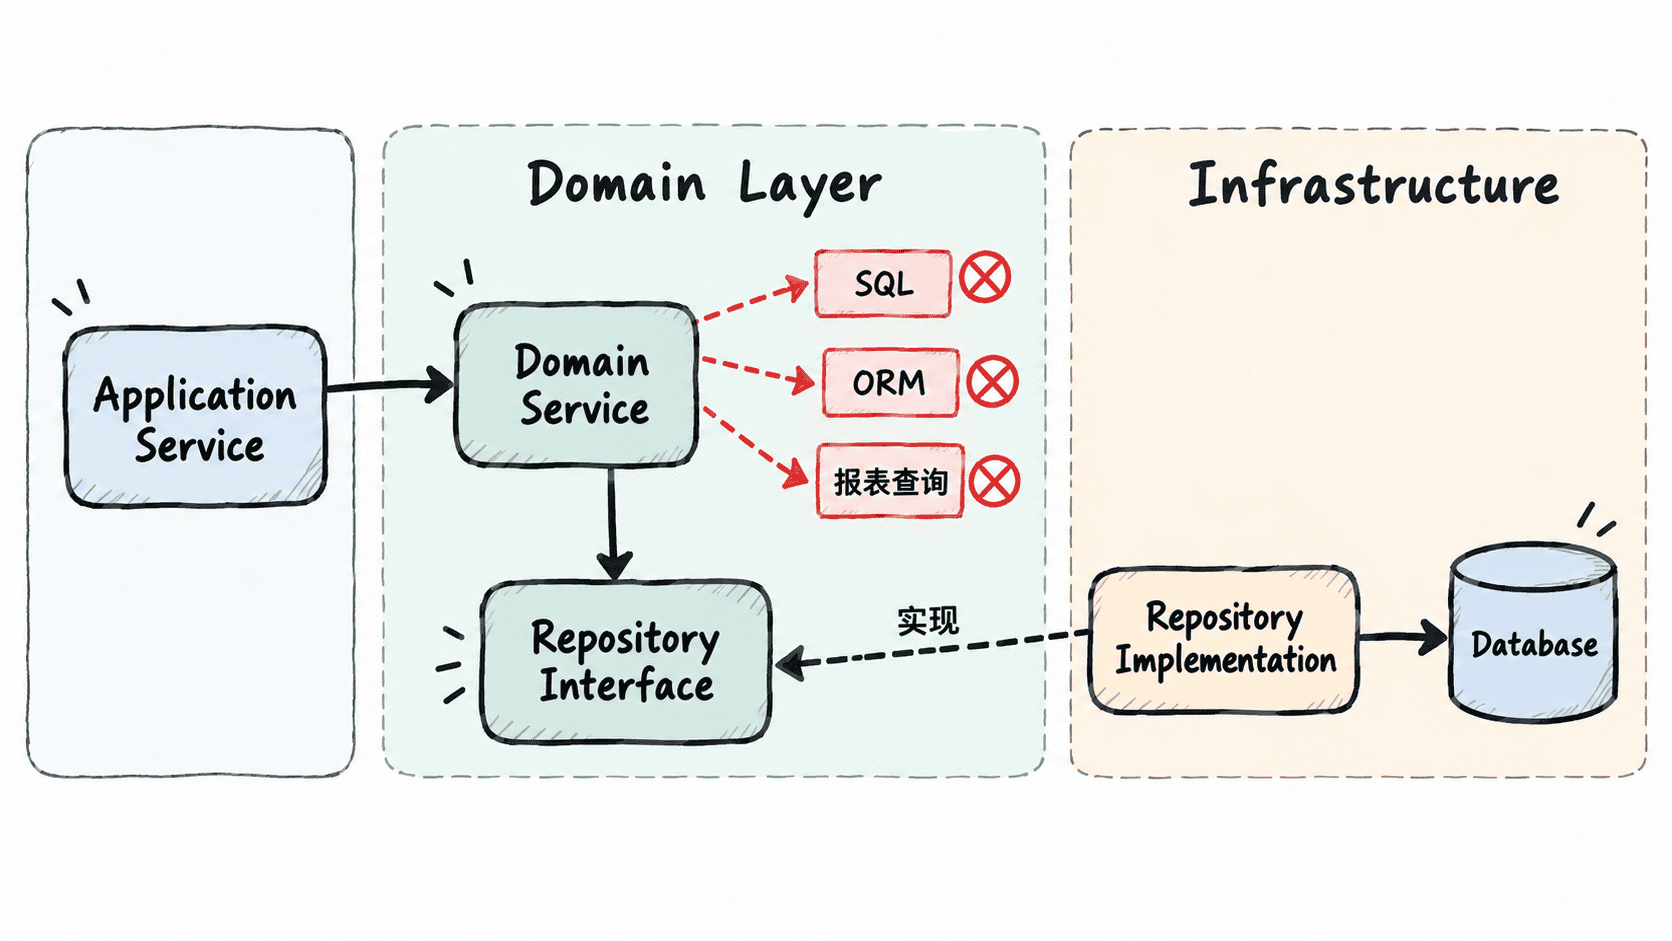
下面的例子把“邮箱不能重复”作为领域规则。领域服务只调用一个业务含义明确的 existsByEmail,并不知道数据来自数据库还是内存。
import java.util.HashSet;
import java.util.Set;

public class Main {
    record Email(String value) {}

    interface UserRepository {
        boolean existsByEmail(Email email);
    }

    static class RegistrationPolicy {
        private final UserRepository users;

        RegistrationPolicy(UserRepository users) {
            this.users = users;
        }

        void ensureEmailAvailable(Email email) {
            if (users.existsByEmail(email)) {
                throw new IllegalStateException("EMAIL_ALREADY_USED");
            }
        }
    }

    static class InMemoryUserRepository implements UserRepository {
        private final Set<String> emails = new HashSet<>();

        void add(String email) {
            emails.add(email);
        }

        public boolean existsByEmail(Email email) {
            return emails.contains(email.value());
        }
    }

    public static void main(String[] args) {
        var repository = new InMemoryUserRepository();
        repository.add("used@example.com");
        var policy = new RegistrationPolicy(repository);

        policy.ensureEmailAvailable(new Email("new@example.com"));
        System.out.println("AVAILABLE");

        try {
            policy.ensureEmailAvailable(new Email("used@example.com"));
        } catch (IllegalStateException e) {
            System.out.println(e.getMessage());
        }
    }
}
预期输出:
AVAILABLE
EMAIL_ALREADY_USED
这个例子中的仓储调用只回答一个领域问题。真实项目中,应用服务仍负责事务边界、调用顺序以及最终保存新用户。
复杂查询通常不该由领域服务承担
如果领域服务开始接收十几个筛选参数,执行联表、分页、排序、聚合报表或返回 DTO,通常说明它已经在承担查询用例,而不是表达领域规则。这类读取更适合放在应用层的 Query Service、读模型或专门的查询接口中。
判断标准不是“Repository 能不能查”,而是“这个查询结果是不是领域规则必须知道的最小事实”。领域服务需要的是 existsByEmail(email),而不是“给我所有同地区、近 30 天注册、按等级排序的用户列表”。
优先让应用层完成加载与编排
当规则需要两个已经明确的聚合对象时,通常优先由应用服务加载它们,再把对象传给领域服务。这样领域服务的输入更透明,单元测试也更简单。
只有当“查询某个领域事实”本身就是规则的一部分,而且把查询搬到应用层会迫使应用层理解业务判定细节时,才值得让领域服务依赖一个窄 Repository 接口。这个边界能让领域服务保持业务表达力,同时避免演变成隐藏 I/O 的查询中心。