
架构与系统设计 / 系统课时
Repository 和 Mapper 有什么区别
Repository 和 Mapper 有什么区别
Repository 和 Mapper 都会参与数据持久化,但它们面对的对象和承担的职责不同。区分二者后,领域模型就不必知道数据库表、SQL 或 ORM 细节,基础设施层也能自由选择 MyBatis、JPA 或其他存储方案。
学习目标
- 区分 Repository 的领域语义与 Mapper、DAO 的数据访问语义
- 理解 Repository 接口与持久化实现应该位于什么边界
- 能判断业务代码是否越过 Repository 直接依赖数据库细节
两者解决的问题不同
Repository 的使用者关心的是领域对象。例如应用服务需要“按订单编号取得订单”,它希望得到 Order 聚合,而不是某张表的一行记录。Repository 因此通常使用领域语言定义方法,如 findById、save,并以聚合根作为主要输入和输出。
Mapper 或 DAO 更接近持久化机制。MyBatis Mapper 通常描述 SQL 操作以及表记录的读取、插入和更新,它可以返回数据库行对应的数据对象,也可能直接暴露分页、条件查询等数据访问能力。
| 对比点 | Repository | Mapper / DAO |
|---|---|---|
| 面向对象 | 聚合根、领域对象 | 表记录、持久化数据 |
| 主要语义 | 获取、保存领域对象 | 查询、插入、更新、删除数据 |
| 主要使用者 | 应用层、领域层 | Repository 实现或基础设施代码 |
| 是否应暴露 SQL 细节 | 不应 | 可以 |
因此,“Repository 就是给 Mapper 换个名字”通常会让分层失去意义。真正的差异不在类名,而在抽象所表达的语言和它隐藏了哪些技术细节。
边界应该放在哪里
典型依赖关系是应用服务依赖 Repository 抽象,基础设施层提供 Repository 实现,再由这个实现调用 Mapper 或 DAO。这样更换数据库框架时,领域模型和应用服务不需要跟着修改。
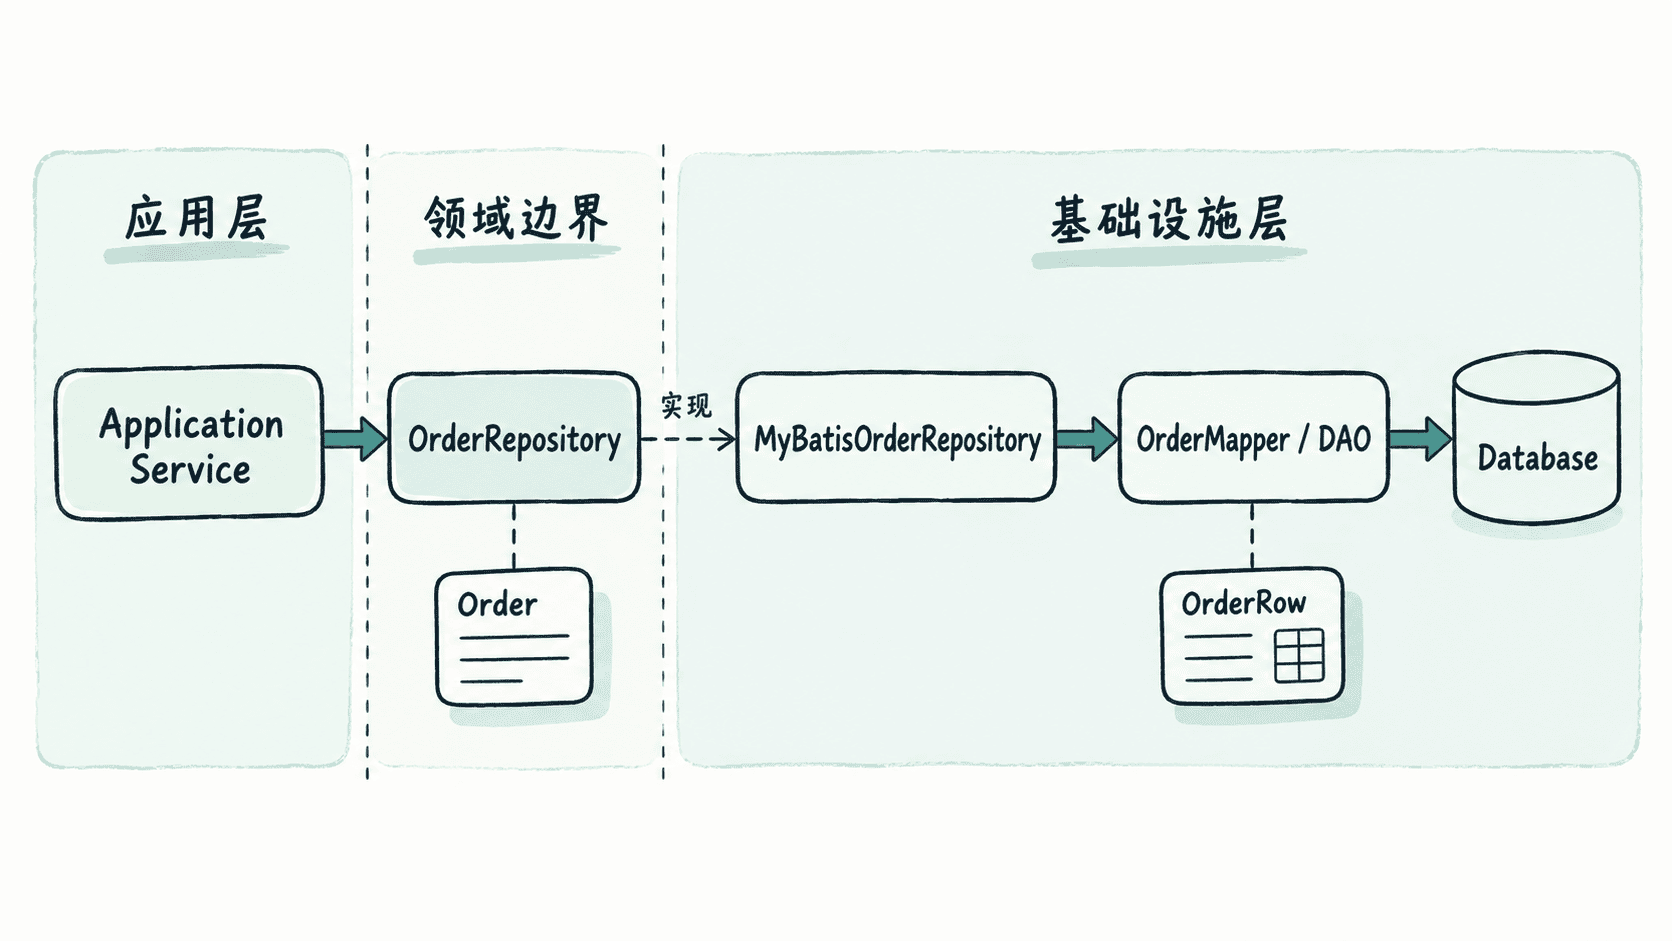
Repository 接口放在领域层还是应用层,具体会受项目采用的 DDD 分层规则影响;关键原则不是目录名称,而是高层业务代码只依赖持久化抽象,具体数据库实现反向依赖这个抽象。
用代码看职责分工
下面用一个可直接运行的 Java 17 示例模拟这种边界。OrderMapper 表示数据访问接口,返回持久化记录 OrderRow;OrderRepository 则返回领域对象 Order。真实 MyBatis 项目中,OrderMapper 的实现通常由 MyBatis 根据 XML 或注解生成。
import java.util.Map;

public class Demo {
    record Order(String id, String status) {}
    record OrderRow(String orderId, String statusCode) {}

    interface OrderRepository {
        Order findById(String id);
    }

    interface OrderMapper {
        OrderRow selectById(String id);
    }

    static final class MyBatisOrderRepository implements OrderRepository {
        private final OrderMapper mapper;

        MyBatisOrderRepository(OrderMapper mapper) {
            this.mapper = mapper;
        }

        @Override
        public Order findById(String id) {
            OrderRow row = mapper.selectById(id);
            if (row == null) {
                return null;
            }
            // 持久化模型在这里转换为领域模型,不泄漏给应用层。
            return new Order(row.orderId(), row.statusCode());
        }
    }

    static final class FakeOrderMapper implements OrderMapper {
        private final Map<String, OrderRow> rows = Map.of(
            "O-1001", new OrderRow("O-1001", "PAID")
        );

        @Override
        public OrderRow selectById(String id) {
            return rows.get(id);
        }
    }

    public static void main(String[] args) {
        OrderRepository repository =
            new MyBatisOrderRepository(new FakeOrderMapper());
        Order order = repository.findById("O-1001");
        System.out.println(order.status());
    }
}
预期输出
PAID这个示例中,调用方只知道 OrderRepository 和 Order。即使以后把 OrderMapper 换成 JPA、MongoDB 客户端或远程存储适配器,只要 Repository 契约保持不变,上层代码就不需要理解新的持久化 API。
判断职责是否混淆
如果应用服务直接调用 OrderMapper.selectById,随后自行拼装领域对象,说明领域与数据访问边界已经泄漏。另一个常见信号是 Repository 接口出现 selectByColumn、updateTableRow、SQL 条件对象等明显数据库术语。
反过来,也没有必要禁止 Repository 实现内部使用多个 Mapper。一个聚合可能跨越多张表,Repository 的职责正是把这些数据访问动作隐藏起来,并向上层呈现完整的领域对象。Mapper 负责“怎样读写数据”,Repository 负责“怎样取得和保存领域模型”,两者因此可以同时存在,而且通常处在不同抽象层次。