
架构与系统设计 / 系统课时
基础设施层到底放什么
基础设施层到底放什么
基础设施层负责把应用需要的技术能力接到真实世界:数据库、消息系统、缓存、文件存储和第三方 API 都常在这里实现。判断一个类是否属于基础设施层,关键不是“它是否重要”,而是它是否主要处理技术细节和外部系统适配。
学习目标
- 识别基础设施层常见的职责边界
- 理解应用层端口与基础设施实现之间的依赖方向
- 避免把业务规则塞进数据库、消息或第三方 API 适配代码
基础设施层解决的是技术接入
应用层经常需要“保存订单”“发送通知”“读取缓存”“上传文件”或“调用支付平台”,但它不应该知道 JDBC 连接、Kafka Producer、Redis 命令、对象存储 SDK 或 HTTP 鉴权细节。
更合适的做法是由内层定义所需能力的接口,也就是端口;基础设施层提供实现,也就是适配器。这样,业务代码依赖的是稳定的业务语义,具体技术可以替换。
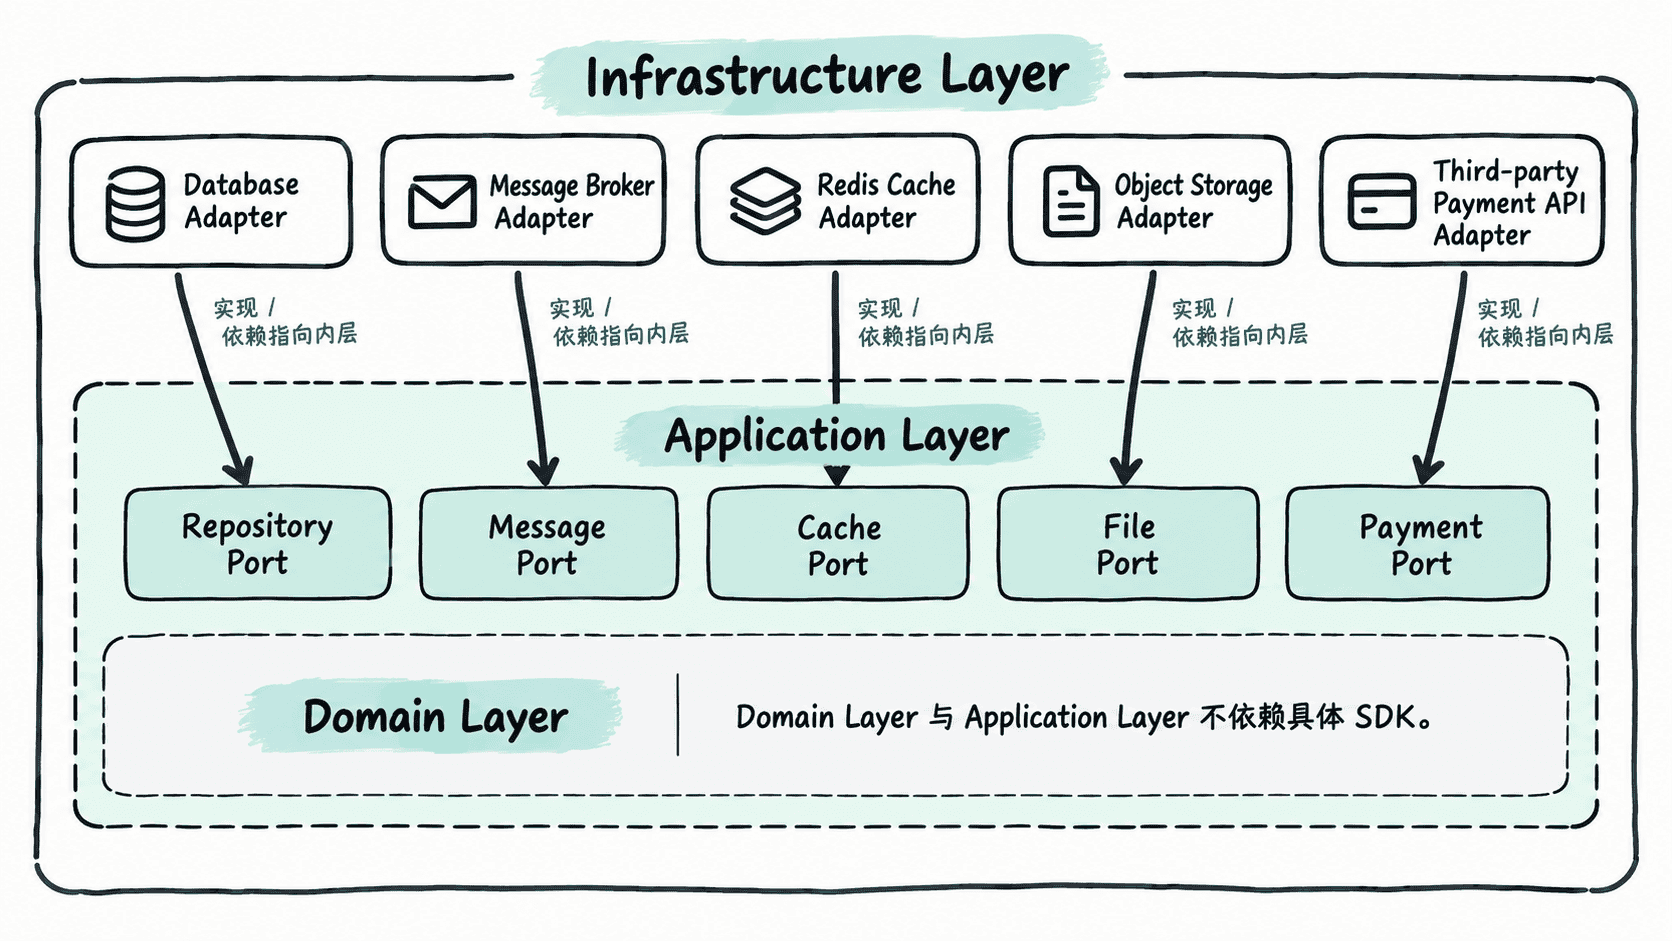
数据库访问只是其中一种基础设施能力。只要代码的主要职责是处理驱动、协议、序列化、重试、连接池、SDK 或外部资源,它通常都属于这一层。
用端口隔离具体技术
下面的 Java 17 示例展示应用服务只依赖 OrderStore 和 Notifier 两个接口。基础设施实现可以使用数据库、消息队列或其他技术;为了让示例可直接运行,这里用内存实现替代真实外部系统。
import java.util.HashMap;
import java.util.Map;

public class InfrastructureDemo {
    record Order(String id, int amount) {}

    // 内层只定义需要什么能力,不暴露数据库或消息系统细节。
    interface OrderStore {
        void save(Order order);
        Order find(String id);
    }

    interface Notifier {
        void orderCreated(Order order);
    }

    static final class CreateOrderService {
        private final OrderStore store;
        private final Notifier notifier;

        CreateOrderService(OrderStore store, Notifier notifier) {
            this.store = store;
            this.notifier = notifier;
        }

        void create(String id, int amount) {
            // 业务约束留在用例附近,而不是下沉到基础设施适配器。
            if (amount <= 0) {
                throw new IllegalArgumentException("amount must be positive");
            }
            Order order = new Order(id, amount);
            store.save(order);
            notifier.orderCreated(order);
        }
    }

    // 可替换适配器实现同一端口;生产环境可换成 JDBC、ORM 等实现。
    static final class InMemoryOrderStore implements OrderStore {
        private final Map<String, Order> data = new HashMap<>();

        public void save(Order order) {
            data.put(order.id(), order);
        }

        public Order find(String id) {
            return data.get(id);
        }
    }

    // 通知适配器也独立于应用服务,可替换为消息队列或第三方通知服务。
    static final class ConsoleNotifier implements Notifier {
        public void orderCreated(Order order) {
            System.out.println("notify order " + order.id());
        }
    }

    public static void main(String[] args) {
        InMemoryOrderStore store = new InMemoryOrderStore();
        CreateOrderService service = new CreateOrderService(store, new ConsoleNotifier());

        service.create("O-2001", 320);
        System.out.println(store.find("O-2001"));
    }
}
预期输出:
notify order O-2001
Order[id=O-2001, amount=320]这里“金额必须为正”属于业务约束,所以放在应用或领域逻辑附近;OrderStore 如何落库、Notifier 如何连接消息系统,则属于基础设施实现细节。
哪些代码通常应该放这里
常见内容包括数据库 Repository 的实现、ORM 映射、SQL 查询实现、消息发布器与消费者适配、缓存客户端封装、对象存储与文件系统适配、邮件短信网关,以及第三方 HTTP API 客户端。
这些类可以知道表名、Topic、Bucket、URL、序列化格式和重试策略,但不应决定“订单能否取消”“会员能否升级”这类业务规则。后者属于领域或应用决策,基础设施只负责执行技术动作。
依赖方向比文件夹名字更重要
把一个类放进 infrastructure 包,并不会自动获得正确分层。真正需要检查的是依赖:领域层和应用层不应为了使用某个数据库或 SDK 而反向依赖基础设施实现。
如果 CreateOrderService 直接 new JdbcOrderRepository(),应用层就知道了具体技术。更好的方式是通过构造器接收 OrderStore,由程序入口或依赖注入容器选择具体实现。这样测试时可以换成内存实现,生产环境再接数据库。
判断边界时看“为什么变化”
一个类如果因为更换数据库、消息中间件、缓存产品、文件存储或第三方接口而变化,它大概率属于基础设施层。一个类如果因为业务政策、领域规则或用例流程变化而变化,则更可能属于领域层或应用层。
基础设施层的价值不是“把杂项集中起来”,而是把外部技术的不稳定性隔离在边界之外,让内层代码继续用业务语言表达意图。