
架构与系统设计 / 系统课时
Repository 怎样保存整个聚合
Repository 怎样保存整个聚合
Repository 的关键不是“帮每张表写一个 DAO”,而是以聚合为持久化单位。本节通过订单示例说明:领域层只声明 OrderRepository,基础设施层把 Order 与持久化模型互相转换,再调用具体数据库组件一次保存或重建完整聚合。
学习目标
- 理解 Repository 为什么围绕聚合根而不是数据库表设计
- 看懂基础设施层如何完成聚合与持久化模型之间的转换
- 明确保存子实体时的事务边界与加载边界
Repository 面向聚合而不是表
订单聚合可能落到 orders 和 order_lines 两张表,但应用层不应该先保存订单表、再循环保存明细表。那会把聚合内部结构和事务细节泄漏到用例代码中,也让“保存了一半”的状态更容易出现。
更合适的接口是 save(Order order) 和 findById(String id)。调用方只处理一个完整 Order;至于需要写几张表、执行几条 SQL、怎样映射字段,由基础设施层负责。
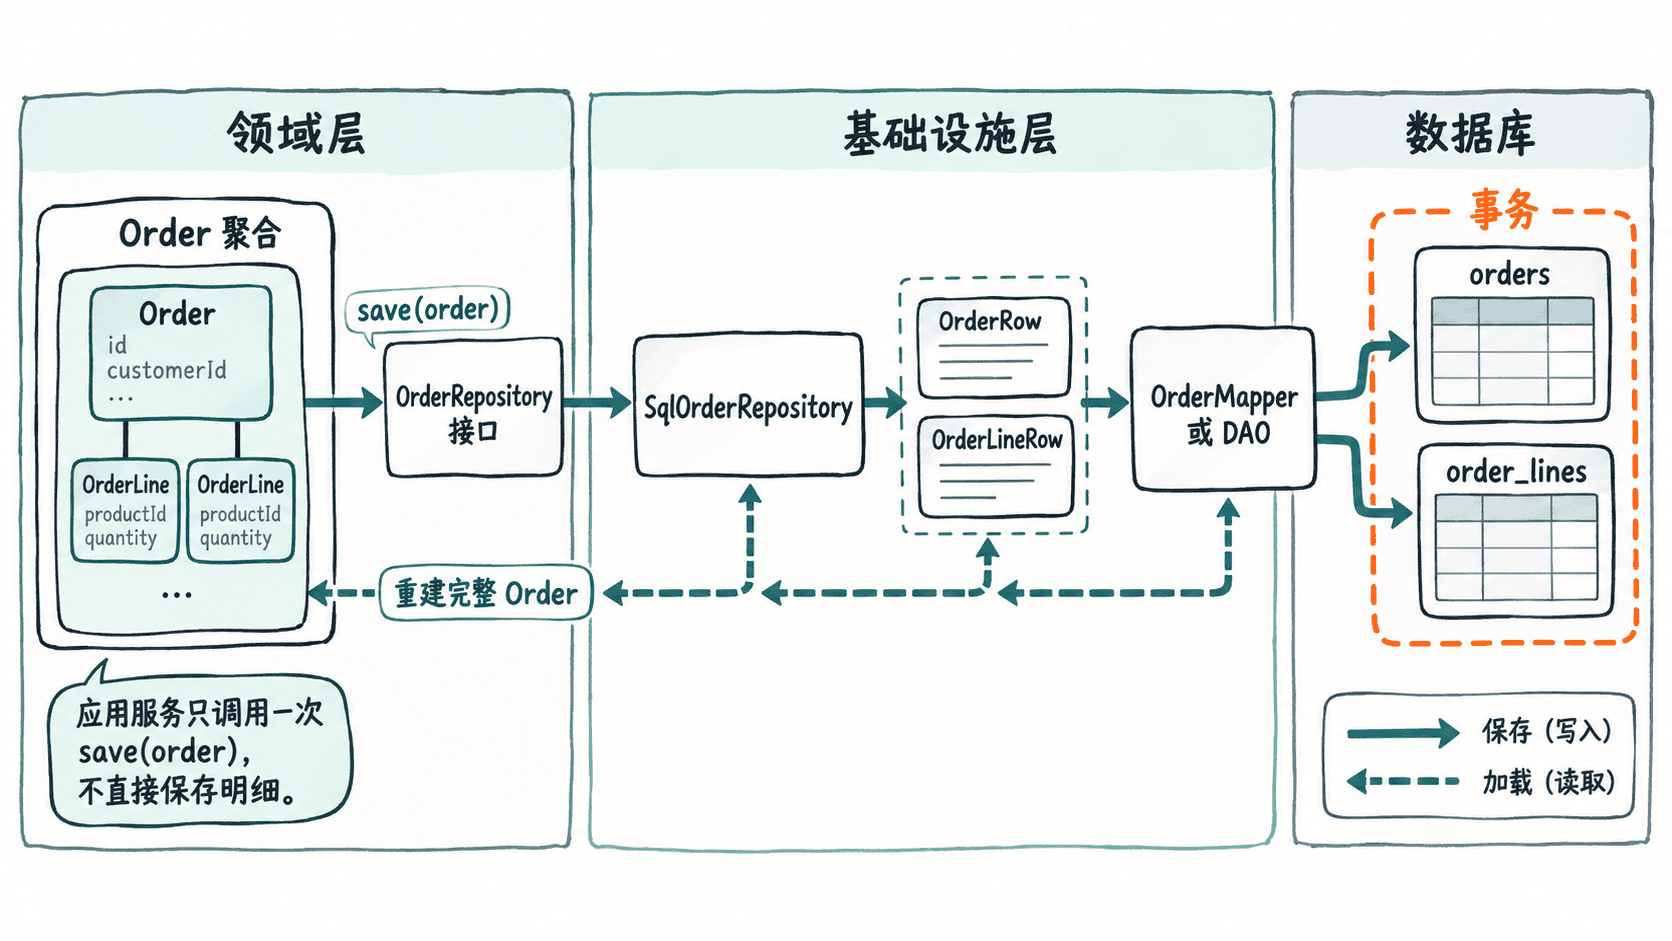
基础设施层负责转换与数据库调用
下面的完整示例把 OrderRepository 作为领域侧抽象,把 SqlOrderRepository 放在基础设施侧。为了让示例无需外部依赖,InMemoryOrderMapper 用内存模拟具体数据库组件;真实项目中可替换为 MyBatis、JPA 或 JDBC 适配器,Repository 的职责不变。
import java.util.ArrayList;
import java.util.HashMap;
import java.util.List;
import java.util.Map;
import java.util.Optional;

public class Main {
    record OrderLine(String sku, int quantity) {
        OrderLine {
            if (sku == null || sku.isBlank() || quantity <= 0) {
                throw new IllegalArgumentException("invalid order line");
            }
        }
    }

    static final class Order {
        private final String id;
        private final List<OrderLine> lines;

        Order(String id, List<OrderLine> lines) {
            if (id == null || id.isBlank()) {
                throw new IllegalArgumentException("id is required");
            }
            this.id = id;
            this.lines = new ArrayList<>(lines);
        }

        String id() {
            return id;
        }

        List<OrderLine> lines() {
            return List.copyOf(lines);
        }
    }

    interface OrderRepository {
        void save(Order order);
        Optional<Order> findById(String id);
    }

    record OrderRow(String id) {
    }

    record OrderLineRow(String orderId, String sku, int quantity) {
    }

    interface OrderMapper {
        void upsertOrder(OrderRow row);
        void replaceLines(String orderId, List<OrderLineRow> rows);
        Optional<OrderRow> findOrder(String orderId);
        List<OrderLineRow> findLines(String orderId);
    }

    static final class InMemoryOrderMapper implements OrderMapper {
        private final Map<String, OrderRow> orders = new HashMap<>();
        private final Map<String, List<OrderLineRow>> lines = new HashMap<>();

        public void upsertOrder(OrderRow row) {
            orders.put(row.id(), row);
        }

        public void replaceLines(String orderId, List<OrderLineRow> rows) {
            lines.put(orderId, List.copyOf(rows));
        }

        public Optional<OrderRow> findOrder(String orderId) {
            return Optional.ofNullable(orders.get(orderId));
        }

        public List<OrderLineRow> findLines(String orderId) {
            return lines.getOrDefault(orderId, List.of());
        }
    }

    static final class SqlOrderRepository implements OrderRepository {
        private final OrderMapper mapper;

        SqlOrderRepository(OrderMapper mapper) {
            this.mapper = mapper;
        }

        public void save(Order order) {
            mapper.upsertOrder(new OrderRow(order.id()));

            List<OrderLineRow> rows = order.lines().stream()
                    .map(line -> new OrderLineRow(
                            order.id(), line.sku(), line.quantity()))
                    .toList();

            // 根实体与所有子实体由一个 Repository 协调持久化。
            mapper.replaceLines(order.id(), rows);
        }

        public Optional<Order> findById(String id) {
            return mapper.findOrder(id).map(row -> {
                List<OrderLine> lines = mapper.findLines(id).stream()
                        .map(line -> new OrderLine(line.sku(), line.quantity()))
                        .toList();
                return new Order(row.id(), lines);
            });
        }
    }

    public static void main(String[] args) {
        OrderMapper mapper = new InMemoryOrderMapper();
        OrderRepository repository = new SqlOrderRepository(mapper);

        Order order = new Order(
                "O-1001",
                List.of(new OrderLine("BOOK", 2), new OrderLine("PEN", 1))
        );

        repository.save(order);
        System.out.printf("saved aggregate=%s, lineCount=%d%n",
                order.id(), order.lines().size());

        Order loaded = repository.findById("O-1001").orElseThrow();
        System.out.printf("loaded aggregate=%s, lineCount=%d%n",
                loaded.id(), loaded.lines().size());
    }
}
预期输出
saved aggregate=O-1001, lineCount=2
loaded aggregate=O-1001, lineCount=2
真实数据库必须保证原子性
示例中的 upsertOrder 与 replaceLines 是两个数据库动作的抽象。在真实关系数据库中,它们应处于同一个事务:根记录成功但明细写入失败时,整个保存必须回滚,否则数据库里会出现一个无法还原为合法聚合的半成品。
事务通常由基础设施实现或应用层事务边界协调,但事务覆盖的持久化范围应与聚合一致。不要把 OrderLineRepository 暴露给应用服务,让它在聚合之外独立修改订单明细;这等于绕过聚合根。
加载时也要一次重建完整聚合
findById 不只是“查一行订单”。它需要读取根记录及本次业务操作所需的子实体,然后重建 Order。如果聚合很大,说明边界可能需要重新评估,而不是简单把 Repository 改成按表返回半个领域对象。
同时要避免让领域对象依赖 OrderRow、ORM Entity 或 Mapper 类型。持久化模型属于基础设施细节;领域模型只表达业务含义,转换逻辑由 Repository 实现承担。
Repository 与 DAO 的边界
DAO、Mapper 或 ORM Repository 通常直接面向表、文档或持久化实体;DDD Repository 面向领域聚合。两者可以同时存在:SqlOrderRepository 负责“保存一个订单聚合”,内部再调用 OrderMapper 负责具体读写。
这样应用层只看见 OrderRepository,领域层保持对数据库技术无感,基础设施层则集中处理字段映射、SQL/ORM 调用和事务。只要这个边界没有泄漏,未来把 MyBatis 换成 JPA,或把关系库存储改成其他实现,都不需要改写订单的领域行为。