
架构与系统设计 / 系统课时
Repository 应该按表还是按聚合设计
Repository 应该按表还是按聚合设计
设计 Repository 时,最容易出现的误区是看到一张表就创建一个 Repository。DDD 更关注领域的一致性边界:通常一个聚合根对应一个 Repository,而一个 Repository 完全可以在内部协调多张表完成加载和保存。
学习目标
- 理解 Repository 为什么通常围绕聚合根设计
- 能识别“每张表一个 Repository”造成的领域边界泄漏
- 知道多表聚合在基础设施层中应该如何持久化
先找聚合边界,而不是数据库表
假设订单领域中,Order 是聚合根,OrderLine 是订单内部实体。数据库为了满足关系模型和查询需求,可能把它们保存到 orders 与 order_lines 两张表,但这并不意味着领域层需要 OrderRepository 和 OrderLineRepository 两个仓储。
应用代码真正需要执行的是“取得一个订单”“保存一个订单”。订单行是否允许增加、删除以及数量如何变化,都应通过 Order 聚合维护。因此持久化入口也应尽量和这个一致性边界对齐。
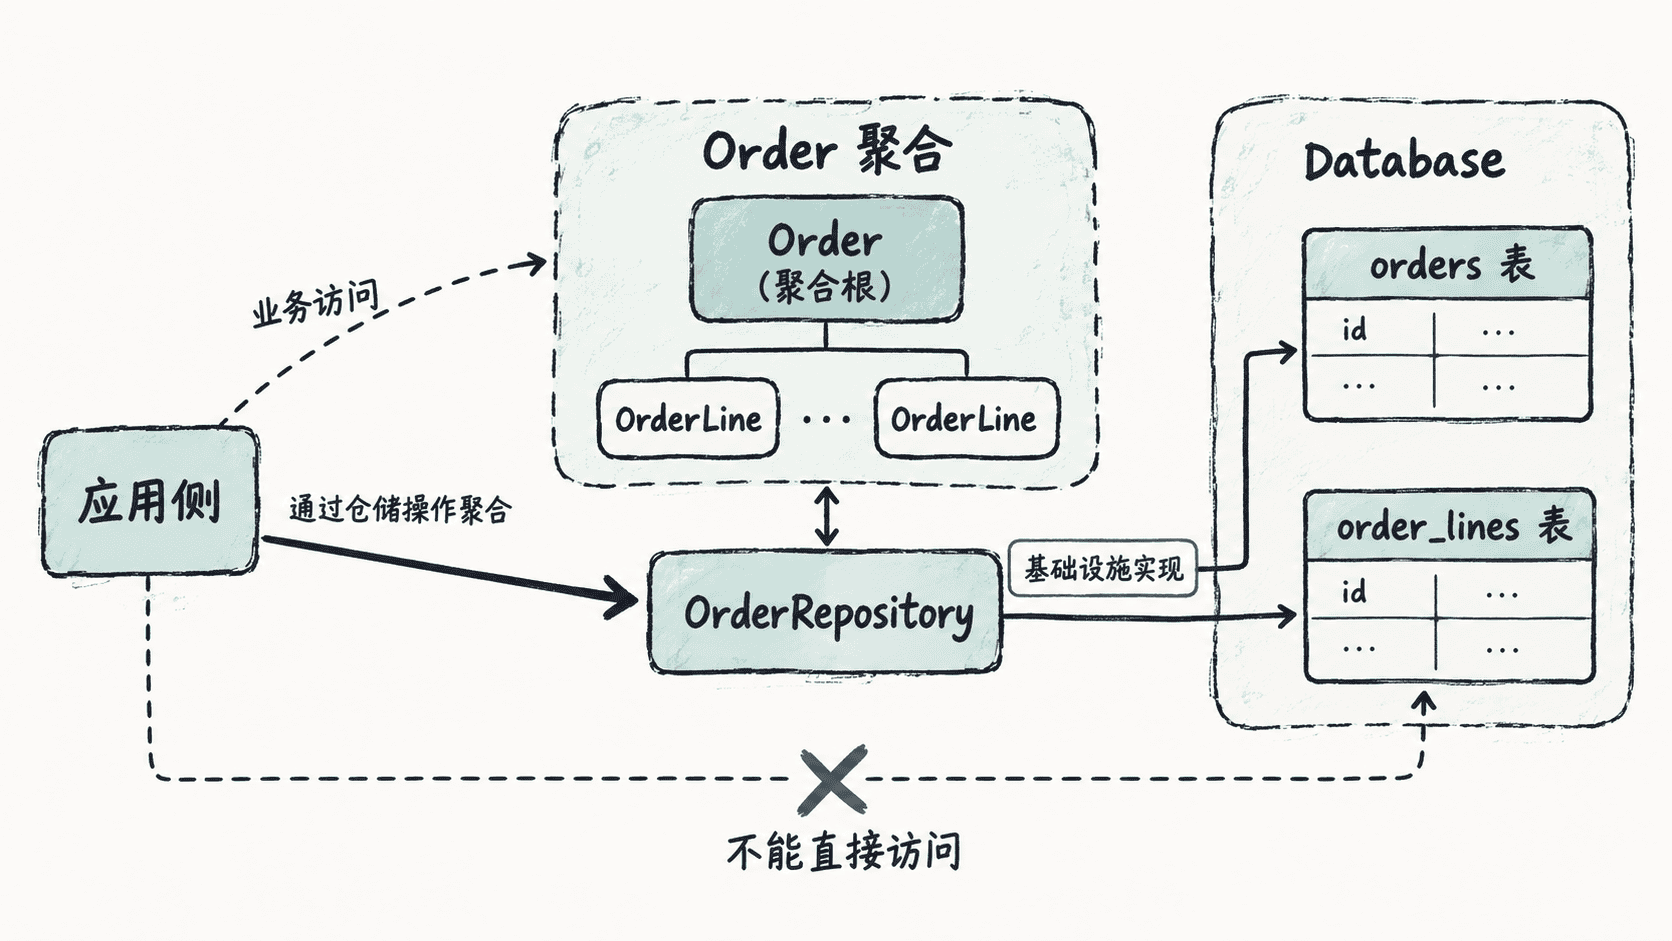
表是持久化模型的一部分,聚合则是业务一致性的边界。二者可能一一对应,但这只是实现上的巧合,不应反过来用表结构决定领域模型。
每张表一个 Repository 会带来什么问题
如果 orders 和 order_lines 分别暴露为两个 Repository,应用服务往往需要先保存订单,再逐条保存订单行。这样一来,应用层开始负责聚合内部的持久化顺序、事务一致性和对象组装,原本应该隐藏在基础设施层的知识被泄漏出来。
更严重的是,调用方可能绕过 Order,直接通过 OrderLineRepository 修改订单行。此时聚合根已经无法保证自己的业务规则,例如“已关闭订单不能新增商品”这样的不变量可能被轻易绕过。
用代码保存一个多表聚合
下面的 Java 17 示例把订单和订单行视为同一个聚合。基础设施中的 TableBackedOrderRepository 可以分别调用主表和明细表网关,但应用层只看到一个 OrderRepository。
import java.math.BigDecimal;
import java.util.ArrayList;
import java.util.HashMap;
import java.util.List;
import java.util.Map;

public class Demo {
    record OrderLine(String sku, int quantity, BigDecimal unitPrice) {
        BigDecimal subtotal() {
            return unitPrice.multiply(BigDecimal.valueOf(quantity));
        }
    }

    static final class Order {
        private final String id;
        private final List<OrderLine> lines = new ArrayList<>();

        Order(String id) {
            this.id = id;
        }

        String id() {
            return id;
        }

        void addLine(String sku, int quantity, BigDecimal unitPrice) {
            if (quantity <= 0) {
                throw new IllegalArgumentException("quantity must be positive");
            }
            lines.add(new OrderLine(sku, quantity, unitPrice));
        }

        List<OrderLine> lines() {
            return List.copyOf(lines);
        }

        BigDecimal total() {
            return lines.stream()
                .map(OrderLine::subtotal)
                .reduce(BigDecimal.ZERO, BigDecimal::add);
        }
    }

    interface OrderRepository {
        void save(Order order);
        Order findById(String id);
    }

    static final class TableBackedOrderRepository implements OrderRepository {
        private final Map<String, Boolean> orders = new HashMap<>();
        private final Map<String, List<OrderLine>> orderLines = new HashMap<>();

        @Override
        public void save(Order order) {
            // 真实实现可在同一数据库事务中分别写 orders 和 order_lines。
            orders.put(order.id(), true);
            orderLines.put(order.id(), new ArrayList<>(order.lines()));
        }

        @Override
        public Order findById(String id) {
            if (!orders.containsKey(id)) {
                return null;
            }
            Order order = new Order(id);
            for (OrderLine line : orderLines.getOrDefault(id, List.of())) {
                order.addLine(line.sku(), line.quantity(), line.unitPrice());
            }
            return order;
        }
    }

    public static void main(String[] args) {
        Order order = new Order("O-2001");
        order.addLine("BOOK", 2, new BigDecimal("10.00"));
        order.addLine("PEN", 1, new BigDecimal("5.00"));

        OrderRepository repository = new TableBackedOrderRepository();
        repository.save(order);

        Order loaded = repository.findById("O-2001");
        System.out.println("lines=" + loaded.lines().size());
        System.out.println("total=" + loaded.total());
    }
}
预期输出
lines=2
total=25.00
示例中的两个 Map 分别模拟订单表和订单行表。真实项目可以在 Repository 实现内部调用两个 MyBatis Mapper,并通过数据库事务保证整个聚合保存成功或失败,而不把这种协调逻辑暴露给应用层。
什么时候不必建立领域 Repository
并不是所有数据库表都属于领域聚合。纯报表表、搜索索引、中间结果、只读投影以及没有领域行为的后台 CRUD 数据,可以采用 DAO、Mapper 或专门的查询服务,不必机械包装成 Repository。
判断标准应从业务模型出发:如果某个对象只能通过一个聚合根维护一致性,就让这个聚合根成为 Repository 的入口;如果数据只是查询投影或基础设施记录,则可以使用更直接的数据访问抽象。Repository 的数量最终由领域边界决定,而不是由数据库里有多少张表决定。