
架构与系统设计 / 系统课时
领域层为什么不应该依赖 Spring
领域层为什么不应该依赖 Spring
领域层负责表达业务规则,而 Spring、数据库和 HTTP 类型负责运行环境与技术接入。把这些技术细节直接塞进实体和值对象,会让业务模型只能在特定框架中运行,也让单元测试、迁移和复用都变得更困难。
学习目标
- 识别领域模型对 Spring、数据库和 HTTP 类型的反向依赖
- 理解“领域层定义规则、外围层负责适配”的依赖方向
- 用纯 Java 领域对象保持模型独立且易测试
领域层应该依赖什么
理想的领域对象主要依赖语言本身、领域值对象,以及少量由领域层自己定义的抽象。实体是否允许取消、金额如何计算、状态怎样转换,这些规则不需要知道请求来自 HTTP,也不需要知道最终保存到 MySQL、MongoDB 还是内存。
一旦领域对象大量出现 @Service、@Autowired、HttpServletRequest、持久化实现类或数据库连接对象,业务代码就开始依赖技术环境。此时测试一个简单规则,可能也必须启动 Spring 容器或准备数据库。
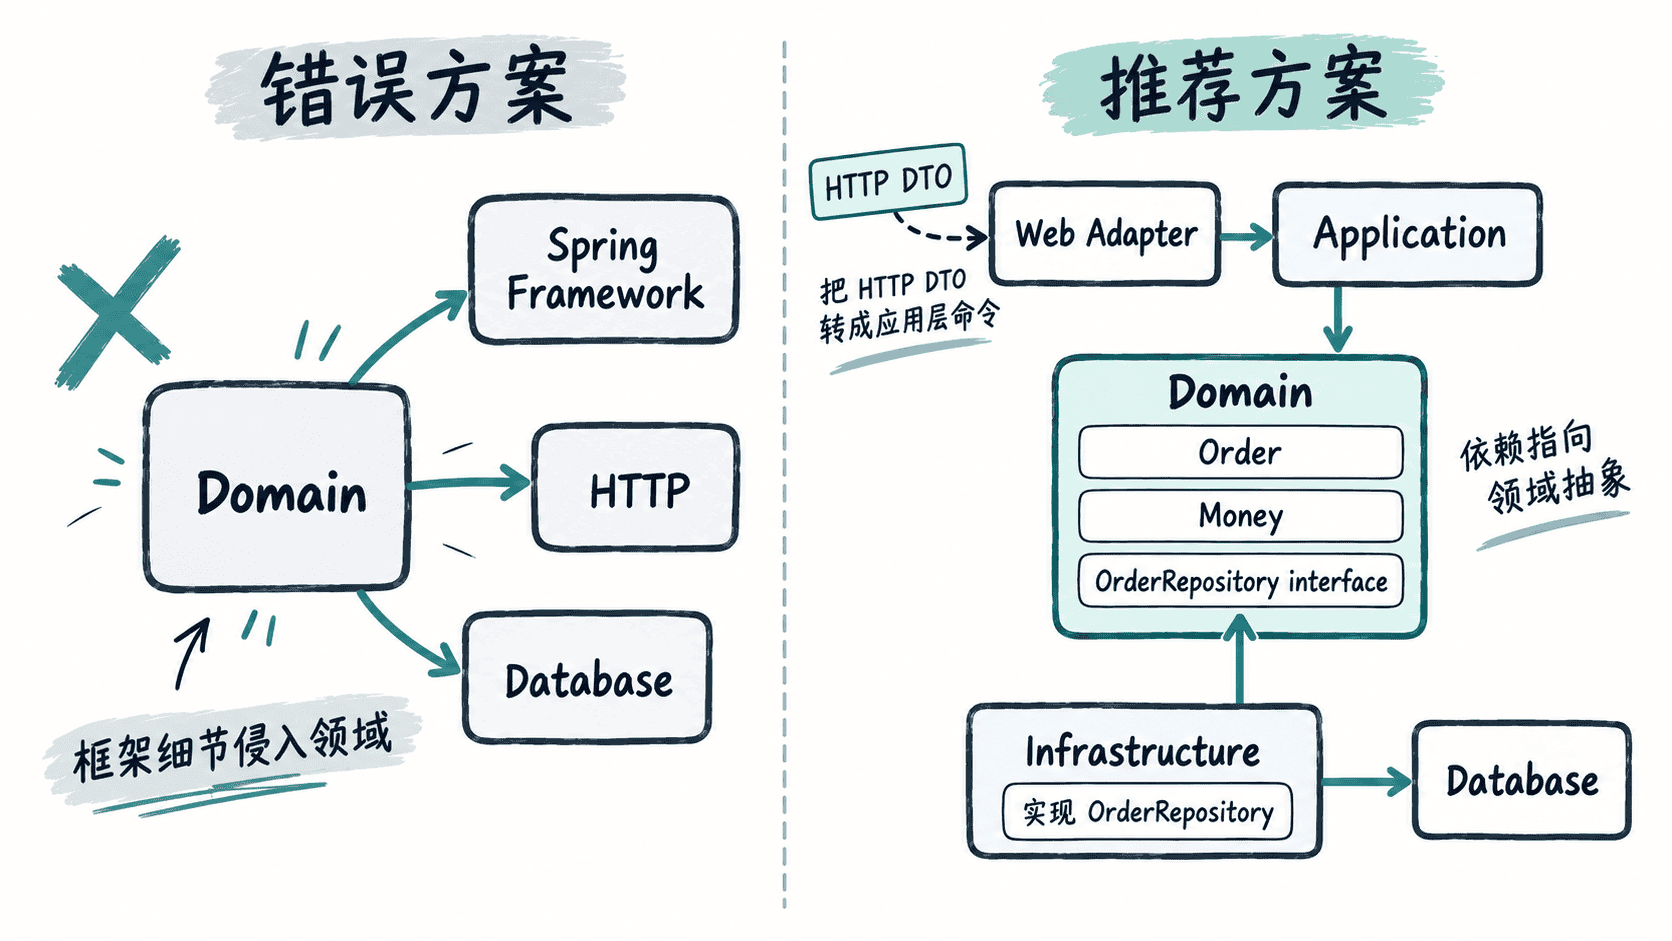
技术类型进入领域模型会带来什么
最直接的问题是可测试性下降。假设一个订单取消规则只是检查状态,却因为实体依赖 Spring Bean 才能工作,那么验证规则就不再是普通对象测试,而变成框架集成测试。测试更慢,失败原因也更复杂。
第二个问题是模型语义被污染。HttpServletRequest 表示传输协议,数据库访问 API 描述持久化机制,它们都不是“订单为什么能取消”的业务概念。技术细节越多,读代码时越难看出真正的业务规则。
第三个问题是替换成本上升。迁移 Web 框架、数据库或消息组件时,如果领域层直接引用这些 API,改动会沿依赖链进入核心模型;如果技术细节停留在适配层,领域规则通常可以保持不变。
保持领域对象为纯 Java
下面的示例不启动 Spring,也不访问数据库,直接验证订单的业务行为:
public class DomainIndependenceDemo {
    enum OrderStatus {
        CREATED, PAID, CANCELLED
    }

    static final class Order {
        private OrderStatus status;

        Order(OrderStatus status) {
            this.status = status;
        }

        void cancel() {
            if (status == OrderStatus.PAID) {
                throw new IllegalStateException("paid order cannot be cancelled");
            }
            status = OrderStatus.CANCELLED;
        }

        OrderStatus status() {
            return status;
        }
    }

    public static void main(String[] args) {
        Order order = new Order(OrderStatus.CREATED);
        order.cancel();
        System.out.println(order.status());
    }
}
预期输出:
CANCELLED这里的 Order 只描述状态和取消规则。它不知道谁调用自己,也不知道状态最终存在哪里,因此可以在普通 JVM 中快速验证。
Spring 应该出现在哪里
Spring 很适合放在应用层和基础设施层,用来组装对象、开启事务、实现仓储、接收 HTTP 请求或发布消息。关键不是“项目里不能用 Spring”,而是让框架依赖停留在核心模型之外。
常见做法是由领域层定义 OrderRepository 这样的仓储接口,基础设施层再使用 Spring Data JPA、JDBC 或其他技术实现它。应用服务依赖领域接口,Spring 负责在运行时把具体实现装配进去。这样依赖方向是“基础设施依赖领域契约”,而不是“领域依赖数据库框架”。
验证边界时,可以先在不启动 Spring 的单元测试中测试领域规则;只有仓储实现、事务配置和 HTTP 适配等技术部分需要进入 Spring 集成测试。测试层次因此与架构边界保持一致。
不是所有注解都必须绝对禁止
实际项目中,有些团队会在实体上保留少量 JPA 注解,以换取开发效率。是否接受这种折中取决于团队对框架耦合、持久化复杂度和测试策略的权衡。需要警惕的不是某个注解本身,而是领域规则是否开始依赖容器生命周期、数据库会话、HTTP 上下文或框架回调才能成立。
最实用的边界检查是:把领域代码单独放进一个不依赖 Spring 的模块后,核心业务规则是否仍能编译并执行。如果答案是肯定的,技术框架就在为领域模型服务;如果答案是否定的,就应该继续检查哪些技术类型或生命周期已经侵入核心。