
架构与系统设计 / 系统课时
为什么不能一个 Entity 到处传
为什么不能一个 Entity 到处传
把同一个 Entity 同时用于 API 入参、领域计算和数据库持久化,看似省掉了转换代码,却把三个变化速度不同的边界绑在一起。本节用一个最小例子说明这种耦合如何产生数据泄露、规则绕过和数据库结构外泄,并给出拆分模型时应遵循的判断标准。
学习目标
- 解释 API、领域模型和持久化模型为什么不应共享同一套结构
- 识别“一个 Entity 到处传”带来的安全、演进和职责耦合
- 判断何时应通过 DTO、领域对象和持久化对象隔离变化
三个边界关注的是不同问题
API 关注“客户端允许提交什么、应该看到什么”;领域层关注“不变量、行为和业务语义”;数据库关注“怎样存、怎样查、怎样兼容表结构”。三者可能在某一刻字段相似,但相似不等于职责相同。
| 边界 | 主要问题 | 常见字段特征 |
|---|---|---|
| API | 对外契约是否稳定、安全 | 展示字段、校验字段、分页或组合字段 |
| 领域 | 业务规则是否被正确执行 | 值对象、状态、行为需要的属性 |
| 持久化 | 数据如何落库与恢复 | 主键、外键、版本号、审计列 |
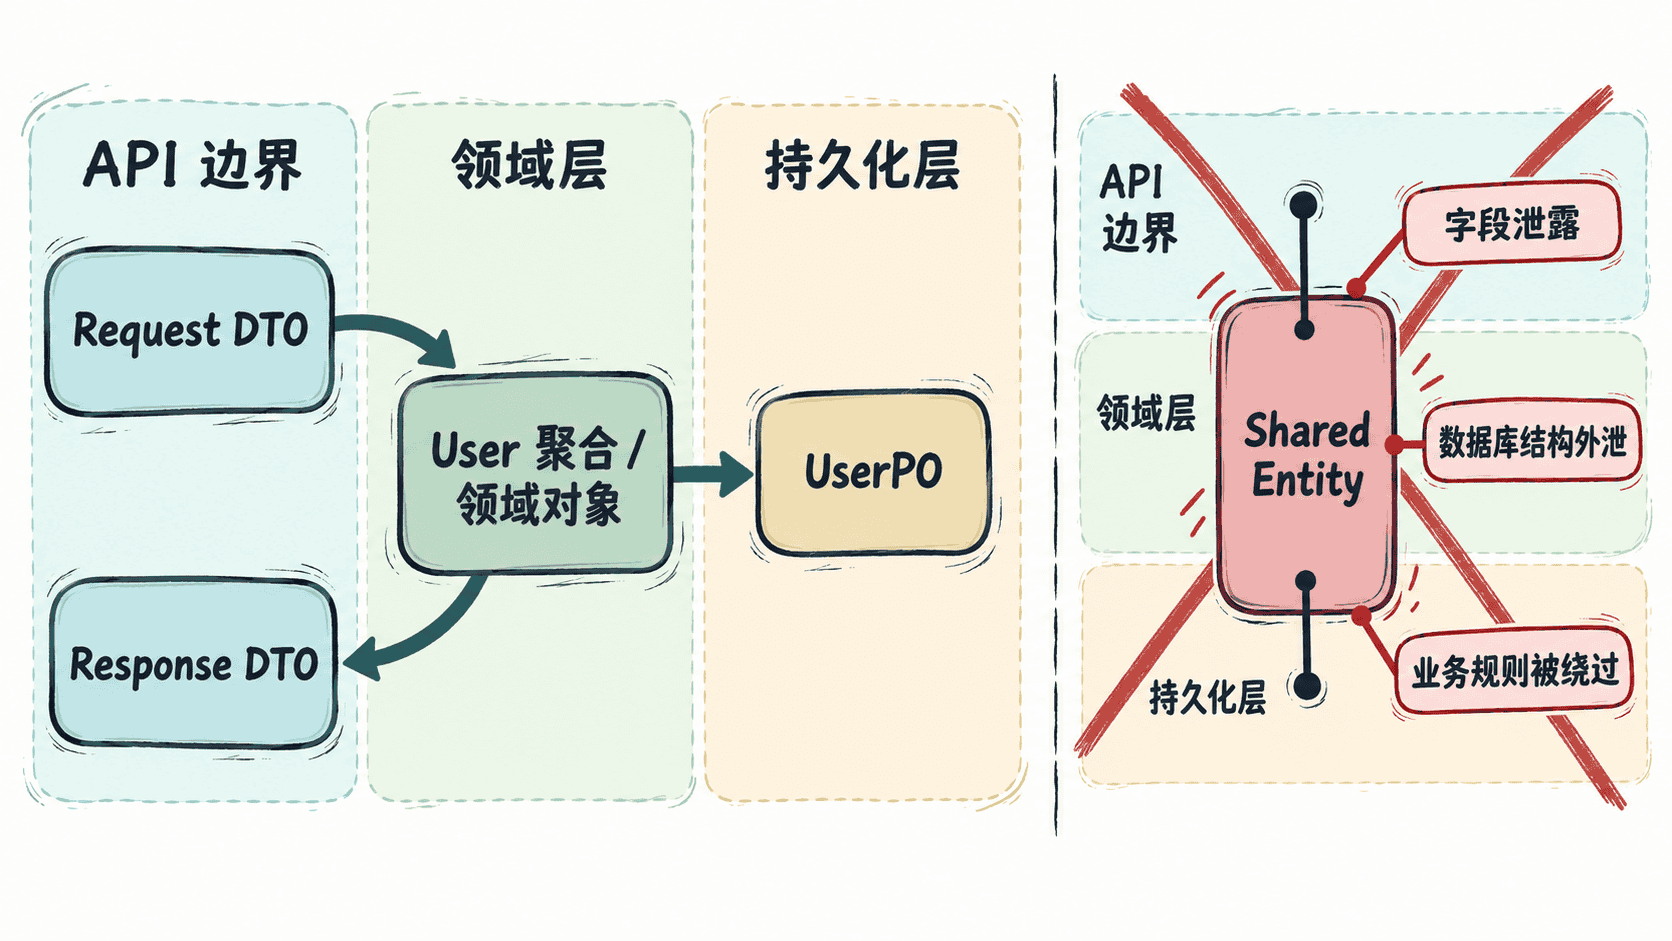
共用模型会把内部字段带到错误的边界
下面的 Java 17 示例把同一个 UserEntity 既当作持久化数据,也直接打印成接口响应。为了保存密码摘要,类中增加了 passwordHash;因为 API 也复用这个类型,内部字段随即出现在输出中。
java
public class Main {
    record UserEntity(
            long id,
            String email,
            String passwordHash,
            String status) {
    }

    public static void main(String[] args) {
        // passwordHash 是持久化需要的内部字段,不应成为公开 API 契约。
        UserEntity stored = new UserEntity(
                42L,
                "alice@example.com",
                "stored-hash",
                "ACTIVE");

        // 模拟“查询数据库后直接把 Entity 返回给 API”。
        System.out.println("API response = " + stored);
    }
}
预期输出
text
API response = UserEntity[id=42, email=alice@example.com, passwordHash=stored-hash, status=ACTIVE]这个输出不是序列化框架的特例,而是设计问题的缩影:只要对外契约直接依赖持久化类型,数据库新增的技术字段就可能进入接口。反方向也一样危险——为了适配接口临时增加的字段、可空性或 setter,也会污染领域和持久化模型。
更严重的问题是规则和演进被绑死
当 Entity 暴露可修改字段时,应用层可能直接设置 status,绕过领域对象本应执行的状态转换规则。数据库把 email 拆成两列、增加乐观锁版本号,或 API 需要把多个字段组合成一个展示值时,也会迫使同一个类不断兼容彼此无关的需求。
什么时候可以暂时复用
内部原型、一次性脚本或几乎没有业务规则的简单 CRUD,在边界非常稳定时可以接受少量复用,但要明确这是成本权衡,而不是默认架构。只要出现对外 API、敏感字段、领域不变量、独立数据库演进或多种读模型中的任一项,就应该让 DTO、领域对象和持久化对象各自承担自己的职责,并在边界处显式转换。
按自己的节奏,确认真正理解。