
架构与系统设计 / 系统课时
Infrastructure 包怎样避免无限膨胀
Infrastructure 包怎样避免无限膨胀
Infrastructure 最容易变成项目里的“其他”目录:数据库实现、MQ、缓存、第三方接口、文件存储都往里塞,最终类很多却找不到边界。解决方法不是继续增加 util、common,而是按技术能力建立稳定的二级边界,再让每个实现明确对应某个领域或应用端口。
学习目标
- 为 persistence、messaging、client 等基础设施能力建立清晰的二级边界
- 用“实现哪个端口”约束 Infrastructure 中类的归属
- 识别会导致 Infrastructure 失控的常见目录设计
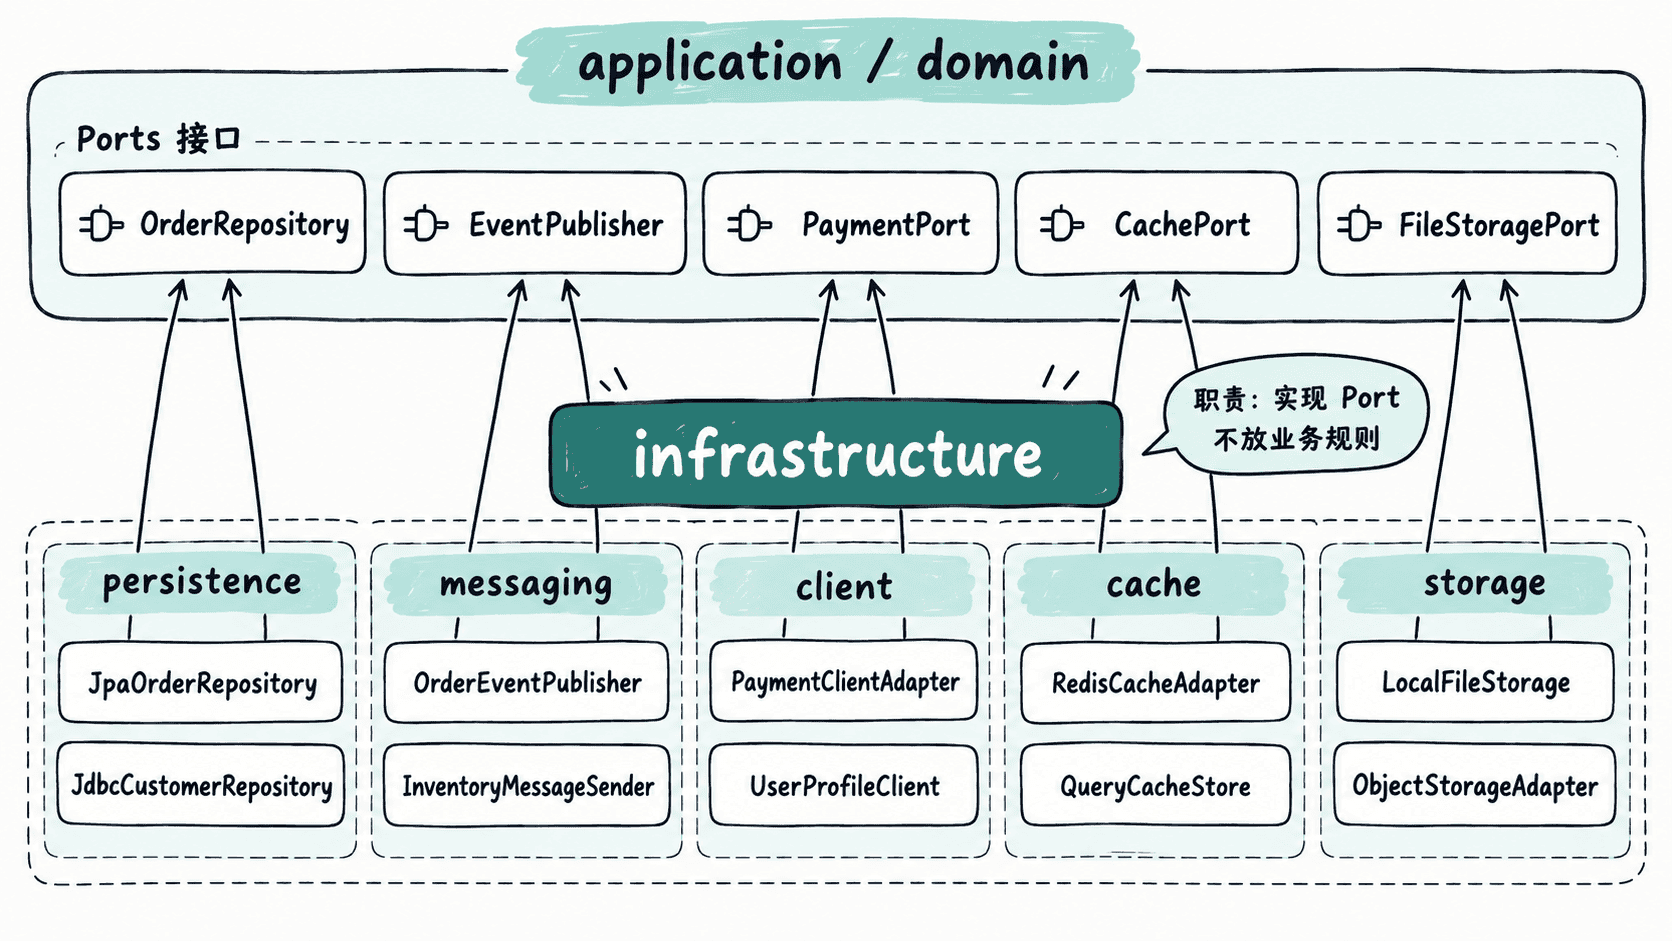
先按外部能力分二级边界
Infrastructure 中的类之所以容易膨胀,是因为它们都属于“技术实现”,但变化原因并不相同。数据库表结构变化会影响 persistence;消息协议变化会影响 messaging;第三方 API 变化会影响 client。把这些不同变化原因拆开,目录才有长期可维护性。
推荐先按能力建立二级边界:
| 二级包 | 放什么 | 典型类 |
|---|---|---|
persistence |
ORM、DAO、Repository 实现、数据库映射 | JpaOrderRepository |
messaging |
消息发布与消费适配器 | KafkaOrderEventPublisher |
client |
第三方 HTTP/RPC 客户端适配 | PaymentGatewayClient |
cache |
Redis、本地缓存实现 | RedisProductCache |
storage |
对象存储、文件系统实现 | S3InvoiceStorage |
这些包名表达的是外部技术能力,而不是业务层次。业务含义仍由它实现的端口体现,例如 JpaOrderRepository 实现领域层的 OrderRepository。
让实现类对齐端口,而不是对齐框架
Infrastructure 的类最好能回答一个明确问题:“我在实现哪个端口?”如果回答不了,通常说明它只是技术工具类,或者职责还没有拆清。
下面是片段示例,依赖领域层已经声明的 OrderRepository 端口。JPA 实体和 Spring Data Repository 都被限制在 persistence 内部,应用层只看到领域接口。
package com.example.order.infrastructure.persistence;

import java.util.Optional;

public final class JpaOrderRepositoryAdapter implements OrderRepository {

    private final SpringDataOrderRepository repository;
    private final OrderPersistenceMapper mapper;

    public JpaOrderRepositoryAdapter(
            SpringDataOrderRepository repository,
            OrderPersistenceMapper mapper) {
        this.repository = repository;
        this.mapper = mapper;
    }

    @Override
    public Optional<Order> findById(OrderId id) {
        return repository.findById(id.value()).map(mapper::toDomain);
    }

    @Override
    public void save(Order order) {
        // 领域对象与持久化实体之间的转换停留在 persistence 边界内。
        repository.save(mapper.toEntity(order));
    }
}
验证边界时,搜索应用层和领域层是否直接导入 JpaRepository、Kafka 客户端或第三方 SDK。若这些依赖只出现在 Infrastructure 内部,并且外层通过端口访问它们,说明依赖方向是正确的。
二级包内部再按职责细分
当某个二级包继续变大时,再增加第三级职责边界,而不是把所有类平铺。例如 persistence 可以继续拆成 entity、repository、mapper;messaging 可以拆成 publisher、consumer、config;client 可以按外部系统拆成 payment、shipping。
关键是“先按变化原因拆,再按实现职责拆”。不要一开始就建立很多空目录,也不要把所有框架配置统一扔进 config。某个配置只服务 Kafka,就放在 messaging 边界内;只服务 JPA,就留在 persistence 边界内。这样删除某种技术实现时,可以连同对应目录整体移除。
警惕三个膨胀信号
第一种信号是出现巨大的 util、common、helper。这些名字没有业务或技术边界,任何代码都能被塞进去。第二种信号是一个 config 包同时包含数据库、MQ、Redis 和第三方客户端配置,说明技术能力又被重新混在一起。第三种信号是 Infrastructure 直接定义业务决策,例如在仓储实现里判断“订单是否允许取消”,这会让领域规则被技术代码绑架。
用可替换性检查目录是否健康
一个健康的 Infrastructure 目录应该允许你相对独立地替换某项技术:把 JPA 换成 MyBatis,主要修改 persistence;把 Kafka 换成 RabbitMQ,主要修改 messaging;切换支付供应商,主要修改 client.payment。如果一次技术替换需要横跨多个不相关目录修改大量类,说明边界划分仍然混杂。
Infrastructure 不需要追求“包越多越专业”。真正有效的结构,是让每个目录都有单一变化原因,并且能沿着端口快速找到实现。按 persistence、messaging、client 等能力建立二级边界,再在内部做适度细分,就能让基础设施随着项目增长而扩展,而不是无限堆积。