
架构与系统设计 / 系统课时
Repository 接口应该放在哪一层
Repository 接口应该放在哪一层
Repository 的关键不是名字,而是依赖方向。为了让领域模型不依赖数据库,仓储接口通常放在领域层附近,由领域语义定义契约;真正访问数据库的实现类放在基础设施层,并通过依赖注入提供给应用层使用。
学习目标
- 理解 Repository 接口为什么通常由领域侧定义
- 正确放置领域接口、应用服务与数据库实现
- 识别“领域层反向依赖基础设施层”的错误结构
先看依赖方向
一个常见的分层关系是:应用层编排用例,领域层提供聚合和仓储契约,基础设施层实现这个契约。运行时虽然是基础设施对象被调用,但源码依赖方向仍然可以指向领域抽象。
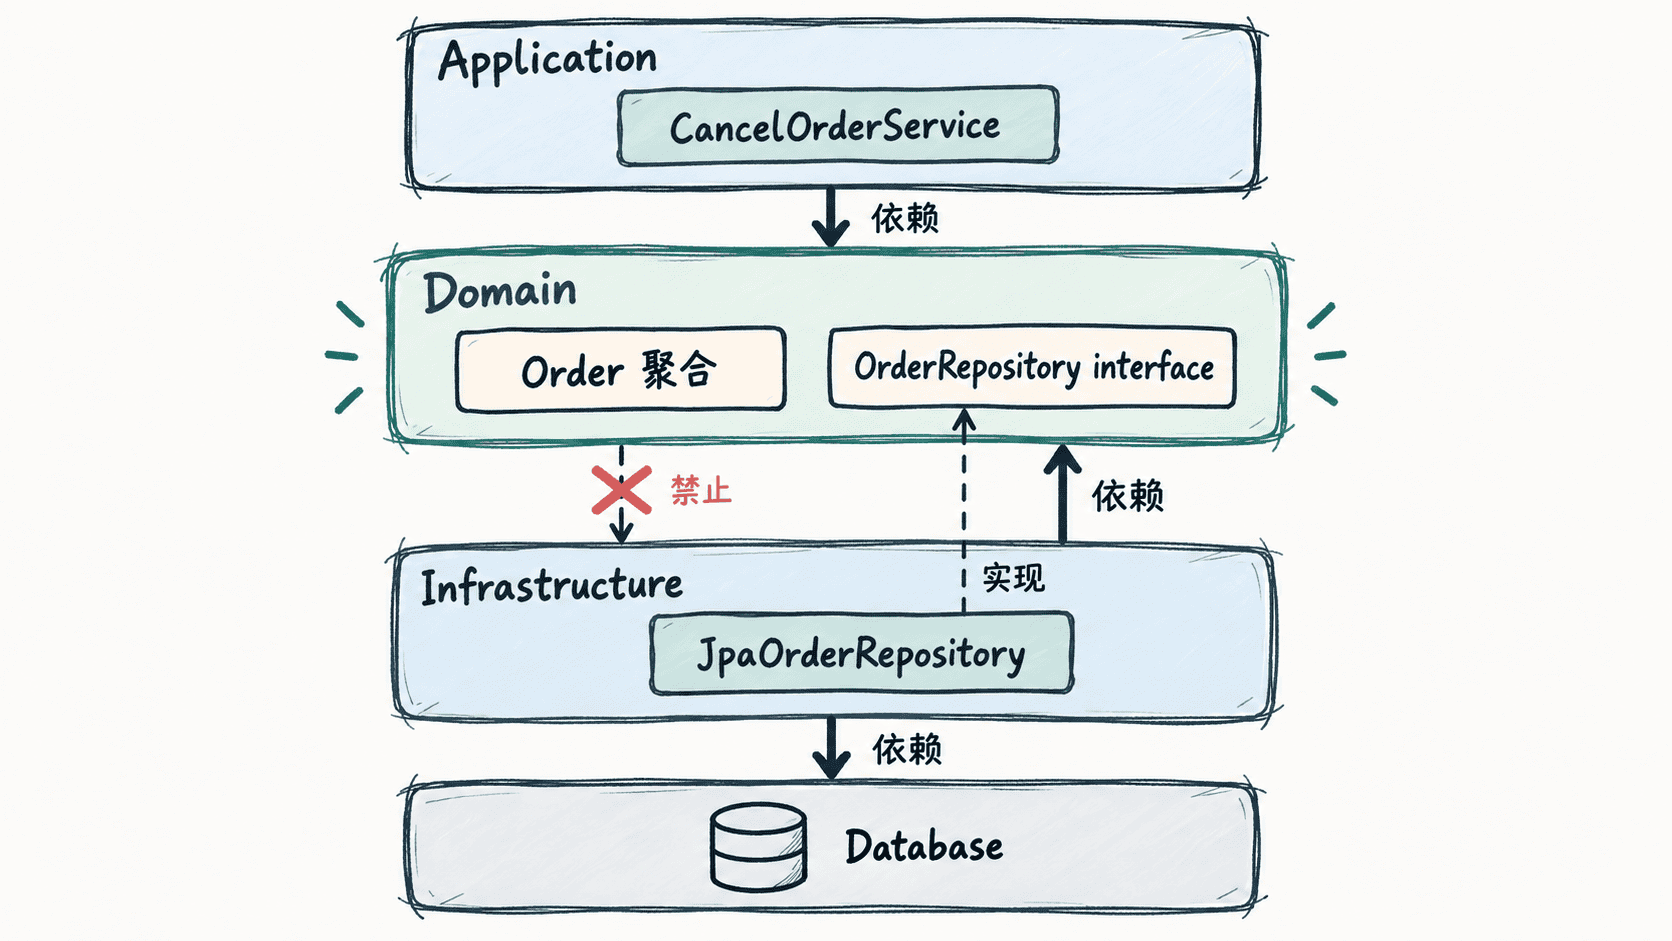
如果把 OrderRepository 接口直接定义在基础设施层,领域或应用代码为了调用仓储就必须 import 基础设施包。这样一来,数据库适配层反而成为上层业务代码的编译时依赖,分层方向被倒置。
接口靠近领域模型
下面是片段示例,假设项目已经存在 Order 与 OrderId 聚合类型。仓储接口放在领域包中,只描述领域真正需要的操作。
package com.example.order.domain;

import java.util.Optional;

public interface OrderRepository {
    Optional<Order> findById(OrderId id);
    void save(Order order);
}
这段接口没有 JPA 的 EntityManager、Spring Data 的 JpaRepository、MyBatis 的 Mapper,也没有表名或 SQL。它因此可以被领域测试中的内存实现、生产环境中的数据库实现共同满足。
数据库实现留在基础设施层
下面也是片段示例,依赖上下文是:项目已经引入 JPA,并存在 OrderJpaEntity 与 OrderMapper。实现类可以自由使用基础设施技术,但它实现的仍是领域层定义的契约。
package com.example.order.infrastructure;

import com.example.order.domain.Order;
import com.example.order.domain.OrderId;
import com.example.order.domain.OrderRepository;
import jakarta.persistence.EntityManager;
import java.util.Optional;

public final class JpaOrderRepository implements OrderRepository {
    private final EntityManager entityManager;

    public JpaOrderRepository(EntityManager entityManager) {
        this.entityManager = entityManager;
    }

    @Override
    public Optional<Order> findById(OrderId id) {
        OrderJpaEntity entity = entityManager.find(OrderJpaEntity.class, id.value());
        return Optional.ofNullable(entity).map(OrderMapper::toDomain);
    }

    @Override
    public void save(Order order) {
        entityManager.merge(OrderMapper.toEntity(order));
    }
}
这里的 JPA 类型只存在于基础设施实现中。验证是否放对层,最直接的方法是检查领域模块的依赖:它应该能够在没有 JPA、数据库驱动和基础设施模块的情况下独立编译。
应用层负责使用,不负责实现
应用服务拿到的是 OrderRepository 抽象,而不是 JpaOrderRepository 具体类。对象组装通常由依赖注入容器或程序启动模块完成。
package com.example.order.application;

import com.example.order.domain.Order;
import com.example.order.domain.OrderId;
import com.example.order.domain.OrderRepository;

public final class CancelOrderService {
    private final OrderRepository repository;

    public CancelOrderService(OrderRepository repository) {
        this.repository = repository;
    }

    public void cancel(OrderId id) {
        Order order = repository.findById(id).orElseThrow();
        order.cancel();
        repository.save(order);
    }
}
这是片段示例,依赖上下文是领域层已经定义 Order、OrderId 和 OrderRepository。应用层只编排“加载聚合 → 执行业务行为 → 保存聚合”,不会直接编写 SQL,也不决定 ORM 如何落库。
用模块依赖检查边界
判断放置是否合理,可以把数据库技术全部拿掉做一次思想实验:如果领域模块仍能编译并运行纯领域测试,说明边界基本正确;如果删除 JPA 依赖后领域接口也无法编译,就说明持久化技术已经泄漏进领域层。
实际项目中也有变体,例如将 Repository 接口放在应用层端口包中。关键不在于包名必须唯一正确,而在于高层业务规则定义自己需要的契约,低层基础设施去实现它。只要保持这条依赖规则,数据库技术就不会反向绑架领域模型。