
架构与系统设计 / 系统课时
Repository 到底抽象了什么
Repository 到底抽象了什么
Repository 解决的不是“把 SQL 藏起来”这么简单,而是让领域代码用聚合的语言表达持久化需求:按领域标识取得聚合、保存聚合,而数据库表、ORM 映射、查询语句和连接方式留给基础设施实现。
学习目标
- 说清 Repository 抽象的是聚合的获取与保存,而不是数据库表本身
- 区分 Repository 与 DAO、ORM Mapper 在职责上的差异
- 识别哪些持久化细节不应该进入领域代码
从领域代码看到的应该是聚合
以“订单”聚合为例,领域逻辑真正关心的是“取得某个订单并执行取消”,而不是“查询 orders 表,再查询 order_items 表,然后拼对象”。
import java.util.HashMap;
import java.util.Map;
import java.util.Optional;

public class RepositoryDemo {
    record OrderId(String value) {}

    static final class Order {
        private final OrderId id;
        private boolean cancelled;

        Order(OrderId id) {
            this.id = id;
        }

        void cancel() {
            this.cancelled = true;
        }

        @Override
        public String toString() {
            return id.value() + ":" + cancelled;
        }
    }

    interface OrderRepository {
        Optional<Order> findById(OrderId id);
        void save(Order order);
    }

    static final class InMemoryOrderRepository implements OrderRepository {
        private final Map<OrderId, Order> data = new HashMap<>();

        @Override
        public Optional<Order> findById(OrderId id) {
            return Optional.ofNullable(data.get(id));
        }

        @Override
        public void save(Order order) {
            data.put(order.id, order);
        }
    }

    public static void main(String[] args) {
        OrderRepository repository = new InMemoryOrderRepository();
        OrderId id = new OrderId("O-1001");
        repository.save(new Order(id));

        Order order = repository.findById(id).orElseThrow();
        order.cancel();
        repository.save(order);

        System.out.println(repository.findById(id).orElseThrow());
    }
}
预期输出:
O-1001:true这个示例没有任何 SQL,却已经完整表达了领域侧的持久化意图。将内存实现替换为 JPA、MyBatis 或原生 JDBC 后,调用 Repository 的领域或应用代码仍可以保持不变。
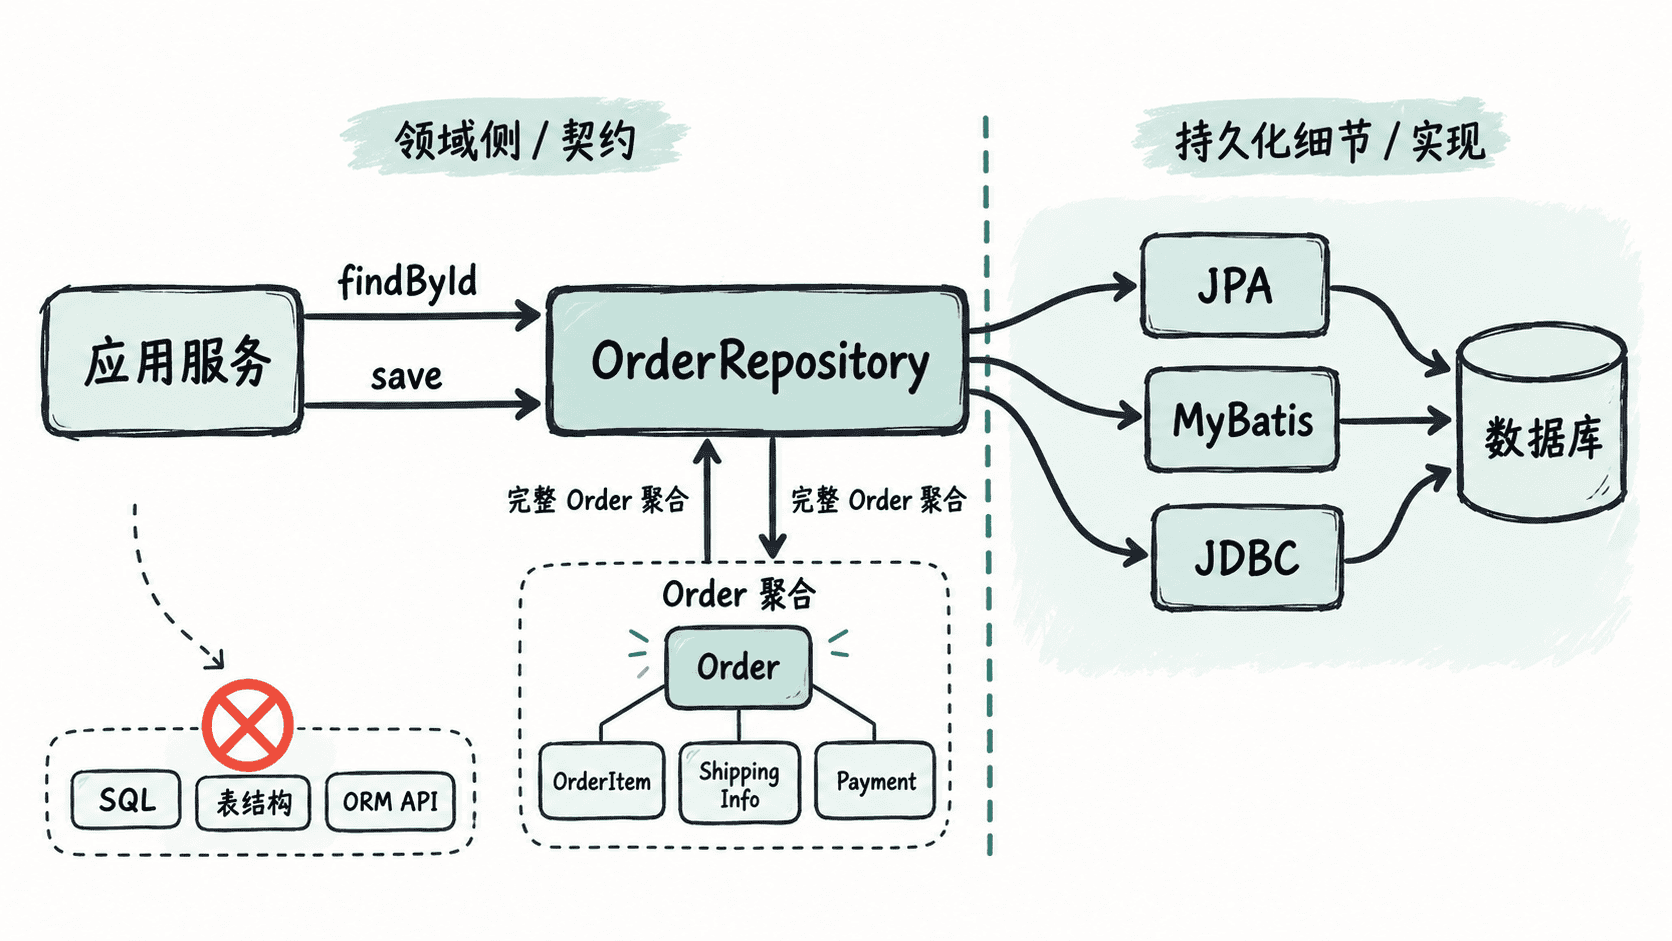
Repository 抽象的是持久化语义
Repository 通常围绕聚合根设计。它对外呈现的接口更像一个“聚合集合”:可以按领域标识取得对象,也可以保存对象状态。调用者不需要知道一个聚合最终拆成几张表、是否需要级联保存,或 ORM 如何维护关联。
这也是为什么 Repository 方法更适合使用领域概念命名。例如 findById、save、findUnpaidOrders 可以表达业务需要;而 selectOrderRow、updateOrderItemTable 已经泄漏了存储结构。
它和 DAO、Mapper 的关注点不同
| 对象 | 主要面向 | 常见返回值 | 是否允许暴露存储细节 |
|---|---|---|---|
| Repository | 聚合与领域语义 | 聚合根、领域对象 | 应尽量避免 |
| DAO | 数据访问操作 | 数据对象、记录 | 可以 |
| ORM Mapper | 对象与表映射 | 持久化对象 | 通常会接触表和映射配置 |
项目中三者可以同时存在。基础设施层内部完全可以使用 DAO 或 Mapper 完成查询,再把结果还原成聚合;真正需要隔离的是它们不要成为领域模型的直接依赖。
不要把 Repository 变成万能查询入口
Repository 不等于“所有数据库查询都放这里”。报表、列表页、统计查询往往只需要投影数据,如果为了复用 Repository 而强行加载完整聚合,会增加映射成本,也模糊聚合边界。
判断一个方法是否适合放进 Repository,可以先问两个问题:它是否围绕某个聚合根?调用者是否需要获得或保存该聚合的一致状态?如果答案都是否定的,更适合交给独立查询服务或读取模型。
Repository 的价值最终体现在依赖方向上:领域代码依赖的是“如何取得和保存聚合”的稳定契约,而 SQL、ORM、表结构和数据库产品都成为可以替换的实现细节。