
C / C++ / 系统课时
定位系统调用与锁竞争瓶颈
定位系统调用与锁竞争瓶颈
网络库压测出现 CPU 飙高或吞吐停滞时,不能只看“CPU 很忙”。本课用运行指标、perf 和 strace 建立一条可复现的定位链路,把热点区分为系统调用、内存分配、锁竞争和业务回调,并用证据决定下一步优化方向。
学习目标
- 能从 CPU、上下文切换和采样栈判断瓶颈大类。
- 能用
perf、strace验证系统调用与锁竞争热点。 - 能区分网络库自身开销和业务回调开销,避免误优化。
先把“CPU 高”拆成可验证假设
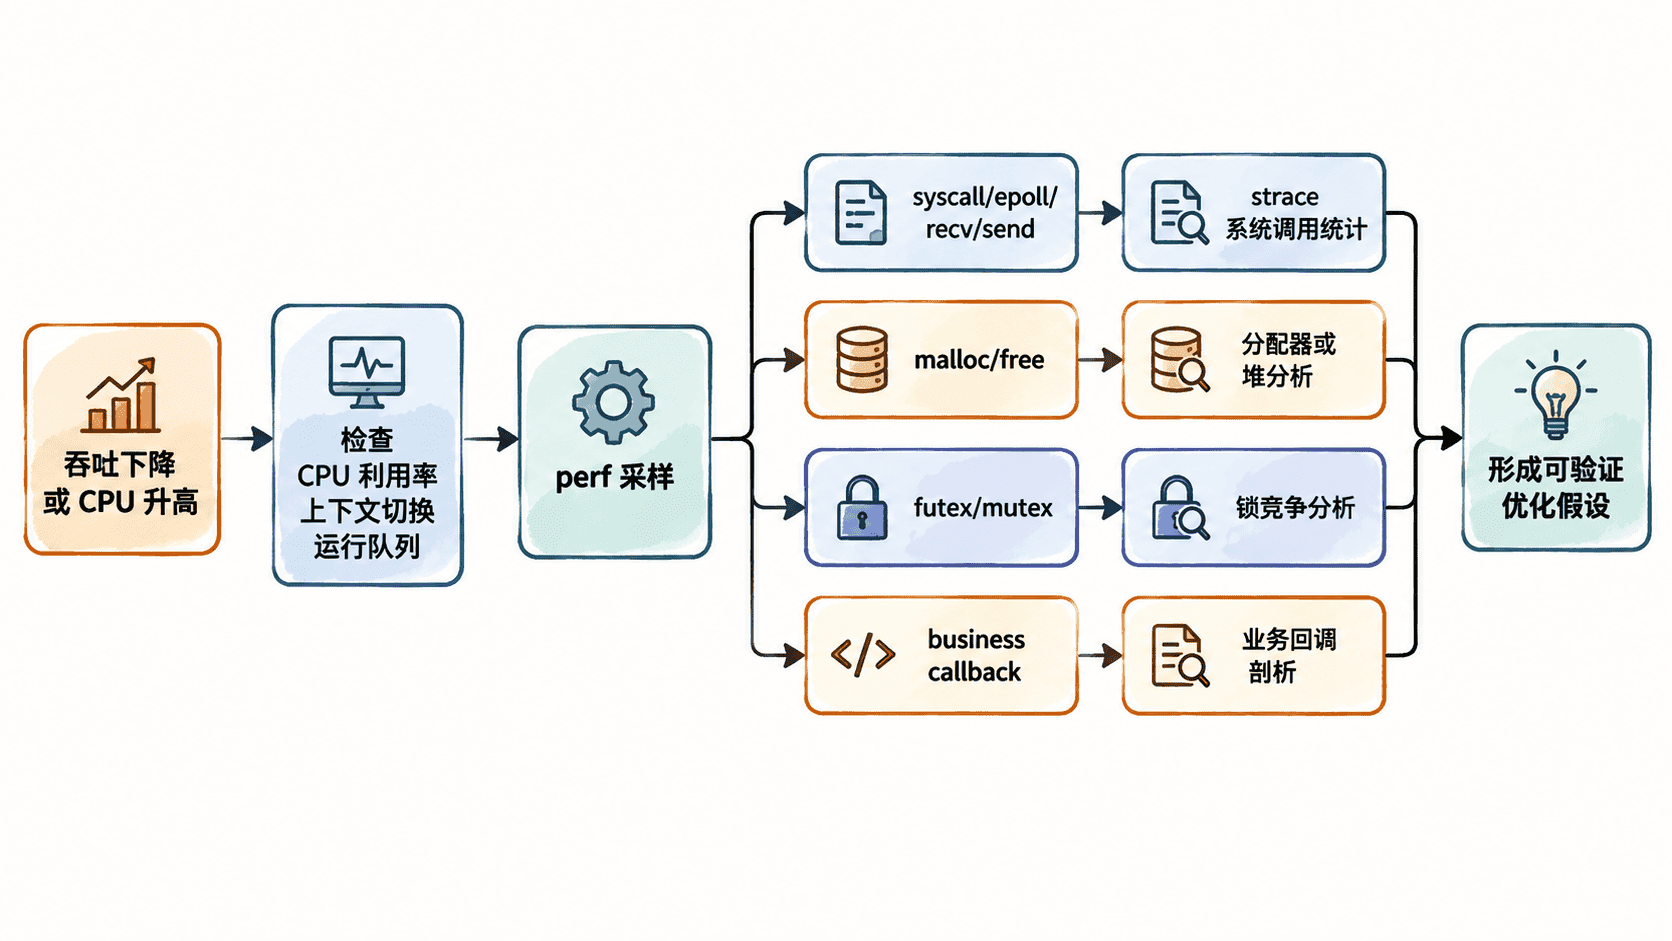
同样是 90% CPU,占用来源可能完全不同。epoll_wait、recv、send 等系统调用过密,通常意味着事件批处理不足或小包调用过多;futex 和互斥锁相关栈占比高,通常意味着多个线程争用共享状态;malloc、free 占比高,说明对象生命周期或缓冲区管理需要检查;业务回调函数持续占据火焰图顶部,则网络库本身未必是主因。
先固定压测条件:连接数、报文大小、请求速率、I/O 线程数和业务回调必须保持不变。否则每次采样面对的是不同工作负载,任何“优化前后对比”都没有可信度。
用基础指标判断该往哪里深挖
先记录线程级 CPU、上下文切换和缺页。下面命令只读取进程状态,不修改运行参数;将 <PID> 替换为服务进程 ID。
pidstat -p "<PID>" -t -u -w 1 5预期结果是连续五次得到线程 CPU 与上下文切换统计,字段名称会随 sysstat 版本略有差异,数值取决于实际负载。
Linux <VERSION> (<HOST>) <DATE>
<TIME> UID TGID TID %usr %system %CPU Command
<TIME> UID TGID TID cswch/s nvcswch/s Command
...
如果 %system 明显升高,应优先检查系统调用;如果 nvcswch/s 很高且多个 I/O 线程同时繁忙,要警惕锁竞争或线程数过多。若 %usr 高而系统调用不突出,则继续看采样栈中的分配器和业务函数。
用 perf 找到真正消耗 CPU 的调用栈
perf 的价值不是告诉你“哪个函数调用次数多”,而是统计 CPU 实际停留在哪里。先在稳定压测阶段采样 30 秒:
sudo perf record -F 99 -g -p "<PID>" -- sleep 30
sudo perf report --stdio --no-children | head -n 40
预期结果会按样本占比列出符号。若程序带调试符号且未剥离,可直接看到 C++ 函数名;否则可能出现地址或共享库符号。
Samples: <COUNT>  of event 'cycles'
Overhead  Command  Shared Object        Symbol
<XX.XX>%  server   <BINARY_OR_LIBRARY>  <SYMBOL>
...判断时看“成片出现的调用链”,不要盯单个函数。__libc_malloc、free 一起偏高,通常指向频繁分配;pthread_mutex_lock、futex 以及同一共享容器函数同时出现,才更像锁竞争;业务 handler 长时间居首,则应该先优化回调或把重任务移出 I/O 线程。
用 strace 和锁统计完成交叉验证
当 perf 指向系统调用后,再统计调用次数和耗时。strace -c 会汇总系统调用;附加到高负载生产进程会有额外开销,更适合短时采样或预发布压测环境。
sudo timeout 10s strace -f -c -p "<PID>"预期结果会在命令结束时输出系统调用汇总,具体调用项和占比取决于工作负载。
% time     seconds  usecs/call     calls    errors syscall
<...>      <...>    <...>          <...>    <...>  <SYSCALL>
...
如果实际汇总中 recvfrom、sendto 等读写调用次数远高于每秒业务请求数,检查是否每个小片段都立即读写、是否缺少聚合写或批量处理。若 futex 耗时突出,再把采样栈映射回具体互斥量保护的数据结构;只看到 futex 不能直接证明“锁有问题”,因为条件变量等待也会进入该系统调用。
Linux perf 支持的锁事件与子命令依内核和 perf 版本而异,可先检查当前环境:
perf lock --help >/dev/null 2>&1 && echo "perf lock available"预期输出:
perf lock available把热点归因到库还是业务
最后把一次请求路径切成三段:事件分发、网络读写与缓冲区管理、业务回调。相同压测下,用空回调或最小回调做一组基线;如果空回调时热点仍集中在网络库内部,才值得继续改 Reactor、缓冲区或锁设计。若替换为空回调后 CPU 明显下降,瓶颈就在业务层。
定位结果应能写成可验证陈述,例如“futex 占采样时间高,热点集中在连接表互斥锁,增加 I/O 线程后吞吐不升反降”。这种结论比“锁可能太多”更有价值,因为它同时给出了现象、证据和下一步实验方向。