
C / C++ / 系统课时
用请求 ID 关联异步响应
用请求 ID 关联异步响应
同一条 TCP 连接可以连续发送多个请求,而服务端处理耗时不同,响应未必按照请求发送顺序返回。要让客户端在乱序响应下仍找到正确等待者,需要在协议中加入唯一请求 ID,并维护“请求 ID → 回调或 Promise”的关联表。
学习目标
- 理解为什么发送顺序不能可靠匹配并发请求与响应
- 能设计请求 ID 字段并维护 pending 请求表
- 掌握正常响应、超时、迟到响应和连接断开时的清理原则
乱序响应为什么会配错
假设客户端依次发送请求 A、B、C。服务端如果并行处理,而 B 最快、A 最慢,响应顺序就可能变成 B、C、A。客户端若简单采用“第一个响应属于第一个请求”的规则,结果会立即串单。
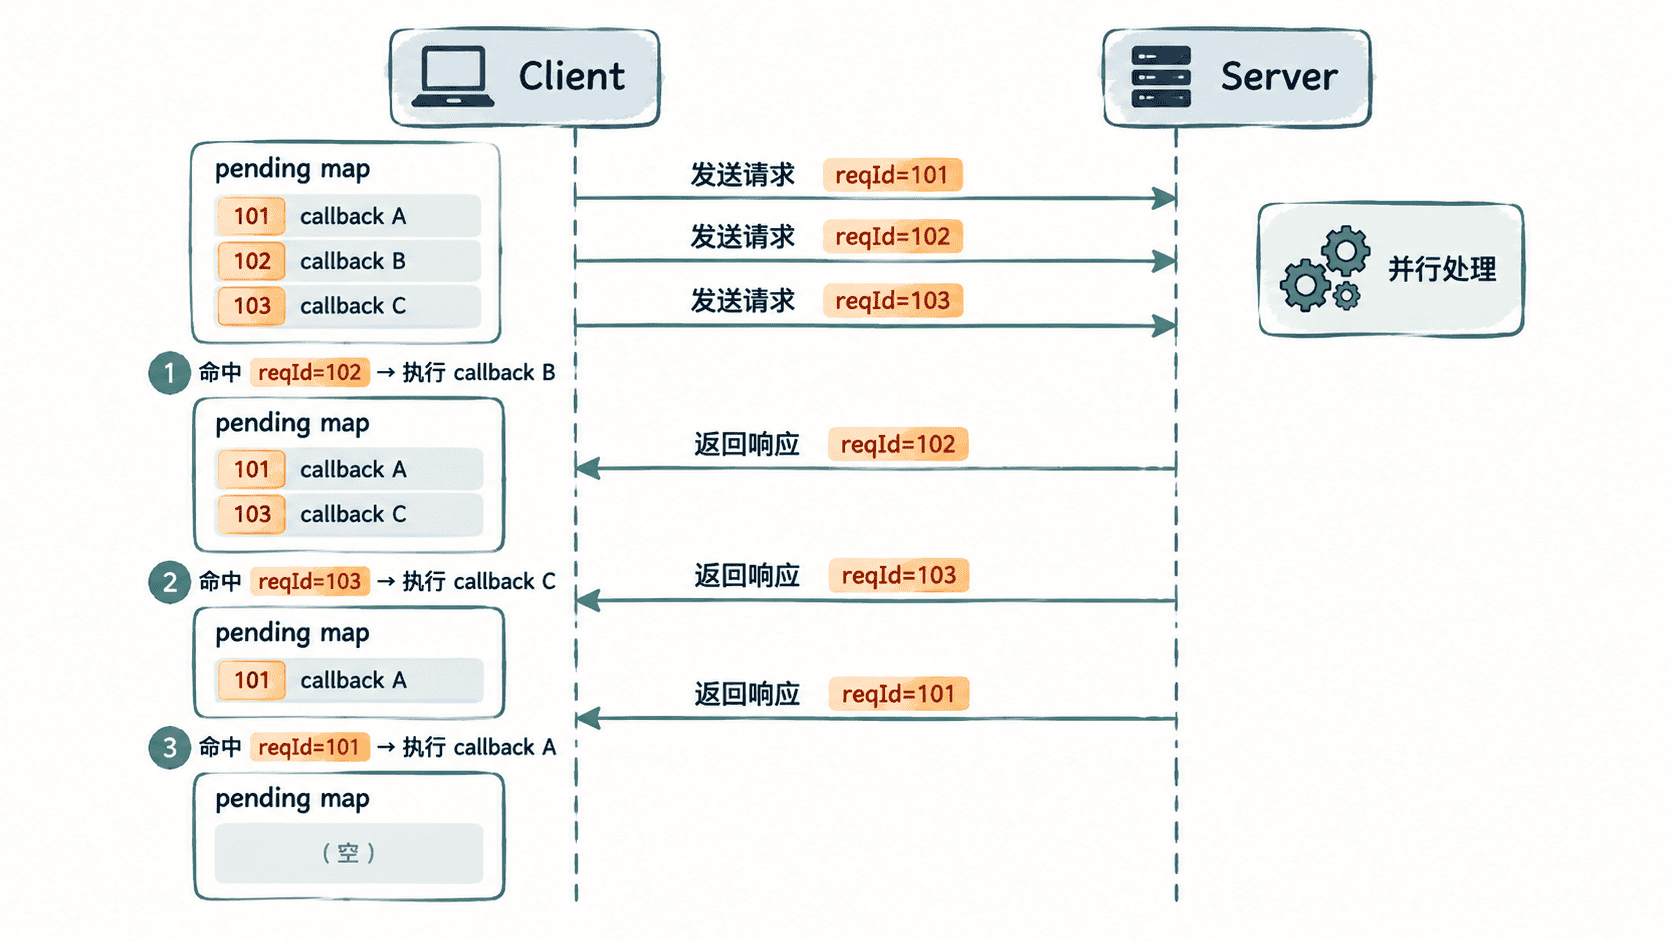
解决办法是在请求中携带唯一 ID,并要求服务端在响应中原样返回。客户端收到响应后不再依赖到达顺序,而是按照响应携带的 ID 查询本地等待表。
请求 ID 应该放在哪里
请求 ID 至少需要在当前可并发窗口内唯一。单进程客户端常用单调递增的 64 位整数;跨进程或跨节点生成时也可以使用雪花 ID、UUID 等方案,但如果 ID 只用于单条连接内部关联,就没有必要追求全局唯一。
协议可以抽象为下面的数据结构:
request:
  request_id: uint64
  method: string
  payload: bytes

response:
  request_id: uint64
  status: uint32
  payload: bytes
这是协议结构片段,不是独立可执行程序。真正的约束有两个:请求发送前必须确定 request_id,服务端生成响应时必须把同一个 ID 原样带回。联调时可以连续发送多个不同 ID 的请求,并检查每个响应是否保留对应 ID。
用 pending 表完成精确匹配
下面的可运行示例用三个请求模拟异步调用,再故意按照 B、C、A 的顺序交付响应。真实网络库中,注册请求之后会把数据交给 Codec 和 TcpConnection 发送,而 onResponse() 通常在 Codec 解出完整响应后被调用。
#include <cstdint>
#include <functional>
#include <iostream>
#include <stdexcept>
#include <string>
#include <unordered_map>
#include <utility>

struct Response {
    std::uint64_t requestId;
    std::string payload;
};

class RequestTracker {
public:
    using Callback = std::function<void(const Response&)>;

    std::uint64_t add(Callback callback) {
        const std::uint64_t id = nextId_++;
        pending_.emplace(id, std::move(callback));
        return id;
    }

    void onResponse(const Response& response) {
        auto it = pending_.find(response.requestId);
        if (it == pending_.end()) {
            throw std::runtime_error("unknown or duplicate request id");
        }

        // 先从 pending 表删除,再执行用户回调,避免重入导致同一请求完成两次。
        auto callback = std::move(it->second);
        pending_.erase(it);
        callback(response);
    }

    std::size_t pendingCount() const {
        return pending_.size();
    }

private:
    std::uint64_t nextId_ = 1;
    std::unordered_map<std::uint64_t, Callback> pending_;
};

int main() {
    RequestTracker tracker;

    const auto a = tracker.add([](const Response& response) {
        std::cout << "A <- " << response.payload << std::endl;
    });
    const auto b = tracker.add([](const Response& response) {
        std::cout << "B <- " << response.payload << std::endl;
    });
    const auto c = tracker.add([](const Response& response) {
        std::cout << "C <- " << response.payload << std::endl;
    });

    // 故意乱序返回,验证匹配依据是 requestId,而不是响应到达次序。
    tracker.onResponse({b, "resp-B"});
    tracker.onResponse({c, "resp-C"});
    tracker.onResponse({a, "resp-A"});

    std::cout << "pending=" << tracker.pendingCount() << std::endl;
}
预期输出:
B <- resp-B
C <- resp-C
A <- resp-A
pending=0
关键并不是输出必须恢复成 A、B、C,而是每个响应都由自己的 requestId 命中正确回调。请求完成后立即从 pending 表删除,可以释放回调对象,也能让重复响应暴露为异常或迟到消息。
超时和断线同样要结束请求
如果只处理正常响应,服务端长期不返回时 pending 表会不断增长。因此每个请求都应关联截止时间。超时发生后,需要删除对应 ID,并以超时错误完成 Promise 或回调,不能继续让调用方无限等待。
连接断开时,则应一次性失败该连接上的全部 pending 请求,因为这些响应已经不可能从原连接返回。若上层需要自动重试,应由请求生命周期层重新创建一次调用,而不是保留旧 pending 项等待奇迹发生。
64 位单调 ID 在实际系统中几乎不会自然回绕,但分配器仍应保证新 ID 当前不存在于 pending 表。如果网络库采用多线程发送,还必须让 ID 分配和 pending 表访问具备明确的线程归属或同步机制。
与 Codec 组合后的调用链
发送请求时,RPC 客户端先分配请求 ID,把回调登记进 pending 表,再把 ID、方法和参数交给 Codec 编码,最终由 TcpConnection 发送字节。接收响应时,连接层提供字节,Codec 解出响应对象,RPC 客户端读取 request_id 并完成对应等待者。
这样三个层次各自只解决一个问题:TcpConnection 搬运字节,Codec 把字节还原成带请求 ID 的消息,RPC 客户端管理请求生命周期与关联关系。即使服务端并行执行、响应完全乱序,只要 ID 唯一且生命周期清理正确,同一连接上的多个异步请求仍能可靠匹配。