
C / C++ / 系统课时
用心跳发现失效连接
用心跳发现失效连接
本节解决“TCP 看起来还连着,但对端其实已经失效”的问题。我们会设计应用层心跳、记录最近一次有效活动时间,并用超时扫描决定何时关闭连接。这样即使没有收到 FIN 或 RST,也能在可控时间内识别断网、进程假死或中间设备静默丢链路的情况。
学习目标
- 区分 TCP 连接存在与应用对端仍然存活这两个概念
- 设计心跳间隔、超时时间和最近活动时间的更新规则
- 用单调时钟实现可验证的失效连接判定
为什么仅靠 TCP 状态不够
TCP 只有在收到关闭、复位,或本机发送数据并最终重传失败时,才能确认部分异常。对端突然断电、网络黑洞、NAT 映射失效时,如果本端长期没有数据发送,socket 可能仍然保持 ESTABLISHED。因此网络库需要应用层活性检测,而不是把“连接对象还在”当成“对端健康”。
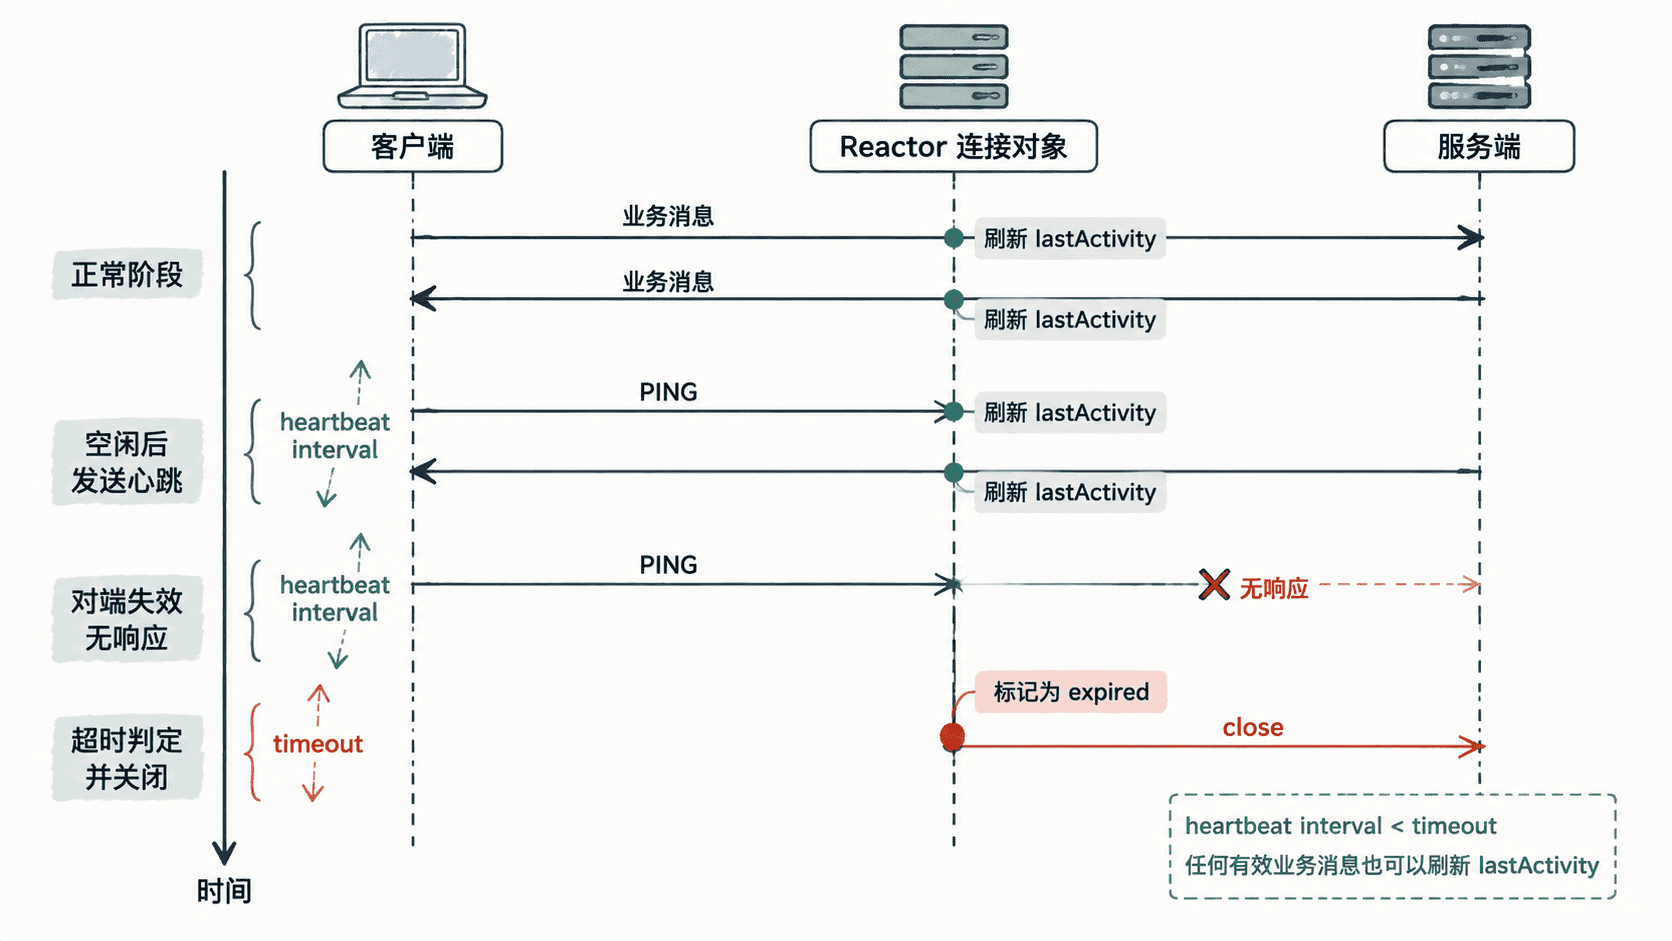
应用层心跳通常包含三个动作:空闲一段时间后发送 ping;收到任何有效业务消息或 pong 时刷新最后活动时间;超过失效阈值仍无活动时主动关闭连接。这里必须使用 std::chrono::steady_clock 一类单调时钟,避免系统时间被校准后让超时判断跳变。
用最近活动时间做判定
下面的程序模拟一个连接状态。onActivity 代表收到业务数据或 pong,shouldSendPing 判断是否进入心跳发送点,expired 判断是否应关闭连接。示例用整数秒推进模拟时间,核心逻辑与真实事件循环中的定时器回调一致。
#include <chrono>
#include <iostream>

class HeartbeatState {
public:
    using Clock = std::chrono::steady_clock;
    using TimePoint = Clock::time_point;
    using Seconds = std::chrono::seconds;

    HeartbeatState(Seconds interval, Seconds timeout, TimePoint now)
        : interval_(interval), timeout_(timeout),
          lastActivity_(now), lastPing_(now) {}

    void onActivity(TimePoint now) {
        lastActivity_ = now;
    }

    bool shouldSendPing(TimePoint now) {
        if (now - lastActivity_ < interval_) return false;
        if (now - lastPing_ < interval_) return false;
        lastPing_ = now;
        return true;
    }

    bool expired(TimePoint now) const {
        return now - lastActivity_ >= timeout_;
    }

private:
    Seconds interval_;
    Seconds timeout_;
    TimePoint lastActivity_;
    TimePoint lastPing_;
};

int main() {
    using namespace std::chrono;
    const auto t0 = steady_clock::time_point{};

    HeartbeatState state(5s, 12s, t0);

    std::cout << std::boolalpha;
    std::cout << "t=5 ping=" << state.shouldSendPing(t0 + 5s)
              << " expired=" << state.expired(t0 + 5s) << '\n';

    state.onActivity(t0 + 6s); // 收到 PONG 或业务数据,刷新活性时间

    std::cout << "t=10 ping=" << state.shouldSendPing(t0 + 10s)
              << " expired=" << state.expired(t0 + 10s) << '\n';
    std::cout << "t=11 ping=" << state.shouldSendPing(t0 + 11s)
              << " expired=" << state.expired(t0 + 11s) << '\n';
    std::cout << "t=18 expired=" << state.expired(t0 + 18s) << '\n';
}
预期输出:
t=5 ping=true expired=false
t=10 ping=false expired=false
t=11 ping=true expired=false
t=18 expired=true
这个实现有两个关键点。第一,心跳发送时间与失效判定时间分开记录,不能把“我刚发过 ping”误当成“对端刚活跃过”;第二,业务消息本身就是最强的活性证据,因此不必要求只有 pong 才刷新 lastActivity。
参数要避免误杀和发现过慢
心跳间隔越短,发现故障越快,但会产生更多定时器、包量和唤醒;超时时间越短,回收连接越积极,也越容易把短暂网络抖动误判为失效。工程上应满足“超时时间明显大于心跳间隔”,让至少一次或多次心跳有机会得到响应。
例如间隔 10 秒、超时 30 秒,意味着空闲连接大约每 10 秒探测一次,连续较长时间没有任何有效活动才会关闭。不要把这组数字直接照搬到所有系统:移动网络、跨地域链路和机房内 RPC 的抖动特征不同,应根据延迟分位数和容错目标调整。
关闭之前还要处理并发竞态
超时扫描与读事件可能几乎同时发生:扫描线程刚判断连接过期,事件循环又收到一个业务包。网络库应保证连接状态变化在所属事件循环线程中串行执行,或通过原子状态把 ACTIVE 到 CLOSING 的转换做成一次性操作,避免重复关闭、重复回调和悬空引用。
生产环境还应记录心跳超时次数、超时关闭连接数、pong 往返时间和误判投诉。只有当“失效连接能及时回收”和“正常慢链路不会被频繁误杀”同时成立,心跳机制才算可靠。