
C / C++ / 系统课时
复用连接承载并发 RPC
复用连接承载并发 RPC
一个 TCP 连接完全可以同时承载多个尚未完成的 RPC。关键不是“多开线程”,而是让每个请求都带唯一请求 ID,并在客户端维护 requestId -> 等待结果 的映射。这样响应即使乱序到达,也能准确唤醒对应调用,省掉频繁建连成本。
学习目标
- 说明连接复用下为什么必须使用请求 ID 做响应关联
- 实现一个支持多个未完成调用的待完成表
- 正确处理乱序响应、未知请求 ID 与上下文清理
连接复用改变了什么
每次 RPC 都重新建立 TCP 连接时,请求和连接天然是一一对应的;复用连接后,这个关系消失了。同一个 socket 上可能连续写出请求 101、102、103,而服务端因为处理耗时不同,可能按 102、103、101 的顺序返回。
因此,消息头至少要携带一个在当前客户端连接内唯一的 requestId。发送前创建等待上下文并放入待完成表;收到响应后先解码请求 ID,再从表中找到对应上下文,写入结果并删除。
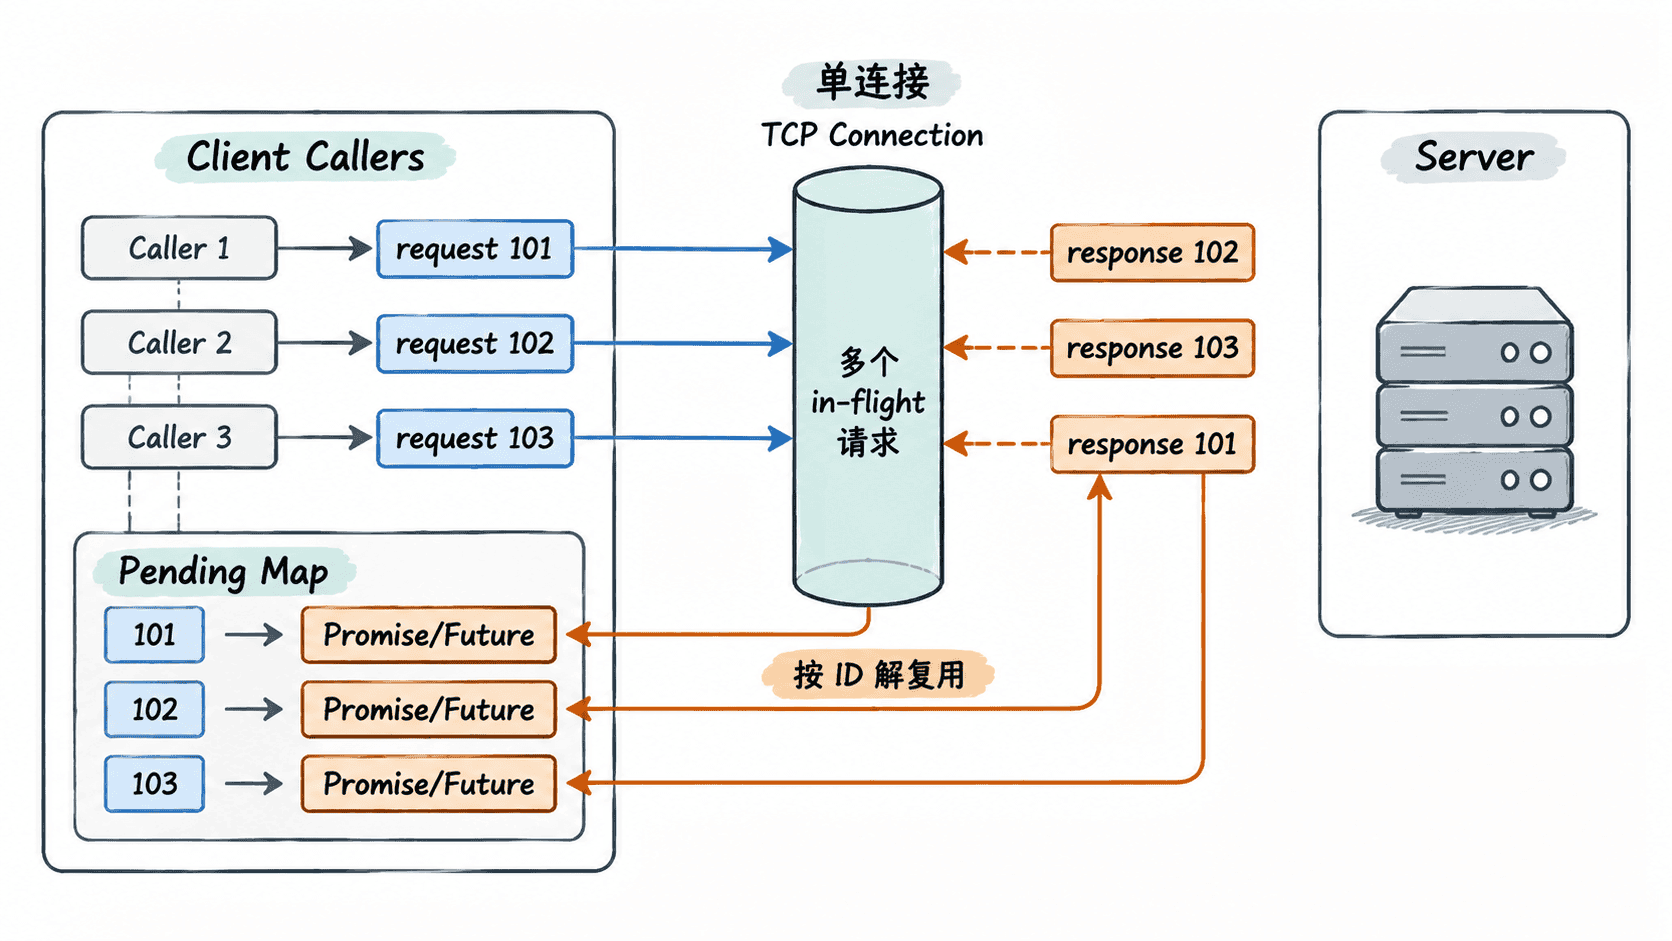
这个表的存在意味着“一个连接只能串行等待一个响应”不再成立。连接负责传输字节流,请求 ID 负责逻辑上的多路复用,两者职责要分开。
用待完成表关联响应
下面的示例省略真实 socket 与编解码,只保留 RPC 多路复用最核心的部分。startCall 在发送前登记 Promise,onResponse 模拟网络线程解码出响应后的分发动作。
#include <atomic>
#include <future>
#include <iostream>
#include <mutex>
#include <optional>
#include <string>
#include <unordered_map>
#include <utility>

class RpcClient {
public:
    struct Call {
        uint64_t requestId;
        std::future<std::string> future;
    };

    Call startCall() {
        const uint64_t id = nextId_.fetch_add(1, std::memory_order_relaxed);
        std::promise<std::string> promise;
        auto future = promise.get_future();

        {
            std::lock_guard<std::mutex> lock(mu_);
            // 必须先登记再发送,避免极快响应先于上下文进入待完成表。
            pending_.emplace(id, std::move(promise));
        }
        return {id, std::move(future)};
    }

    bool onResponse(uint64_t requestId, std::string payload) {
        std::optional<std::promise<std::string>> promise;
        {
            std::lock_guard<std::mutex> lock(mu_);
            auto it = pending_.find(requestId);
            if (it == pending_.end()) {
                return false;
            }
            // 删除操作决定该响应只会完成一次,后续重复包会被忽略。
            promise.emplace(std::move(it->second));
            pending_.erase(it);
        }

        promise->set_value(std::move(payload));
        return true;
    }

    std::size_t pendingCount() const {
        std::lock_guard<std::mutex> lock(mu_);
        return pending_.size();
    }

private:
    std::atomic<uint64_t> nextId_{1};
    mutable std::mutex mu_;
    std::unordered_map<uint64_t, std::promise<std::string>> pending_;
};

int main() {
    RpcClient client;

    auto a = client.startCall();
    auto b = client.startCall();
    auto c = client.startCall();

    std::cout << "pending=" << client.pendingCount() << "\n";

    // 故意按 2、3、1 的顺序交付响应,验证响应顺序不影响调用归属。
    client.onResponse(b.requestId, "B");
    client.onResponse(c.requestId, "C");
    client.onResponse(a.requestId, "A");

    std::cout << "a=" << a.future.get() << "\n";
    std::cout << "b=" << b.future.get() << "\n";
    std::cout << "c=" << c.future.get() << "\n";
    std::cout << "pending=" << client.pendingCount() << "\n";
}
预期输出:
pending=3
a=A
b=B
c=C
pending=0
真实网络库里,发送路径还应把 requestId 编入协议帧,接收路径则在完成拆包后调用类似 onResponse 的分发函数。只要请求 ID 与待完成表保持一致,服务端是否并行执行、响应是否乱序,都不会破坏调用结果。
并发边界要守住
待完成表会同时被业务线程、网络事件循环甚至超时线程访问,因此必须明确并发策略。最简单的是像示例一样加互斥锁;如果所有增删操作都投递到同一个 Reactor 线程,也可以让表本身保持线程内访问,再通过任务队列跨线程提交操作。
请求 ID 不能在仍存在未完成调用时重复使用。实际实现通常使用 64 位递增值;即使发生整数回绕,也必须确认新 ID 不在待完成表中。连接断开时,还要一次性摘出全部待完成上下文并以“连接关闭”失败完成,否则调用方会永久等待。
什么时候复用才真正生效
仅仅保持 TCP 长连接还不等于并发 RPC。如果客户端发送一个请求后立即阻塞等响应,再发送下一个请求,连接仍然是串行的。真正的复用要求允许多个请求同时处于 in-flight 状态,并由请求 ID 完成解复用。
当待完成表能正确处理登记、乱序响应、重复响应、断连清理后,单连接就具备了承载并发 RPC 的基础。后续增加超时和主动取消时,也应继续围绕同一份调用上下文做“谁先完成谁负责删除”的状态管理。