
C / C++ / 系统课时
暴露延迟吞吐与错误指标
暴露延迟吞吐与错误指标
这一节把网络库里“感觉有点慢”变成可量化的问题:为连接、流量、请求、延迟和错误建立统一指标,并通过一个最小 C++ 示例演示计数器与延迟直方图的采集方法,最终能用同一组数据判断容量、定位异常并验证优化效果。
学习目标
- 区分连接数、吞吐、延迟和错误指标各自回答的问题
- 为 Reactor/RPC 请求路径选择合适的计数器、Gauge 与直方图
- 设计低基数标签,并用采样结果验证指标是否可信
先定义真正有用的指标
指标不是越多越好,而是要能回答“系统现在承受多少压力、处理得多快、哪里在失败”。网络库至少应覆盖四组信号。
连接类指标关注当前负载与连接生命周期,例如当前活跃连接数 connections_active、累计接受连接数 connections_accepted_total。字节类指标用累计计数器记录 bytes_in_total 与 bytes_out_total,通过单位时间增量计算网络吞吐。
请求类指标用 requests_total 统计完成请求数,再按时间窗口求每秒请求数。错误不要只做一个总数,应至少区分超时、协议错误、对端关闭、业务错误等有限类别,否则总错误率升高时仍然无法定位。
延迟应记录分布,而不是只记平均值。平均值会掩盖尾延迟;RPC 更应该观察 P50、P95、P99 或直方图桶,尤其是在排查偶发抖动时。
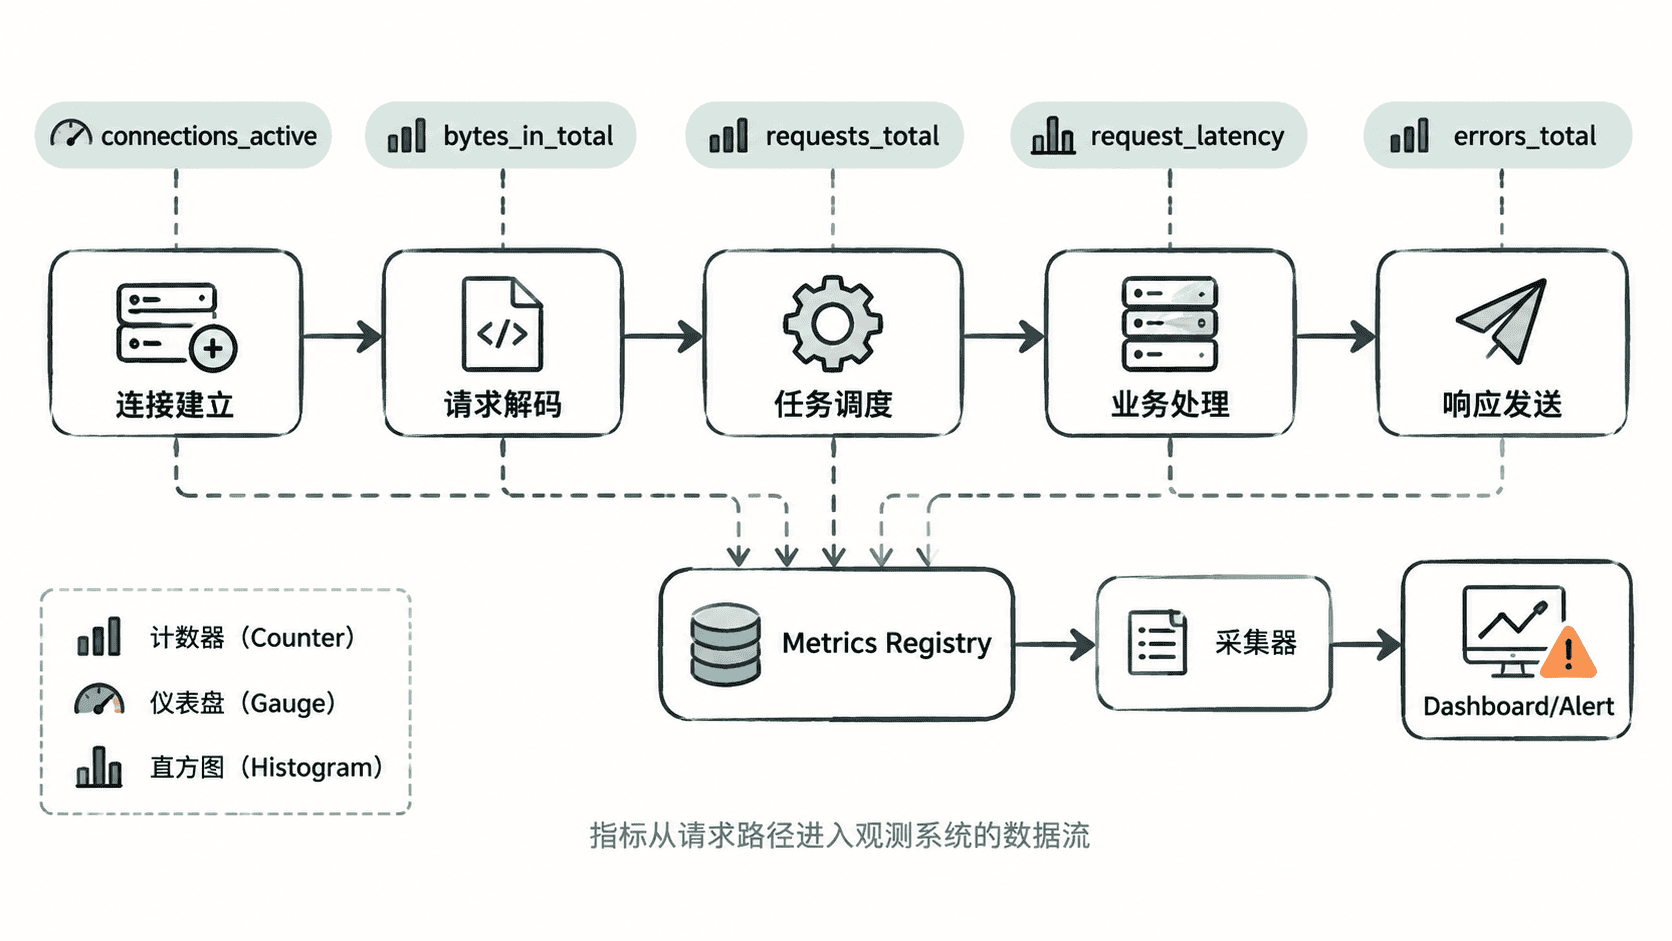
在请求路径中埋点
下面示例不依赖第三方监控库,重点展示埋点位置与数据结构。生产环境通常会把这些值接入 Prometheus、OpenTelemetry 或内部指标系统,但采集时机基本一致。
#include <atomic>
#include <chrono>
#include <cstdint>
#include <iostream>
#include <mutex>
#include <vector>

class Metrics {
public:
    void onConnectionOpen() {
        activeConnections.fetch_add(1, std::memory_order_relaxed);
        acceptedConnections.fetch_add(1, std::memory_order_relaxed);
    }

    void onConnectionClose() {
        activeConnections.fetch_sub(1, std::memory_order_relaxed);
    }

    void onRequest(std::uint64_t bytesIn, std::uint64_t bytesOut,
                   std::chrono::microseconds latency, bool timeout) {
        requests.fetch_add(1, std::memory_order_relaxed);
        inputBytes.fetch_add(bytesIn, std::memory_order_relaxed);
        outputBytes.fetch_add(bytesOut, std::memory_order_relaxed);
        if (timeout) {
            timeoutErrors.fetch_add(1, std::memory_order_relaxed);
        }

        // 延迟样本需要保留分布信息;示例用 vector,生产中应改成直方图或分桶聚合。
        std::lock_guard<std::mutex> lock(latencyMutex);
        latenciesUs.push_back(latency.count());
    }

    void printSnapshot() const {
        std::cout << "connections_active=" << activeConnections.load() << '\n';
        std::cout << "connections_accepted_total=" << acceptedConnections.load() << '\n';
        std::cout << "requests_total=" << requests.load() << '\n';
        std::cout << "bytes_in_total=" << inputBytes.load() << '\n';
        std::cout << "bytes_out_total=" << outputBytes.load() << '\n';
        std::cout << "timeout_errors_total=" << timeoutErrors.load() << '\n';
    }

private:
    std::atomic<std::uint64_t> activeConnections{0};
    std::atomic<std::uint64_t> acceptedConnections{0};
    std::atomic<std::uint64_t> requests{0};
    std::atomic<std::uint64_t> inputBytes{0};
    std::atomic<std::uint64_t> outputBytes{0};
    std::atomic<std::uint64_t> timeoutErrors{0};
    mutable std::mutex latencyMutex;
    std::vector<std::int64_t> latenciesUs;
};

int main() {
    Metrics metrics;
    metrics.onConnectionOpen();

    auto start = std::chrono::steady_clock::now();
    // 模拟一次完成的 RPC;真实代码应在解码完成到响应写回之间计时。
    auto end = start + std::chrono::microseconds(850);
    metrics.onRequest(128, 256,
                      std::chrono::duration_cast<std::chrono::microseconds>(end - start),
                      false);

    metrics.printSnapshot();
    metrics.onConnectionClose();
    return 0;
}
预期输出:
connections_active=1
connections_accepted_total=1
requests_total=1
bytes_in_total=128
bytes_out_total=256
timeout_errors_total=0
这个示例里,活跃连接数属于 Gauge,累计连接、字节、请求和错误都属于只增不减的 Counter。延迟则需要直方图或摘要结构,不能简单替换成一个“当前延迟”。
从原始值推导容量信号
累计计数本身通常用于计算速率。例如两次采样间 requests_total 从 120000 增长到 123000,间隔 30 秒,那么吞吐约为每秒 100 个请求。字节计数同理,可以得到入口和出口带宽。
延迟应和吞吐一起观察。吞吐持续上升而 P99 延迟突然陡增,常见原因不是“网络变慢”这么简单,而可能是事件循环拥塞、工作线程池排队、下游服务变慢或连接写缓冲积压。
错误率也必须有分母。某分钟出现 100 次超时,如果同期只有 500 个请求非常严重;如果同期有 100 万请求,则需要结合基线再判断。常见计算是 timeout_errors_total 的增量除以 requests_total 的增量。
验证指标是否可信
上线前不要只看“指标能显示”。应制造一组可预测行为:建立固定数量连接、发送固定请求数、刻意触发一次超时,再核对连接 Gauge、请求 Counter、字节量和错误分类是否同时符合预期。
还要检查重复计数与遗漏计数。最常见的错误是异常路径提前返回,导致请求总数增加了但延迟没记录,或者连接关闭回调执行两次,使活跃连接数出现负值。将埋点放在生命周期边界,并保证每个开始事件只有一个对应结束事件,指标才足以支撑容量判断和线上定位。