
C / C++ / 系统课时
用结构化日志追踪请求链路
用结构化日志追踪请求链路
这一节解决“日志很多却还原不了一次 RPC”的问题:统一连接 ID、请求 ID、阶段名和结果字段,让接入、解码、调度、执行、响应这些分散在不同线程中的日志能重新拼成一条链路,并用一个可运行的 C++ 示例验证字段设计。
学习目标
- 设计能跨线程关联同一次 RPC 的连接 ID 与请求 ID
- 用固定字段记录请求所处阶段、耗时和结果,而不是拼接随意文本
- 通过请求 ID 从多行日志还原完整调用路径
一条链路需要哪些字段
纯文本日志的问题不在于“不能搜索”,而在于字段不稳定。同一个请求如果一会儿写“开始处理”,一会儿写“dispatch ok”,机器就很难可靠聚合。结构化日志应固定字段名与含义。
至少保留 connection_id、request_id、stage、event、status 和 elapsed_us。其中连接 ID 用来关联同一 TCP 连接上的多个请求,请求 ID 则必须唯一标识一次 RPC。stage 建议使用有限枚举,如 accept、decode、dispatch、execute、respond,避免自由文本。
错误场景再增加 error_type 与简短 message。业务参数只记录定位必需且允许落盘的内容,密码、Token、身份证号等敏感数据不应进入日志。
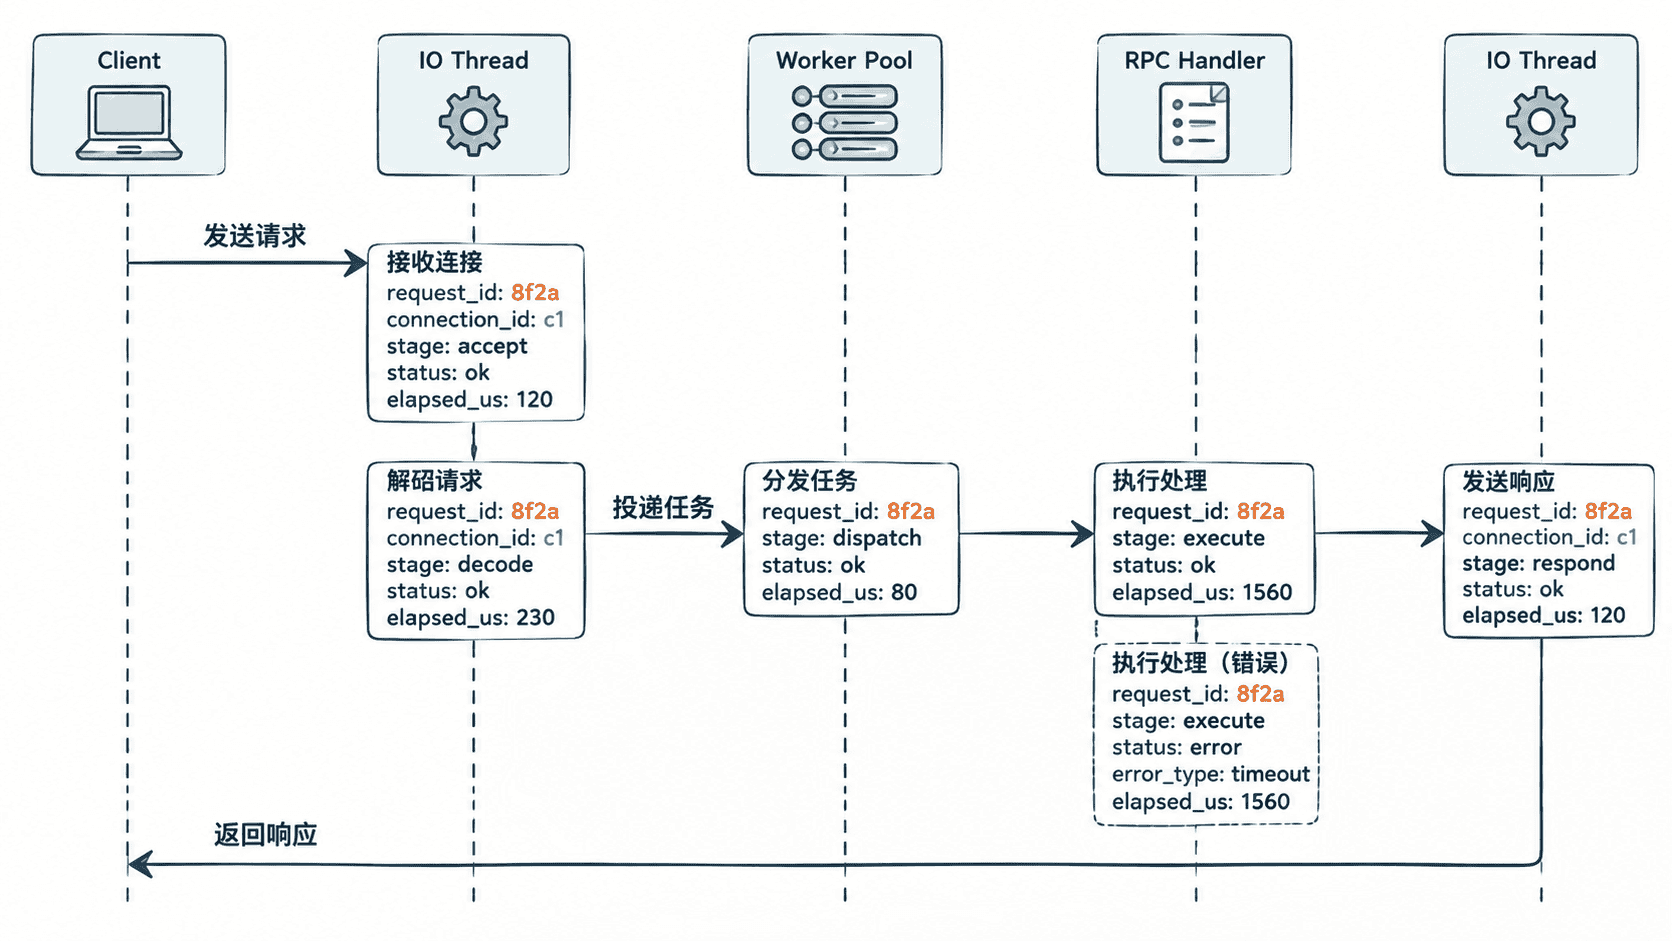
让上下文跨线程传递
Reactor 网络库经常在 IO 线程收包,在工作线程执行 RPC,再回到 IO 线程发送响应。如果只依赖线程 ID,链路会在调度点断掉。因此应显式创建请求上下文,并随任务一起投递。
下面示例直接输出 JSON Lines。它没有引入日志框架,但展示了稳定字段、请求上下文传递和阶段耗时的完整最小实现。
#include <chrono>
#include <cstdint>
#include <iostream>
#include <sstream>
#include <string>

struct RequestContext {
    std::uint64_t connectionId;
    std::uint64_t requestId;
};

void logEvent(const RequestContext& ctx,
              const std::string& stage,
              const std::string& event,
              const std::string& status,
              std::int64_t elapsedUs) {
    std::ostringstream out;
    out << "{"
        << "\"connection_id\":" << ctx.connectionId << ","
        << "\"request_id\":" << ctx.requestId << ","
        << "\"stage\":\"" << stage << "\","
        << "\"event\":\"" << event << "\","
        << "\"status\":\"" << status << "\","
        << "\"elapsed_us\":" << elapsedUs
        << "}";
    std::cout << out.str() << '\n';
}

int main() {
    RequestContext ctx{42, 1001};

    logEvent(ctx, "decode", "request_decoded", "ok", 35);
    // 请求进入工作线程后仍携带同一份上下文,不能重新生成 request_id。
    logEvent(ctx, "dispatch", "task_enqueued", "ok", 12);
    logEvent(ctx, "execute", "handler_finished", "ok", 680);
    logEvent(ctx, "respond", "response_written", "ok", 91);

    return 0;
}
预期输出:
{"connection_id":42,"request_id":1001,"stage":"decode","event":"request_decoded","status":"ok","elapsed_us":35}
{"connection_id":42,"request_id":1001,"stage":"dispatch","event":"task_enqueued","status":"ok","elapsed_us":12}
{"connection_id":42,"request_id":1001,"stage":"execute","event":"handler_finished","status":"ok","elapsed_us":680}
{"connection_id":42,"request_id":1001,"stage":"respond","event":"response_written","status":"ok","elapsed_us":91}
只要按 request_id=1001 检索,就能把这四条来自不同阶段的日志还原为一次调用。真实系统还可以补充时间戳、服务名、RPC 方法和线程名,但核心关联字段不要变化。
记录状态变化而不是重复正文
结构化日志的价值在于“事件可比较”。例如 event=request_decoded 表示完成了解码,event=task_enqueued 表示进入队列,event=handler_finished 表示业务执行结束。每个事件都应该代表明确的状态变化,而不是把同一句“正在处理请求”打印多次。
耗时字段也应绑定阶段。elapsed_us 如果代表当前阶段耗时,就必须始终保持这个语义;如果还需要端到端总耗时,单独增加如 total_elapsed_us 的字段。不要在不同代码路径里让同一个字段有时表示排队时间、有时表示总时间。
用日志还原一次失败请求
排障时先按请求 ID 聚合,再按阶段顺序检查缺口。如果有 decode 和 dispatch,却没有 execute,问题更可能发生在任务队列或线程池;如果 execute 成功但没有 respond,则应继续看连接状态、写缓冲和对端关闭。
错误日志还要保持分类稳定。例如超时统一使用 error_type=timeout,协议解析失败使用 error_type=protocol_error。这样既可以全文追踪单次请求,也可以按错误类型聚合统计。连接 ID、请求 ID、阶段和错误类型一旦稳定下来,日志才能真正承担“还原链路”而不是“堆积文本”的职责。