
C / C++ / 系统课时
实现断线重连与退避控制
实现断线重连与退避控制
主动连接一旦断开,如果客户端立即无限重连,就会在服务不可用时制造高频连接风暴。本节用明确状态机管理断线重连,并用指数退避和随机抖动拉开重试时间,使客户端既能自动恢复,又不会把故障进一步放大。
学习目标
- 能定义主动连接从连接、成功、断线到等待重试的状态转换
- 能实现带上限的指数退避,并理解为什么需要随机抖动
- 能在连接成功后正确重置重试计数,避免后续恢复越来越慢
先把重连做成状态机
重连逻辑不要散落在连接回调、定时器和异常处理里。最小状态可以包含 Disconnected、Connecting、Connected 和 Backoff:发起连接前进入 Connecting,成功后进入 Connected,失败或断线后计算等待时间并进入 Backoff,定时器到期后再重新连接。
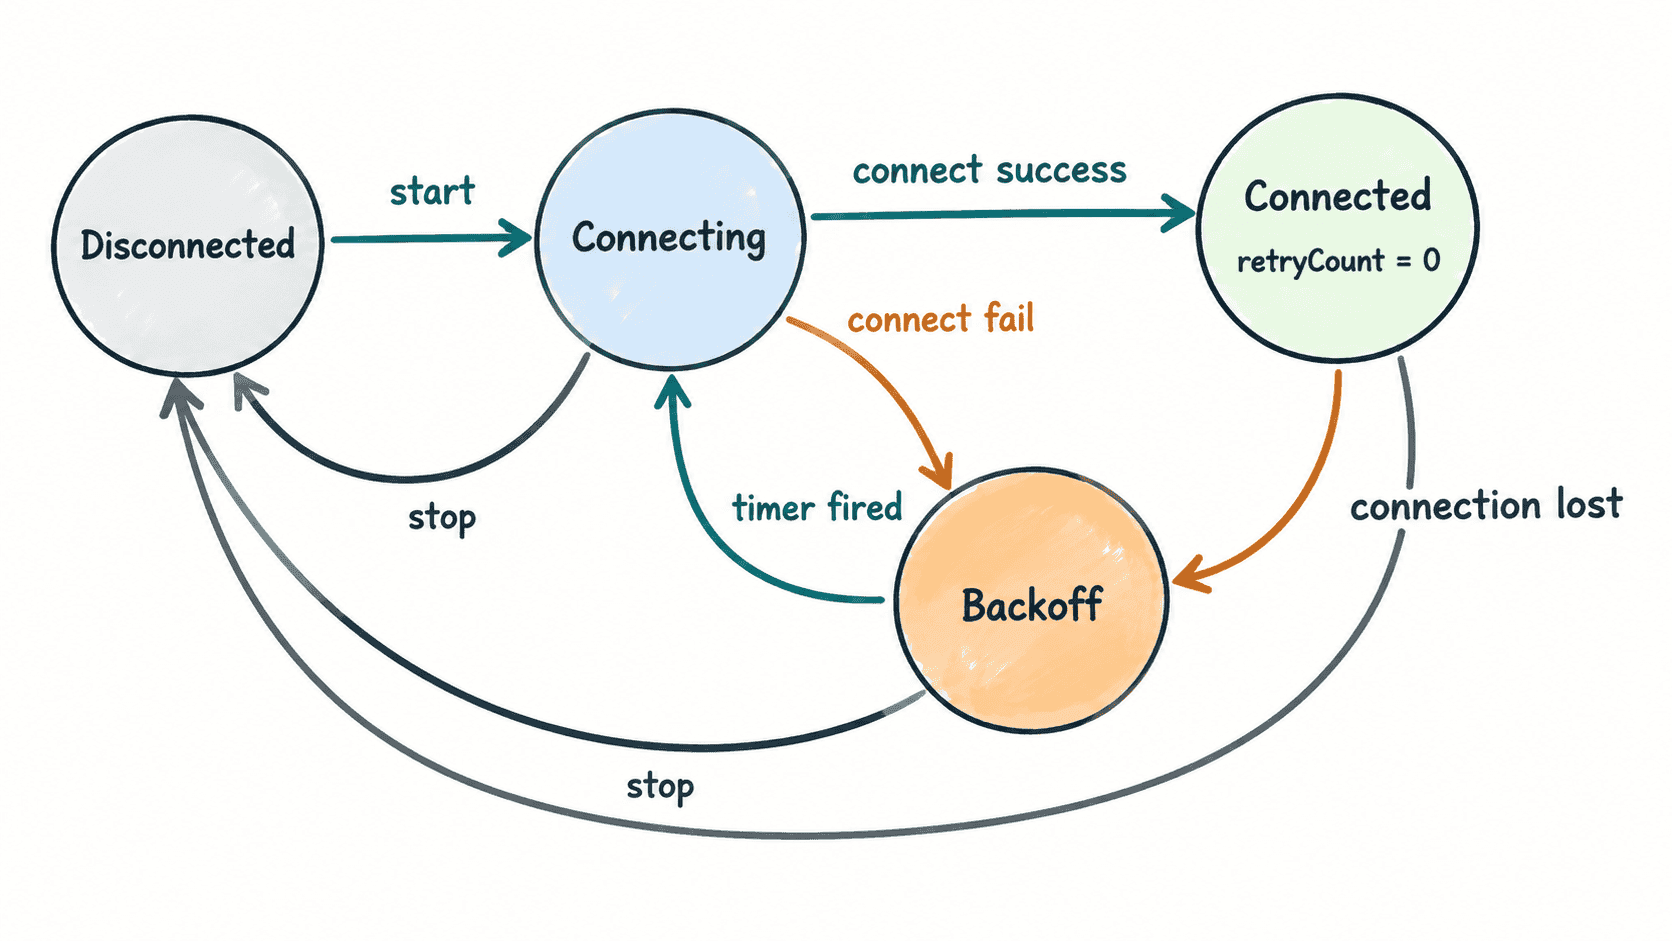
这四个状态能解决两个常见问题:第一,避免同一连接同时启动多个重连定时器;第二,停止客户端时可以统一取消等待中的重试,而不是让旧定时器再次把连接拉起来。
计算指数退避
第 次失败后的基础等待时间可以写成:
如果所有客户端都使用完全相同的等待时间,它们仍可能在同一时刻再次发起连接。因此通常再引入随机抖动,例如从基础等待时间的 50%~100% 区间随机取值。生产代码可使用线程本地随机数生成器;为了让下面示例的预期输出完全可验证,主程序直接传入确定的抖动比例。
#include <algorithm>
#include <chrono>
#include <cstdint>
#include <iostream>

class ReconnectBackoff {
public:
    ReconnectBackoff(std::chrono::milliseconds baseDelay,
                     std::chrono::milliseconds maxDelay)
        : baseDelay_(baseDelay), maxDelay_(maxDelay) {}

    std::chrono::milliseconds nextDelay(unsigned jitterPercent) {
        // jitterPercent 在生产环境中应由随机数生成器产生,例如 50~100。
        jitterPercent = std::clamp(jitterPercent, 50u, 100u);
        const std::uint64_t factor = std::uint64_t{1} << std::min(retryCount_, 20u);
        const auto raw = std::min<std::uint64_t>(
            static_cast<std::uint64_t>(maxDelay_.count()),
            static_cast<std::uint64_t>(baseDelay_.count()) * factor);

        ++retryCount_;
        return std::chrono::milliseconds(raw * jitterPercent / 100);
    }

    void onConnected() {
        // 成功建立连接后,下一次断线重新从最短退避开始。
        retryCount_ = 0;
    }

private:
    std::chrono::milliseconds baseDelay_;
    std::chrono::milliseconds maxDelay_;
    unsigned retryCount_ = 0;
};

int main() {
    ReconnectBackoff backoff(
        std::chrono::milliseconds(1000),
        std::chrono::milliseconds(8000));

    const unsigned jitters[] = {60, 75, 90, 55};
    for (unsigned jitter : jitters) {
        std::cout << "retry delay="
                  << backoff.nextDelay(jitter).count()
                  << "ms\n";
    }

    backoff.onConnected();
    std::cout << "after reconnect="
              << backoff.nextDelay(80).count()
              << "ms\n";
}
预期输出
retry delay=600ms
retry delay=1500ms
retry delay=3600ms
retry delay=4400ms
after reconnect=800ms
第四次基础等待已经达到 8000ms,再乘 55% 抖动得到 4400ms。连接成功后计数归零,因此下一次失败重新以 1000ms 为基础计算,而不是继续沿用高位退避。
接到 Reactor 定时器
真实网络库里不要用 sleep 后重连,因为这会阻塞事件循环。连接失败后应计算 delay,把“再次调用 connect”注册到 Reactor 的定时器;定时器触发时先检查客户端是否仍处于 Backoff,再切到 Connecting 并发起连接。
片段示例,假设 Reactor 已提供 runAfter,连接器提供 connect:
void Client::scheduleReconnect() {
    state_ = State::Backoff;
    auto delay = backoff_.nextDelay(randomJitterPercent());

    reconnectTimer_ = reactor_.runAfter(delay, [this] {
        if (state_ != State::Backoff) {
            return;
        }

        state_ = State::Connecting;
        connector_.connect();
    });
}

void Client::onConnected() {
    state_ = State::Connected;
    backoff_.onConnected();
}
这段代码依赖已有的 Reactor、定时器句柄、Connector 和 randomJitterPercent()。验证时应确认:断线后事件循环仍可处理其他连接;等待期间不会重复创建重连任务;连接成功后重试计数被清零。
处理停止与并发边界
实现重连时最危险的不是公式,而是生命周期。客户端主动 stop 后必须取消未触发的重连定时器,并把状态切回 Disconnected;连接回调和定时器回调如果可能跨线程执行,还要保证状态修改发生在 Reactor 所在线程,或使用等价的串行化机制。
指数退避负责“越失败越慢”,随机抖动负责“不要一起重试”,状态机负责“同一时刻只能有一条重连路径”。三者同时成立,自动重连才是真正可控的可靠性能力。