
C / C++ / 系统课时
构造 RPC 并发压测客户端
构造 RPC 并发压测客户端
要判断 RPC 网络库能承受多少并发,不能只看“每秒请求数”。一个合格的压测客户端还要独立控制连接数、并发中的未完成请求数和请求速率,并记录端到端延迟分布。本节实现一个最小可运行压测器,并说明如何从结果中区分客户端瓶颈和服务端瓶颈。
学习目标
- 能区分连接数、并发度和请求速率三个压测旋钮
- 能实现固定并发的 RPC 压测客户端并统计吞吐量与延迟
- 能用 P50、P95、P99 和错误率判断系统是否进入饱和
先分清三个压测旋钮
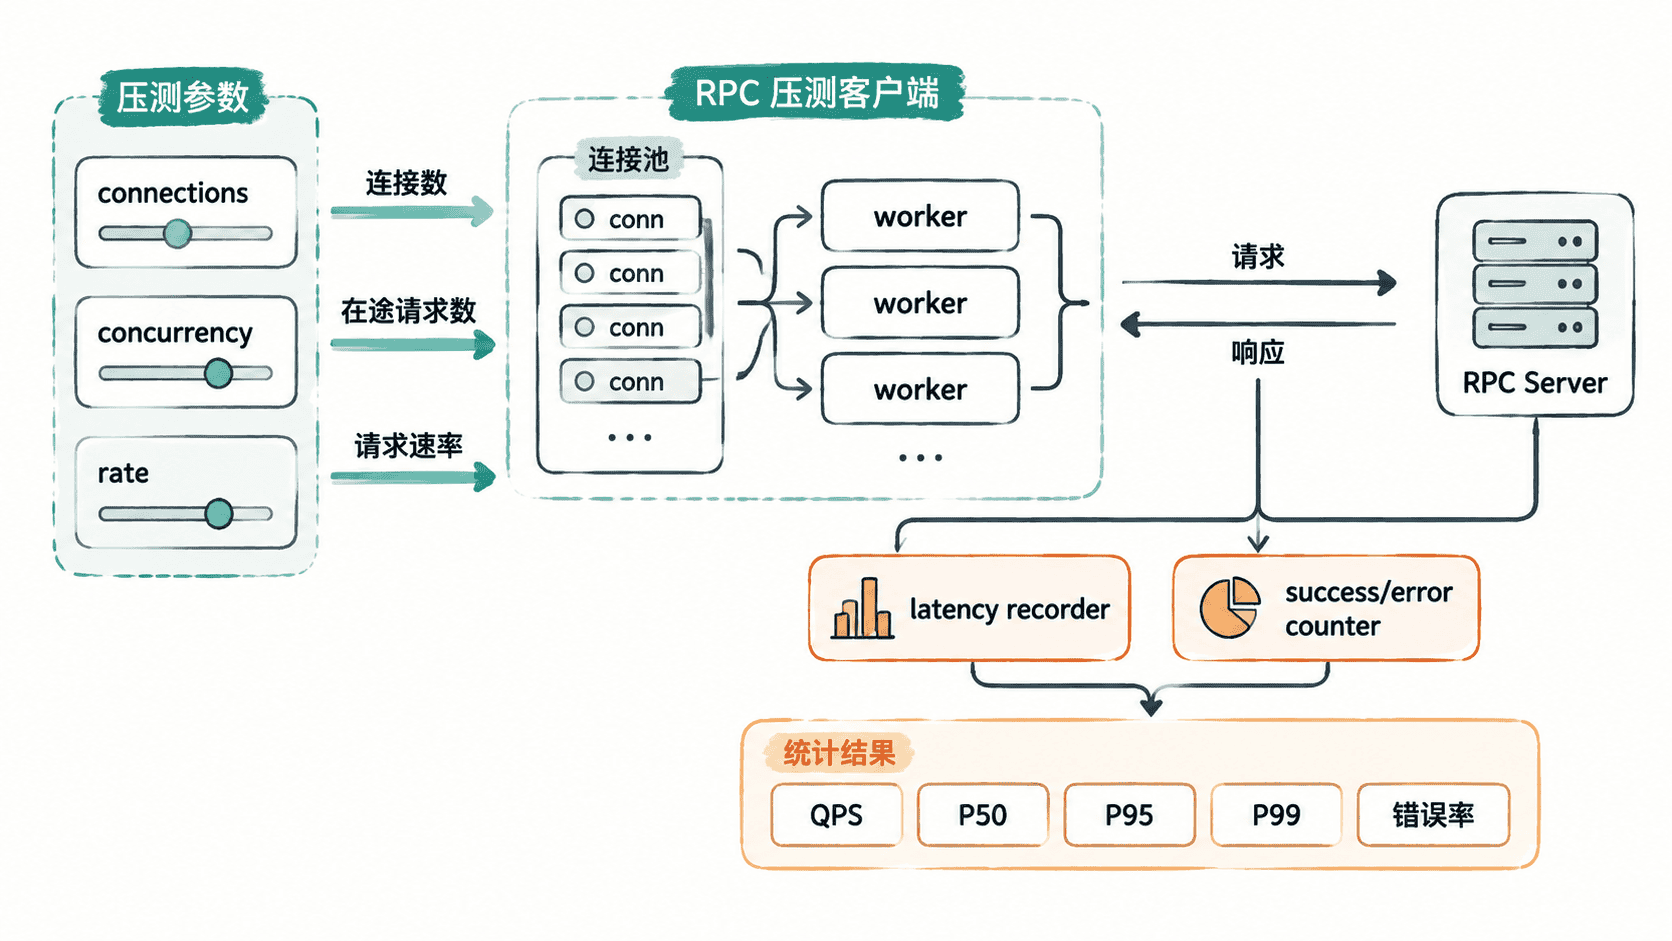
连接数决定同时维护多少条 TCP 通道;并发度决定同一时刻有多少个未完成 RPC;请求速率决定每秒主动发出多少请求。这三个量不是一回事:100 条连接可以只有 100 个在途请求,也可以在支持多路复用时承载数千个在途请求。
固定并发压测最适合验证网络库极限,因为客户端在一个请求完成后立即补发下一个请求,始终维持目标并发。固定 QPS 则更适合复现真实流量。实际压测时应先用固定并发找到饱和点,再用固定速率验证目标业务负载。
实现固定并发压测器
下面用线程模拟并发 RPC,每次请求用睡眠表示网络往返。它不是生产 RPC 协议实现,但压测骨架是真实可迁移的:共享原子计数器分配请求,记录每次端到端耗时,全部完成后计算吞吐和分位数。接入你的 RPC Client 时,只需替换 fakeRpcCall()。
#include <algorithm>
#include <atomic>
#include <chrono>
#include <iostream>
#include <mutex>
#include <thread>
#include <vector>

using Clock = std::chrono::steady_clock;

void fakeRpcCall() {
    // 用固定 2 ms 往返时间模拟一次成功 RPC。
    std::this_thread::sleep_for(std::chrono::milliseconds(2));
}

double percentile(std::vector<double> values, double p) {
    std::sort(values.begin(), values.end());
    const size_t index = static_cast<size_t>((values.size() - 1) * p);
    return values[index];
}

int main() {
    const int totalRequests = 200;
    const int concurrency = 20;

    std::atomic<int> next{0};
    std::vector<double> latenciesMs;
    std::mutex latencyMutex;

    const auto begin = Clock::now();

    std::vector<std::thread> workers;
    for (int i = 0; i < concurrency; ++i) {
        workers.emplace_back([&] {
            while (true) {
                const int id = next.fetch_add(1);
                if (id >= totalRequests) break;

                const auto start = Clock::now();
                fakeRpcCall();
                const auto end = Clock::now();

                const double ms =
                    std::chrono::duration<double, std::milli>(end - start).count();

                std::lock_guard<std::mutex> lock(latencyMutex);
                latenciesMs.push_back(ms);
            }
        });
    }

    for (auto& worker : workers) worker.join();

    const auto finish = Clock::now();
    const double seconds =
        std::chrono::duration<double>(finish - begin).count();
    const double qps = totalRequests / seconds;

    std::cout << "requests=" << latenciesMs.size() << "\n";
    std::cout << "qps=" << static_cast<int>(qps) << "\n";
    std::cout << "p50_ms=" << percentile(latenciesMs, 0.50) << "\n";
    std::cout << "p95_ms=" << percentile(latenciesMs, 0.95) << "\n";
    std::cout << "p99_ms=" << percentile(latenciesMs, 0.99) << "\n";
}
预期输出形式如下,具体 QPS 和延迟会随操作系统调度而变化:
requests=200
qps=<DYNAMIC>
p50_ms=<DYNAMIC>
p95_ms=<DYNAMIC>
p99_ms=<DYNAMIC>
编译运行:
g++ -std=c++17 -O2 -pthread rpc_load.cpp -o rpc_load
./rpc_load
预期结果:
requests=200
qps=<DYNAMIC>
p50_ms=<DYNAMIC>
p95_ms=<DYNAMIC>
p99_ms=<DYNAMIC>
把连接数和速率控制加回真实客户端
真实 RPC 压测器通常维护连接池。若设置 connections=8、concurrency=200,说明 200 个在途请求需要复用 8 条连接;如果协议不支持多路复用,就必须限制每条连接同时只能有一个请求,否则响应关联会出错。
固定速率模式则需要令牌桶或节拍器控制发包。不要用“每个线程 sleep 固定时间”近似 QPS,因为线程调度误差会让整体速率漂移。更可靠的做法是由单一调度器按目标速率发放令牌,worker 只有取得令牌后才能创建新请求。
延迟记录应从“请求准备发送”开始,到“完整响应解析并交付调用者”结束。只统计 socket 写入到读到字节,会漏掉排队、序列化、反序列化和事件循环调度时间,得到的不是业务真正感受到的端到端延迟。
用分位数判断饱和点
平均延迟很容易掩盖长尾。压测至少记录成功数、失败数、吞吐量、P50、P95 和 P99。随着并发提高,健康系统通常会先提升吞吐;接近饱和后,吞吐增长放缓,而 P95、P99 快速上升。
例如并发从 100 增加到 200 时 QPS 只提高 5%,但 P99 从 20 ms 升到 180 ms,这已经是明显的排队信号。此时继续增加并发只会让请求堆积,而不是提高有效吞吐。
最终需要找到的不是“最大并发数字”,而是一组可解释的工作点:在目标错误率以内,吞吐稳定、P95/P99 可接受,并且连接池、事件循环和 CPU 都没有进入不可控排队。