
C / C++ / 系统课时
优雅停机并收尾在途请求
优雅停机并收尾在途请求
优雅停机的目标不是“尽快退出”,而是在拒绝新增工作后,把已经接收的请求安全收尾,并在截止时间到达时有序终止剩余任务。网络库需要把监听套接字、连接、事件循环、工作线程和底层资源按依赖顺序关闭,避免丢响应、悬空回调和进程卡死。
学习目标
- 设计“停止接入、排空在途、超时兜底”的停机流程
- 正确安排连接、EventLoop、线程和底层资源的关闭顺序
- 用在途计数与截止时间验证停机逻辑是否可靠
停机不是直接关闭所有 fd
收到 SIGTERM、服务下线或发布重启指令时,第一步应进入 draining 状态,而不是立刻销毁 EventLoop。否则正在处理的 RPC 可能来不及写回响应,线程池中的任务仍可能访问已经释放的连接对象。
一个可靠的停机链路通常分成三段:先停止接收新连接与新请求,再等待已经进入系统的工作归零,最后关闭事件循环、线程池和底层句柄。
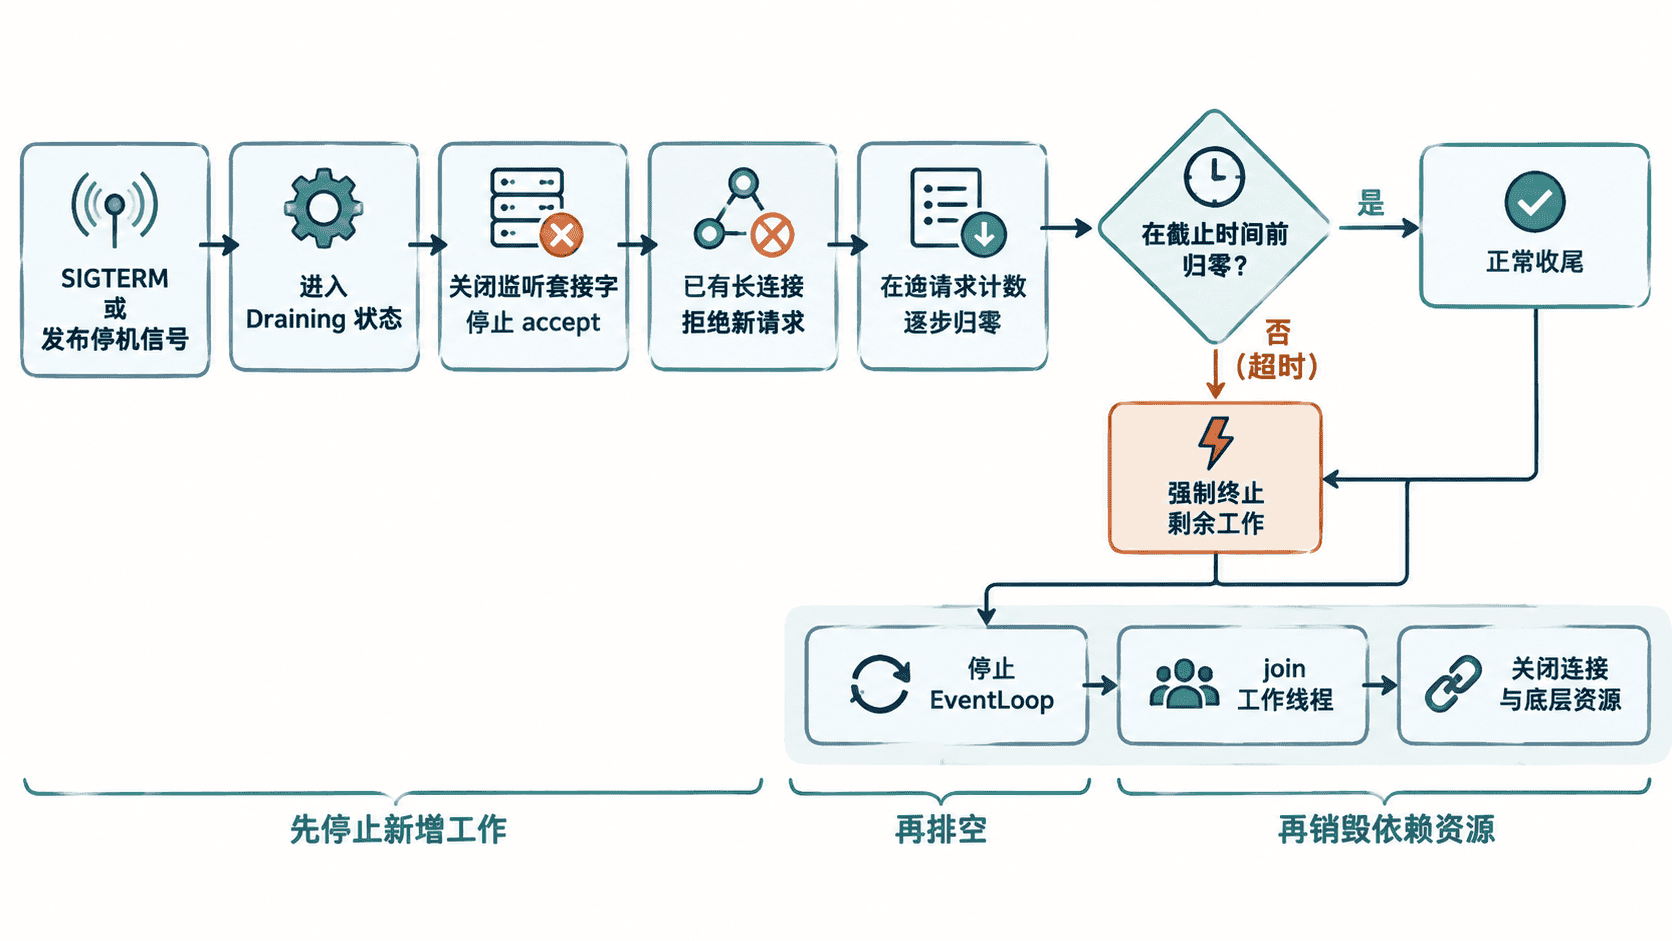
用在途计数控制排空
在途计数应覆盖“已经被服务接受、但尚未完成”的业务请求,而不是简单等同于 TCP 连接数。一个 Keep-Alive 连接可以连续承载多个请求,连接仍然存在并不代表系统还有工作。
进入 draining 后应保证两件事:监听器不再 accept 新连接;已有连接如果收到新业务请求,应返回协议允许的拒绝结果,或在应用层停止读取新请求。随后等待 inflight == 0,但必须设置最大等待时间。
下面用一个可独立运行的小程序模拟排空逻辑。真实网络库中,stopAccept()、请求入口和 EventLoop 退出动作会由对应组件实现。
#include <atomic>
#include <chrono>
#include <future>
#include <iostream>
#include <thread>
#include <vector>

class DrainController {
public:
    void beginRequest() {
        inflight_.fetch_add(1, std::memory_order_relaxed);
    }

    void endRequest() {
        inflight_.fetch_sub(1, std::memory_order_release);
    }

    void stopAccept() {
        accepting_.store(false, std::memory_order_release);
    }

    bool waitUntilDrained(std::chrono::milliseconds timeout) const {
        const auto deadline = std::chrono::steady_clock::now() + timeout;
        while (std::chrono::steady_clock::now() < deadline) {
            if (inflight_.load(std::memory_order_acquire) == 0) {
                return true;
            }
            std::this_thread::sleep_for(std::chrono::milliseconds(10));
        }
        return inflight_.load(std::memory_order_acquire) == 0;
    }

    bool accepting() const {
        return accepting_.load(std::memory_order_acquire);
    }

    int inflight() const {
        return inflight_.load(std::memory_order_acquire);
    }

private:
    std::atomic<bool> accepting_{true};
    std::atomic<int> inflight_{0};
};

int main() {
    DrainController drain;
    std::vector<std::future<void>> tasks;

    for (int delayMs : {80, 160}) {
        drain.beginRequest();
        tasks.push_back(std::async(std::launch::async, [&drain, delayMs] {
            std::this_thread::sleep_for(std::chrono::milliseconds(delayMs));
            drain.endRequest();
        }));
    }

    // 停机时先切断新增流量,再等待已接收工作结束。
    drain.stopAccept();
    const bool drained = drain.waitUntilDrained(std::chrono::milliseconds(500));

    for (auto& task : tasks) {
        task.get();
    }

    std::cout << std::boolalpha
              << "accepting=" << drain.accepting() << '\n'
              << "inflight=" << drain.inflight() << '\n'
              << "drained=" << drained << '\n';
}
预期输出:
accepting=false
inflight=0
drained=true
这个示例只演示排空控制器;生产代码还要确保请求开始与结束计数成对出现。异常返回、超时、取消和抛异常路径都必须执行减计数,最稳妥的方式是用 RAII guard 绑定请求生命周期。
按依赖顺序关闭组件
资源关闭顺序要从“产生新工作的一端”走向“承载工作的一端”。常见顺序是:
- 标记服务进入 draining,并从负载均衡或服务发现中摘除。
- 关闭监听 fd,停止 accept;已有连接停止接收新业务请求。
- 等待在途请求归零,或等待到停机截止时间。
- 让连接完成最后一次写回,并禁止再注册新的定时器和异步任务。
- 请求各 EventLoop 退出,唤醒阻塞在 poll、epoll_wait 或 kevent 中的线程。
join工作线程,确认不会再有回调访问连接、TimerQueue 或 Poller。- 最后销毁连接表、定时器、Poller、文件描述符以及日志等底层资源。
超时兜底不能省
优雅停机永远需要截止时间,因为远端可能不读响应、业务任务可能死锁、第三方调用也可能无限等待。超过截止时间后,服务应记录剩余在途数量和连接信息,再进入强制收尾,而不是无限挂住发布流程。
超时分支的动作取决于协议和业务语义:可以取消可取消任务、关闭仍未结束的连接,或让进程退出并由上层编排系统回收。重要的是让“正常排空”和“超时退出”都成为可测试的确定路径。
验证时至少覆盖三种情况:无在途请求时立即退出;短请求在截止时间前全部完成;故意制造长任务时按截止时间进入强制路径。只有这三条都可重复通过,停机流程才具备上线价值。