
C / C++ / 系统课时
用 Codec 隔离协议与连接
用 Codec 隔离协议与连接
当网络库把“收发字节”和“理解协议”写进同一个 TcpConnection,连接层很快就会被长度字段、消息类型和序列化细节污染。本节把这些职责抽到独立 Codec,让连接只负责字节传输,让协议层专注成帧、编解码与消息回调。
学习目标
- 理解
TcpConnection与Codec的职责边界,避免协议逻辑侵入连接层 - 掌握“收到字节 → Codec 解码 → 业务回调”和“业务消息 → Codec 编码 → 连接发送”的双向链路
- 能实现一个最小长度头 Codec,并验证半包与粘包场景
为什么要把协议从连接里拿出去
TcpConnection 最稳定的职责只有两类:维护连接生命周期,以及在 socket 与缓冲区之间搬运字节。至于一条消息如何分帧、头部占几个字节、正文采用什么格式,都属于应用协议。
如果把这些逻辑直接写进 TcpConnection 的读事件处理函数,每增加一种协议就要修改连接类,测试时也很难单独验证编解码规则。更合理的做法是让连接层只暴露“收到字节”和“发送字节”的能力,由 Codec 解释这些字节。
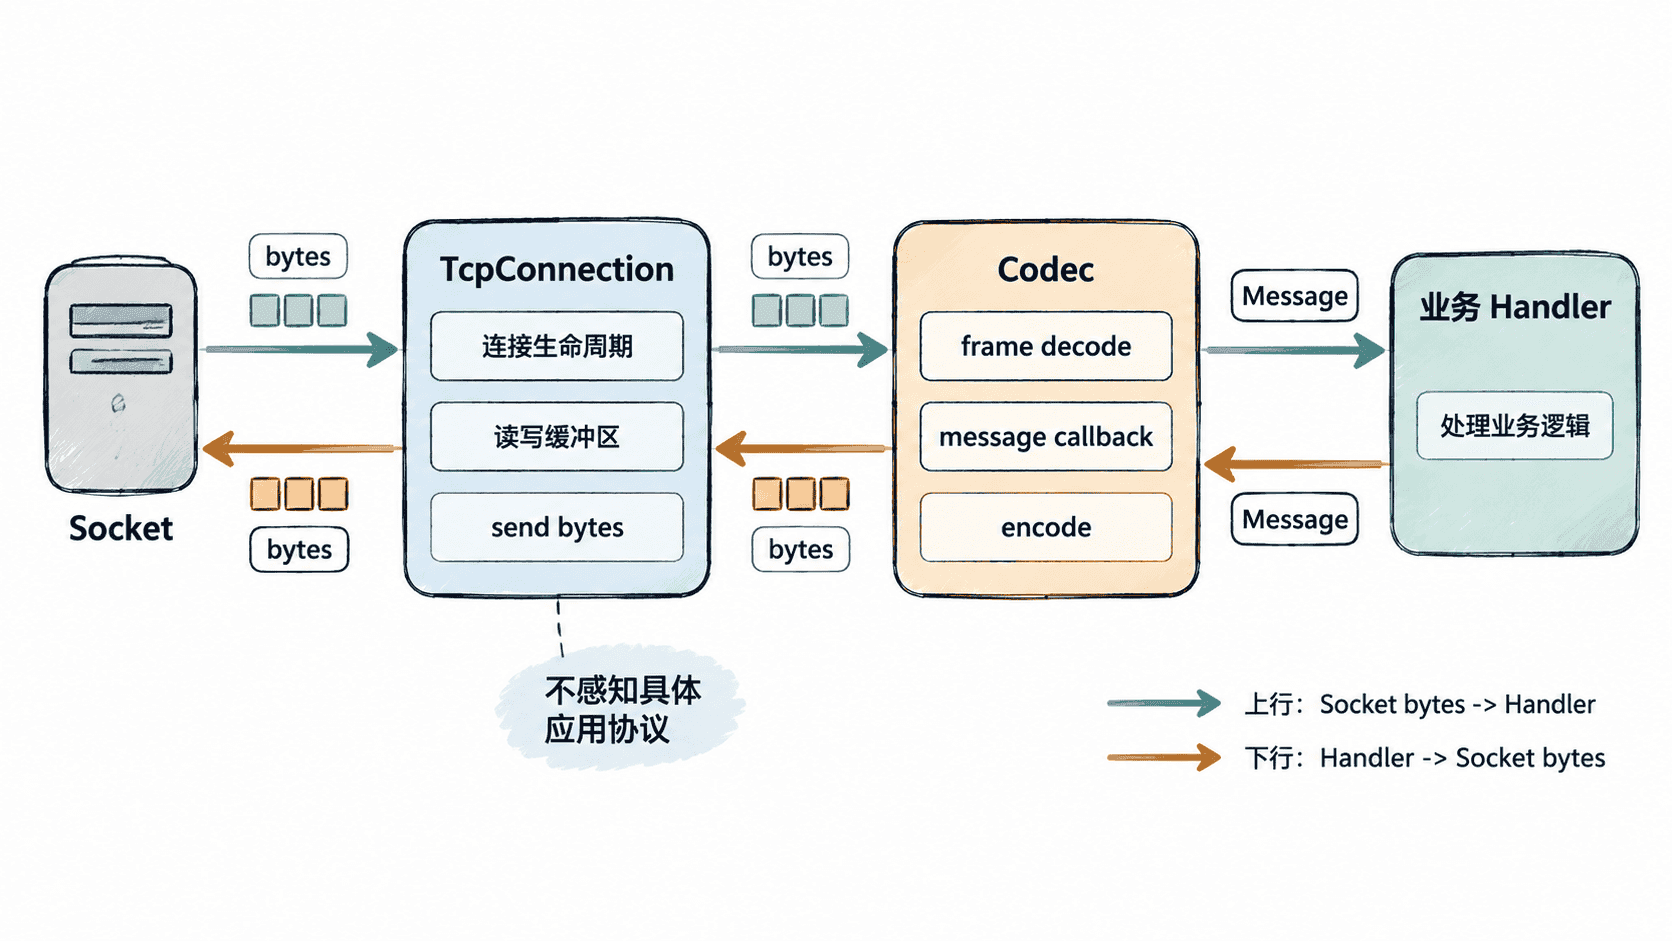
这种隔离带来的直接收益是连接可复用、协议可替换、测试粒度更小。HTTP、私有二进制协议或 RPC 协议都可以复用同一套连接管理代码,只替换对应的 Codec。
Codec 的最小实现
一个实用 Codec 至少需要两条路径:解码路径接收连接读到的字节并产出完整消息;编码路径接收业务消息并生成待发送字节。下面使用“4 字节大端长度头 + 文本正文”实现一个可运行示例。
#include <cstdint>
#include <cstring>
#include <iostream>
#include <stdexcept>
#include <string>
#include <vector>

class LengthHeaderCodec {
public:
    std::vector<char> encode(const std::string& message) const {
        const std::uint32_t len = static_cast<std::uint32_t>(message.size());
        std::vector<char> out(4 + message.size());

        // 长度头固定使用大端序,保证通信双方对字节顺序的理解一致。
        out[0] = static_cast<char>((len >> 24) & 0xff);
        out[1] = static_cast<char>((len >> 16) & 0xff);
        out[2] = static_cast<char>((len >> 8) & 0xff);
        out[3] = static_cast<char>(len & 0xff);
        std::memcpy(out.data() + 4, message.data(), message.size());
        return out;
    }

    std::vector<std::string> feed(const std::vector<char>& bytes) {
        buffer_.insert(buffer_.end(), bytes.begin(), bytes.end());
        std::vector<std::string> messages;

        while (buffer_.size() >= 4) {
            const auto b0 = static_cast<std::uint32_t>(static_cast<unsigned char>(buffer_[0]));
            const auto b1 = static_cast<std::uint32_t>(static_cast<unsigned char>(buffer_[1]));
            const auto b2 = static_cast<std::uint32_t>(static_cast<unsigned char>(buffer_[2]));
            const auto b3 = static_cast<std::uint32_t>(static_cast<unsigned char>(buffer_[3]));
            const std::uint32_t len = (b0 << 24) | (b1 << 16) | (b2 << 8) | b3;

            if (len > 1024 * 1024) {
                throw std::runtime_error("frame too large");
            }
            if (buffer_.size() < 4 + len) {
                break; // 半包:保留现有数据,等待下一批字节。
            }

            messages.emplace_back(buffer_.begin() + 4, buffer_.begin() + 4 + len);
            buffer_.erase(buffer_.begin(), buffer_.begin() + 4 + len);
        }
        return messages;
    }

private:
    std::vector<char> buffer_;
};

int main() {
    LengthHeaderCodec codec;
    const auto a = codec.encode("hello");
    const auto b = codec.encode("world");

    // 第一次只送入一帧的前三个字节,模拟半包。
    std::vector<char> first(a.begin(), a.begin() + 3);
    for (const auto& message : codec.feed(first)) {
        std::cout << message << std::endl;
    }

    // 第二次同时送入第一帧剩余部分和完整第二帧,模拟半包恢复与粘包。
    std::vector<char> second(a.begin() + 3, a.end());
    second.insert(second.end(), b.begin(), b.end());
    for (const auto& message : codec.feed(second)) {
        std::cout << message << std::endl;
    }
}
预期输出:
hello
world
feed() 没有假设一次 socket read 就得到一条完整消息。它先把字节追加到内部缓冲区,只有当长度头和完整正文都到齐后才产出消息,因此同一套逻辑可以同时处理半包和粘包。
接入 TcpConnection 后怎么分工
真实网络库中,TcpConnection 收到可读事件后,将读取到的数据追加进输入缓冲区,再交给 Codec。Codec 每解出一条完整消息就触发业务回调;发送方向则相反,业务层先提交消息,Codec 编码成字节,再调用连接的发送接口。
连接关闭、重连、背压和高低水位仍属于 TcpConnection;长度校验、消息类型解析、序列化与协议错误则属于 Codec。边界稳定以后,增加新协议通常只需要新增 Codec,而不需要改动连接核心。
解码边界必须明确
Codec 至少要限制最大帧长度,否则恶意或损坏的长度头可能导致缓冲区持续增长。解码遇到非法长度、未知版本或校验失败时,也应定义明确策略,例如关闭连接或报告协议错误,不能让已经失真的解析状态继续影响后续字节。
如果协议以后增加版本号、压缩标志或校验和,这些规则也应继续留在 Codec。判断边界可以归结为一句话:凡是“如何把字节解释成消息”的规则属于协议层,凡是“如何可靠搬运这些字节”的机制属于连接层。