
C / C++ / 系统课时
线程池压测时看哪些指标
线程池压测时看哪些指标
线程池压测不能只看“CPU 高不高”。真正要回答的是任务从进入队列到完成,时间花在了哪里。把吞吐、队列长度、排队等待、忙碌线程数、总线程数和 CPU 放到同一时间窗口里观察,才能区分算力不足、阻塞等待和线程配置问题。
学习目标
- 建立线程池压测的最小指标集,并理解每个指标对应哪一段执行路径
- 通过指标组合区分 CPU 饱和、任务阻塞、队列堆积和线程数不足
- 用一个可运行的 C++ 线程池压测程序观察队列、吞吐和等待时间变化
先把指标放回任务执行路径
一次线程池任务至少经历“提交 → 入队 → 被线程取走 → 执行 → 完成”。因此最有用的指标不是孤立的单值,而是同一时间窗口里的组合:
| 指标 | 直接回答的问题 |
|---|---|
| 吞吐量 | 单位时间真正完成了多少任务 |
| 队列长度 | 任务是否持续来得比线程处理得快 |
| 平均排队等待 | 任务在开始执行前被堵了多久 |
| 忙碌线程数 | 当前有多少工作线程正在执行任务 |
| 总线程数 | 线程池配置是否固定、是否异常膨胀 |
| CPU 使用率 | 线程是在做计算,还是大量时间花在等待上 |
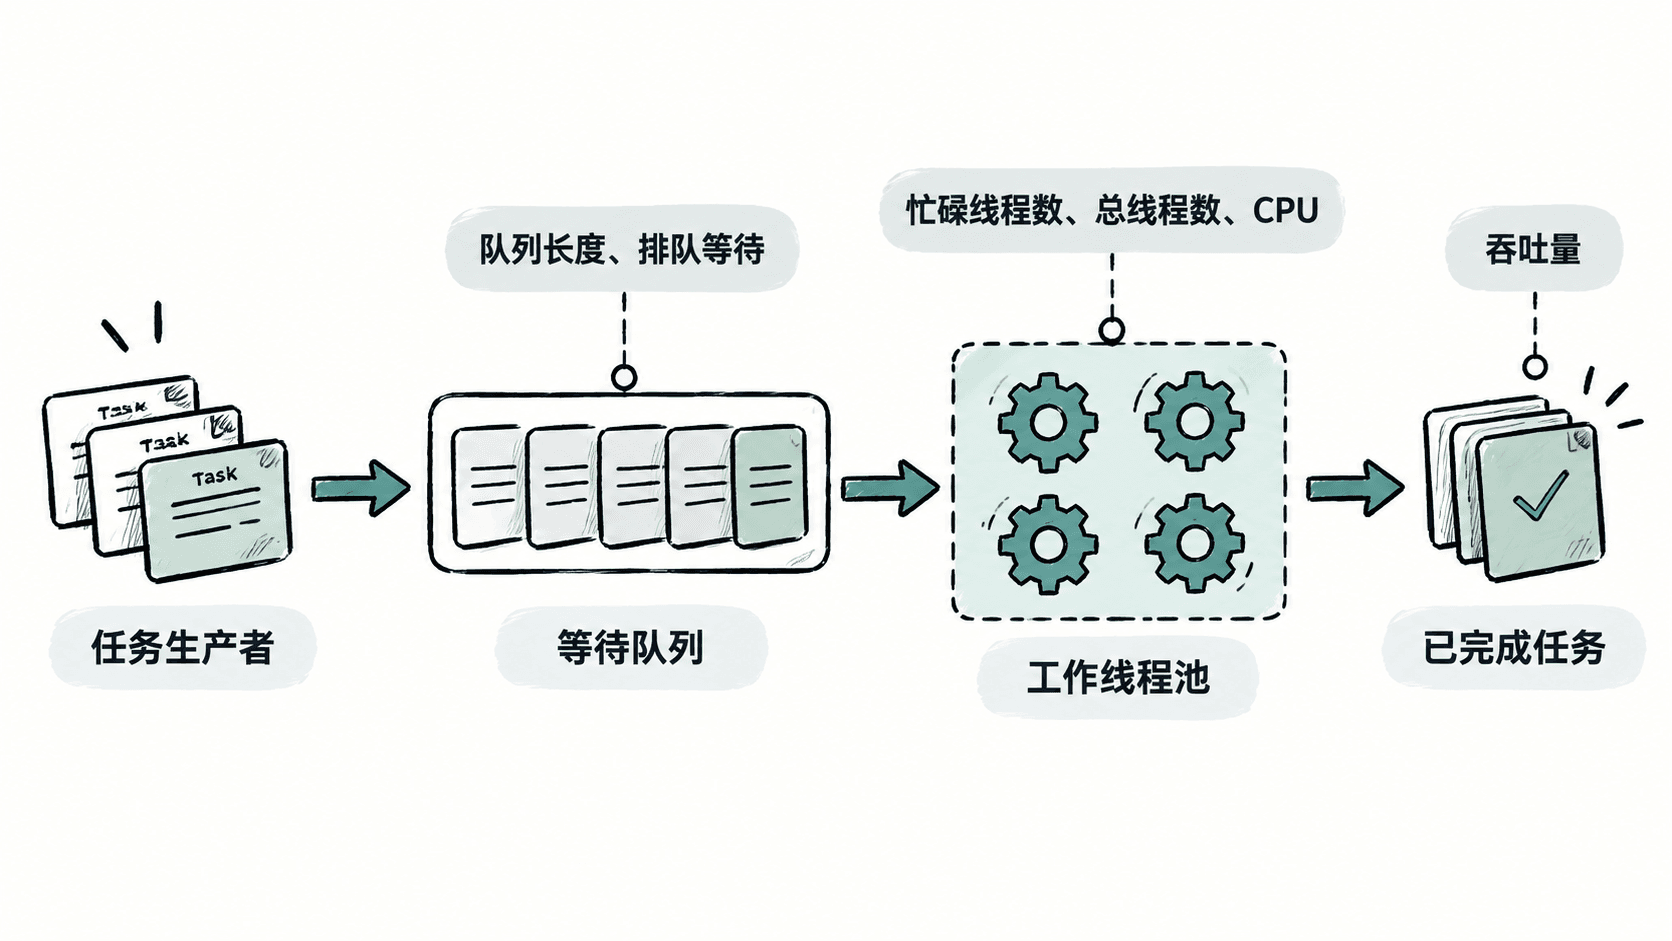
单看 CPU 很容易误判。例如队列持续增长且 CPU 很低,不代表“线程池很空闲”,反而可能是所有工作线程都堵在网络、磁盘、锁或条件变量上。
用最小程序观测队列和等待时间
下面的固定线程池会记录提交数、开始执行数、完成数、当前忙碌线程数、队列长度和累计排队等待。程序支持 sleep 与 cpu 两种任务,用同一线程数制造“阻塞型”和“计算型”负载。
#include <atomic>
#include <chrono>
#include <condition_variable>
#include <cstdint>
#include <functional>
#include <iostream>
#include <mutex>
#include <queue>
#include <string>
#include <thread>
#include <vector>

using Clock = std::chrono::steady_clock;

struct Task {
    Clock::time_point queued_at;
    std::function<void()> fn;
};

class ThreadPool {
public:
    // 固定线程数便于把队列变化与工作线程数量直接对应。
    explicit ThreadPool(std::size_t n) : thread_count_(n) {
        for (std::size_t i = 0; i < n; ++i) {
            workers_.emplace_back([this] { run(); });
        }
    }

    ~ThreadPool() {
        {
            std::lock_guard<std::mutex> lock(mu_);
            stopping_ = true;
        }
        cv_.notify_all();
        for (auto& t : workers_) {
            t.join();
        }
    }

    void submit(std::function<void()> fn) {
        {
            // 入队时记录时间,工作线程取任务时可计算排队等待。
            std::lock_guard<std::mutex> lock(mu_);
            tasks_.push({Clock::now(), std::move(fn)});
            ++submitted_;
        }
        cv_.notify_one();
    }

    std::size_t queued() const {
        std::lock_guard<std::mutex> lock(mu_);
        return tasks_.size();
    }

    std::uint64_t submitted() const { return submitted_.load(); }
    std::uint64_t started() const { return started_.load(); }
    std::uint64_t completed() const { return completed_.load(); }
    std::uint64_t busy() const { return busy_.load(); }
    std::size_t threads() const { return thread_count_; }

    double avg_wait_ms() const {
        auto n = started_.load();
        return n == 0 ? 0.0 : wait_us_.load() / 1000.0 / n;
    }

private:
    void run() {
        while (true) {
            Task task;
            {
                std::unique_lock<std::mutex> lock(mu_);
                cv_.wait(lock, [this] { return stopping_ || !tasks_.empty(); });
                if (stopping_ && tasks_.empty()) {
                    return;
                }
                task = std::move(tasks_.front());
                tasks_.pop();
            }

            // 先统计等待,再标记线程忙碌,避免把排队时间混入执行时间。
            auto wait = std::chrono::duration_cast<std::chrono::microseconds>(
                Clock::now() - task.queued_at).count();
            wait_us_.fetch_add(static_cast<std::uint64_t>(wait));
            ++started_;
            ++busy_;
            task.fn();
            --busy_;
            ++completed_;
        }
    }

    std::size_t thread_count_;
    mutable std::mutex mu_;
    std::condition_variable cv_;
    std::queue<Task> tasks_;
    std::vector<std::thread> workers_;
    bool stopping_{false};
    std::atomic<std::uint64_t> submitted_{0};
    std::atomic<std::uint64_t> started_{0};
    std::atomic<std::uint64_t> completed_{0};
    std::atomic<std::uint64_t> busy_{0};
    std::atomic<std::uint64_t> wait_us_{0};
};

void busy_for(std::chrono::milliseconds duration) {
    // 用真实时间窗口制造 CPU 忙等,避免循环次数受机器性能影响过大。
    auto end = Clock::now() + duration;
    volatile std::uint64_t x = 0;
    while (Clock::now() < end) {
        ++x;
    }
}

int main(int argc, char** argv) {
    std::string mode = argc > 1 ? argv[1] : "sleep";
    ThreadPool pool(4);

    // 一次性提交一批任务,让队列有机会形成可观察的积压。
    for (int i = 0; i < 200; ++i) {
        pool.submit([mode] {
            if (mode == "cpu") {
                busy_for(std::chrono::milliseconds(20));
            } else {
                std::this_thread::sleep_for(std::chrono::milliseconds(20));
            }
        });
    }

    std::uint64_t previous_completed = 0;
    // 固定 200 ms 采样一次,用完成数增量近似当前吞吐。
    while (pool.completed() < pool.submitted()) {
        std::this_thread::sleep_for(std::chrono::milliseconds(200));
        auto completed = pool.completed();
        auto throughput = (completed - previous_completed) * 5;
        previous_completed = completed;

        std::cout << "throughput=" << throughput
                  << "/s queued=" << pool.queued()
                  << " busy=" << pool.busy() << "/" << pool.threads()
                  << " avg_wait_ms=" << pool.avg_wait_ms() << "\n";
    }
}
预期结果:保存为 pool_bench.cpp 后可用 C++17 编译;每 200 ms 会输出一次吞吐、队列长度、忙碌线程比例和平均排队等待。
编译并运行阻塞型任务:
g++ -std=c++17 -O2 -pthread pool_bench.cpp -o pool_bench
./pool_bench sleep
预期输出(具体数字与机器调度有关):
throughput=<N>/s queued=<N> busy=4/4 avg_wait_ms=<TIME>
throughput=<N>/s queued=<N> busy=4/4 avg_wait_ms=<TIME>
...
throughput=<N>/s queued=0 busy=<N>/4 avg_wait_ms=<TIME>
这里最重要的不是某个绝对值,而是趋势:开始时 busy=4/4、队列很长,随后队列逐渐下降;如果提交速率持续高于完成速率,队列与等待时间会持续上升。
再把 CPU 与线程数并进同一时间窗口
运行计算型任务时,把程序放到后台并同时观察进程线程数和 CPU:
./pool_bench cpu &
pid=$!
ps -p "$pid" -o pid,nlwp,pcpu,stat,comm
wait "$pid"
预期输出(PID、CPU 百分比和线程数会随采样时刻变化):
    PID NLWP %CPU STAT COMMAND
   <ID>  <N>  <N> Sl   pool_bench
throughput=<N>/s queued=<N> busy=4/4 avg_wait_ms=<TIME>
...
NLWP 应接近“4 个工作线程 + 主线程”,但采样发生在进程收尾阶段时可能更少。Linux ps 的 %CPU 是进程级采样值,受采样窗口和多核统计方式影响,因此更适合与线程池内部指标一起看,而不是单独作为结论。
用指标组合判断瓶颈
压测时按下面的组合判断,通常比先调线程数更快:
- 队列持续增长 + 等待时间持续增长 + busy 接近总线程数 + CPU 接近可用核上限:更像 CPU 计算饱和。继续加线程通常不会提升吞吐,甚至会增加上下文切换。
- 队列持续增长 + 等待时间增长 + busy 接近总线程数 + CPU 明显偏低:更像任务阻塞在 I/O、锁、条件变量或下游服务。此时应继续看线程栈和外部依赖,而不是只加 CPU。
- busy 长期低于总线程数 + 队列接近 0 + 吞吐仍低:瓶颈大概率在任务提交端、限流器或上游数据源,线程池本身没有被喂满。
- 线程数不断增加但吞吐几乎不变:动态扩容策略可能在掩盖阻塞;还要关注上下文切换、内存和调度开销。
线程池调优的验收标准应是“在目标负载下吞吐达到需求,同时队列和等待时间可控”,而不是追求 CPU 100% 或把线程数开到最大。只有把任务流、等待和资源使用放在同一时间轴上,才能知道该优化代码、下游依赖,还是线程池参数。