
C / C++ / 系统课时
gdb如何抓住卡住的线程
gdb如何抓住卡住的线程
线程“卡住”时,最重要的不是先猜死锁,而是把每个线程此刻停在哪里、谁在等待锁、哪些线程还能继续运行固定下来。本文用一个可复现的双线程死锁演示 gdb 的定位顺序,并说明生产现场如何从调用栈形成可验证的判断。
学习目标
- 用
info threads和thread apply all bt快速获得全局线程快照。 - 从调用栈区分互斥锁等待、条件变量等待和普通业务阻塞。
- 知道何时应停止继续单步,转而检查锁顺序、源码与运行环境。
先制造一个可观察的死锁
下面的程序让两个线程分别先持有一把互斥锁,确认双方都已就绪后,再去申请对方持有的锁。这样死锁可以稳定复现,便于练习 GDB,而不是依赖偶然的线程调度。
#include <atomic>
#include <iostream>
#include <mutex>
#include <thread>

std::mutex m1;
std::mutex m2;
std::atomic<int> ready{0};

void worker1() {
    std::lock_guard<std::mutex> first(m1);
    std::cout << "t1 holds m1" << std::endl;
    ++ready;
    while (ready.load() < 2) {
        std::this_thread::yield();
    }
    // m1 尚未释放,此处继续等待 m2。
    std::lock_guard<std::mutex> second(m2);
}

void worker2() {
    std::lock_guard<std::mutex> first(m2);
    std::cout << "t2 holds m2" << std::endl;
    ++ready;
    while (ready.load() < 2) {
        std::this_thread::yield();
    }
    // 与 worker1 形成相反的加锁顺序。
    std::lock_guard<std::mutex> second(m1);
}

int main() {
    std::thread t1(worker1);
    std::thread t2(worker2);
    t1.join();
    t2.join();
}
预期结果
t1 holds m1
t2 holds m2
<PROGRAM_BLOCKS_HERE>
两条日志顺序可能相反。编译时保留调试符号并关闭优化,避免源码行和栈帧被优化得难以对应。
g++ -std=c++17 -O0 -g -pthread deadlock.cpp -o deadlock && echo build-ok预期输出
build-ok启动 GDB 后运行程序:
gdb -q ./deadlock预期输出
Reading symbols from ./deadlock...
(gdb)
在 GDB 提示符执行 run。两条日志的先后顺序可能相反,随后程序不再退出,这正是待排查状态。
run预期结果
t1 holds m1
t2 holds m2
<PROGRAM_BLOCKS_HERE>
在 GDB 中锁定等待点
程序卡住后按 Ctrl+C 暂停全部线程,先看线程清单,再一次性打印所有线程调用栈。不要一开始就在单个线程里逐帧翻,因为那样容易忽略另一个参与等待关系的线程。
info threads
thread apply all bt
预期结果
Thread <THREAD_ID>:
#0  <LIBC_WAIT_FUNCTION>
#1  pthread_mutex_lock
#2  std::mutex::lock()
#3  worker1()

Thread <THREAD_ID>:
#0  <LIBC_WAIT_FUNCTION>
#1  pthread_mutex_lock
#2  std::mutex::lock()
#3  worker2()
不同 glibc、libstdc++ 和 GDB 版本会显示不同的内部等待函数,真正需要抓住的是两个业务线程都沿着 pthread_mutex_lock 或 std::mutex::lock 向下等待,并分别回到 worker1、worker2 的加锁位置。
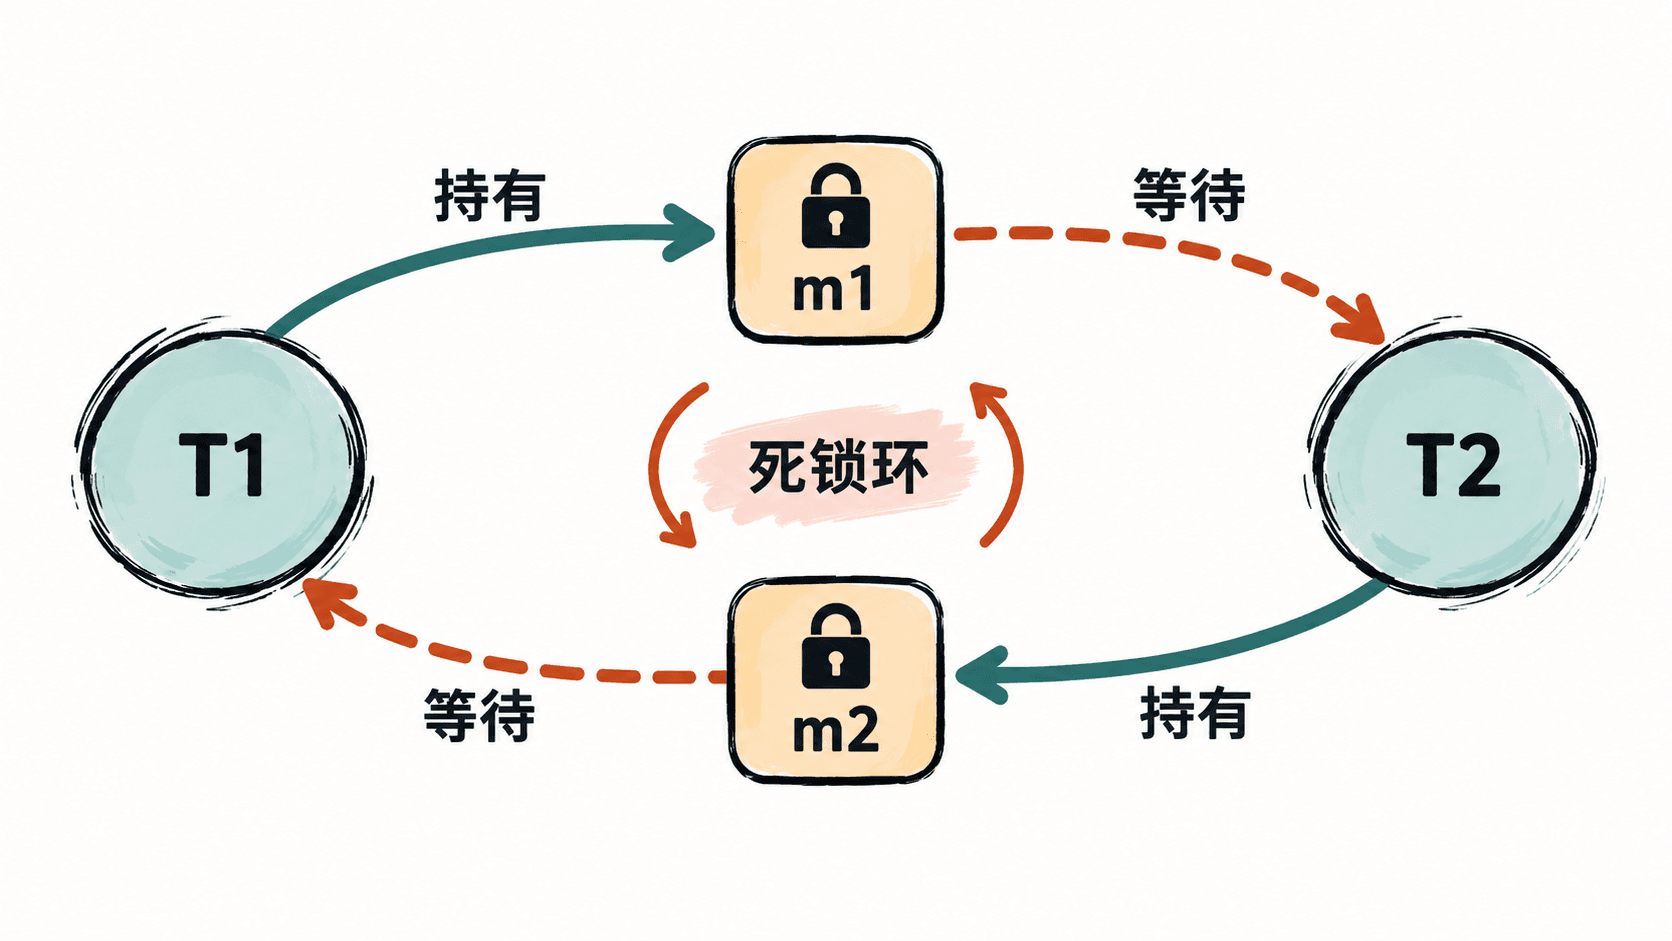
从调用栈判断根因
看到锁函数并不等于已经证明“死锁”。条件变量、线程池空闲线程和正常限流也会长期等待。判断时按下面顺序收敛证据:
- 找出真正停止推进的业务线程,记录它们栈中的第一层业务函数和源码行。
- 查看这些线程是在
pthread_mutex_lock、条件变量等待、I/O 系统调用,还是业务循环中停住。 - 如果有多个线程等待互斥锁,检查各自进入等待前已经持有哪些锁,以及不同代码路径的加锁顺序是否一致。
- 回到源码验证是否存在
m1 -> m2与m2 -> m1这种反向顺序;只有形成等待闭环,才是典型死锁。
对于示例程序,worker1 在持有 m1 时申请 m2,worker2 在持有 m2 时申请 m1,因此调用栈与源码共同构成了死锁证据。修复时应统一加锁顺序,或使用 std::scoped_lock 一次获取多把互斥锁,避免手工制造锁顺序反转。
生产现场的使用边界
线上进程可用 gdb -q -p <PID> 附加,但附加会短暂停止目标进程,并且 Linux 的 ptrace 安全策略可能拒绝操作。高延迟服务上应先确认影响窗口,再抓取线程栈后尽快 detach。如果进程已经崩溃,应优先分析 core dump;如果问题表现为高 CPU 而不是静止等待,perf 往往比 GDB 更适合先找热点。
GDB 最有价值的输出不是“某线程在 futex 里”,而是把等待函数、业务栈、源码锁顺序三者连起来。只有这三层能够互相印证,才应该把问题定性为锁竞争或死锁,而不是正常阻塞。