
C / C++ / 系统课时
从需求开始怎么拆并发模型
从需求开始怎么拆并发模型
并发模型不该从“开几个线程”开始,而要先确认任务是否独立、哪些状态会共享、哪里允许等待,以及结果是否要求有序。本节用多请求处理场景把需求拆成任务边界、线程角色、共享状态和同步点,再用一段可运行代码验证设计。
学习目标
- 从业务约束识别可以并行的工作单元与必须串行的共享状态
- 为接收、处理和汇总划分清晰的线程角色与数据所有权
- 用最少的同步点实现一个可验证的固定工作线程模型
先把需求翻译成并发约束
假设服务一次收到多条计算请求,每条请求之间互不依赖,计算可以并行;最终结果需要按输入顺序返回,同时还要统计已经处理的请求数。这个需求里真正影响并发设计的不是“请求很多”,而是四个约束:任务彼此独立、输入只读、结果顺序固定、计数器被多个线程更新。
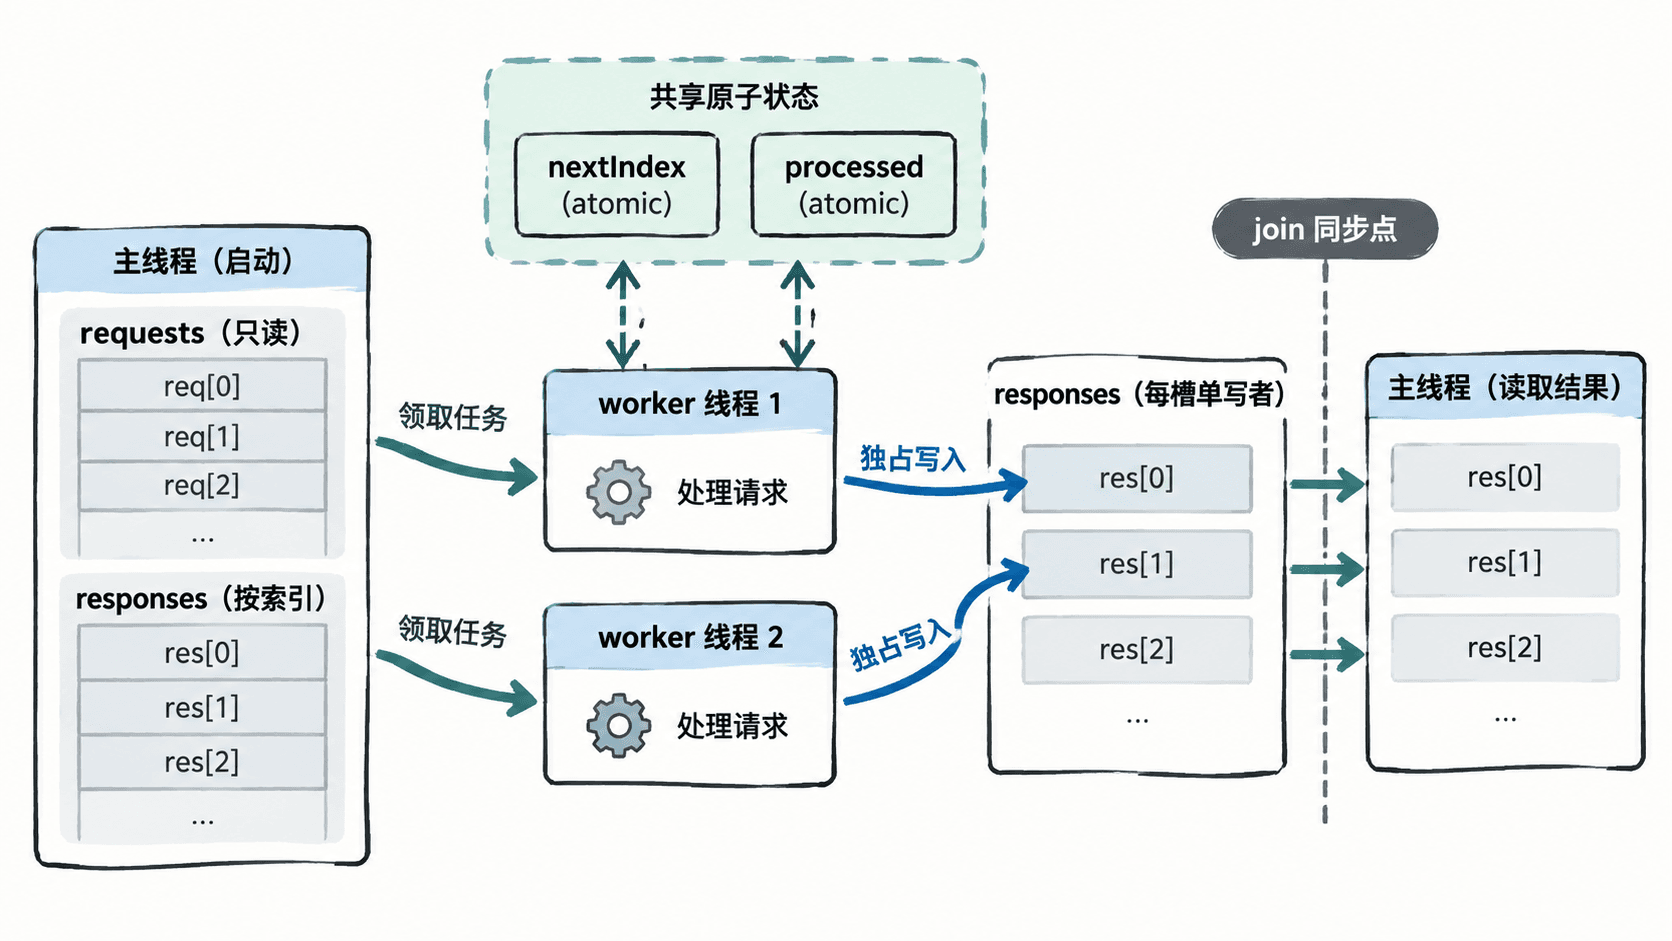
据此可以得到最小模型:主线程准备请求和结果槽位;固定数量的工作线程竞争领取下一个任务;每个任务只写自己对应的结果槽;所有线程共享一个原子下标用于分配任务,并共享一个原子计数器做统计。主线程在 join 之后统一读取结果。
用所有权减少锁而不是到处加锁
共享内存并不意味着每个对象都必须加互斥锁。关键问题是同一时刻是否可能有多个线程访问同一内存位置,并且其中至少一个在写。本例中 requests 在线程启动后只读;responses[i] 只由拿到索引 i 的那个线程写;主线程等所有工作线程 join 后才读取结果,因此这些槽位不需要额外互斥。
真正有并发写入的是“下一个任务编号”和“已处理数量”,所以分别用原子变量保护。这样的设计比把整个请求处理过程包进一把大锁更容易扩展,也更容易解释每个同步点为什么存在。
最小工作线程实现
下面的程序创建两个工作线程。nextIndex.fetch_add(1) 保证同一个请求索引只会被一个线程领取;结果写入固定槽位,因此处理完成的先后顺序不会改变最终输出顺序。
#include <atomic>
#include <chrono>
#include <iostream>
#include <thread>
#include <vector>

struct Request {
    int id;
    int value;
};

struct Response {
    int id;
    int result;
};

int main() {
    const std::vector<Request> requests{
        {101, 2}, {102, 3}, {103, 4}, {104, 5}
    };
    std::vector<Response> responses(requests.size());

    std::atomic<std::size_t> nextIndex{0};
    std::atomic<int> processed{0};

    auto worker = [&] {
        while (true) {
            const std::size_t i = nextIndex.fetch_add(1);
            if (i >= requests.size()) {
                return;
            }

            const Request req = requests[i];
            std::this_thread::sleep_for(std::chrono::milliseconds(20));
            responses[i] = Response{req.id, req.value * req.value};

            // 这个计数只用于统计,不参与结果同步。
            processed.fetch_add(1, std::memory_order_relaxed);
        }
    };

    std::thread first(worker);
    std::thread second(worker);
    first.join();
    second.join();

    for (const Response& response : responses) {
        std::cout << response.id << ": " << response.result << '\n';
    }
    std::cout << "processed=" << processed.load() << '\n';
}
预期输出
101: 4
102: 9
103: 16
104: 25
processed=4工作线程实际领取任务的先后可能变化,但输出仍按请求数组的索引顺序排列。join 也是一个关键同步点:它保证工作线程结束后,主线程再读取各自写好的结果槽。
哪些变化会迫使模型升级
如果需求改成“相同用户的请求必须串行”,任务就不再完全独立,需要按用户键分区或为同一键建立顺序队列。如果多个任务会更新同一个缓存对象,单写者假设也失效,需要互斥锁、分片锁或把更新集中到单独线程处理。
如果请求处理包含长时间网络或磁盘等待,单纯增加 CPU 工作线程可能只是让更多线程一起阻塞。此时应把阻塞 I/O、CPU 计算和结果汇总分开评估,再决定使用更多线程、异步 I/O 或任务队列,而不是直接扩大线程数量。
用四个问题验收设计
落地前可以检查四件事:任务边界是否足够小而且可独立完成;每份可变状态是否有明确所有者;同步点是否只出现在真正共享的位置;线程退出时是否能停止领取新任务并等待已领取任务结束。只要这四个问题能够明确回答,并发模型通常就已经从“凭感觉开线程”变成了可验证的工程设计。