
C / C++ / 系统课时
perf怎么定位并发热点
perf怎么定位并发热点
并发程序出现高 CPU、吞吐下降或延迟抖动时,只看线程数量很难判断时间耗在哪里。perf 可以分别从 CPU 采样和调度事件两条线收集证据:前者回答“CPU 正在执行什么”,后者回答“线程为什么没有及时运行”,两者结合才能区分计算热点、忙等和阻塞竞争。
学习目标
- 用
perf record与perf report找到占用 CPU 的函数热点。 - 用
perf sched timehist观察线程等待、调度延迟和实际运行时间。 - 根据采样与调度证据区分高 CPU 忙等、锁竞争和单纯 CPU 饱和。
先抓 CPU 热点
对正在运行的目标进程采样 10 秒,并记录调用链。-F 99 表示每秒约 99 次采样,避免与固定周期任务产生过强同步;-g 请求保存调用链。
sudo perf record -o perf-cpu.data -F 99 -g -p <PID> -- sleep 10
sudo perf report -i perf-cpu.data --stdio --no-children --sort comm,dso,symbol --percent-limit 1
预期结果
# Overhead  Command  Shared Object  Symbol
<PERCENT>% <COMM> <DSO> <FUNCTION><PID>、函数名和占比都取决于现场。阅读时先看 Overhead 较高的业务函数,再沿调用链判断它属于正常计算、锁实现、原子自旋还是异常重试。采样比例只说明“CPU 时间主要落在哪里”,不能直接说明线程等待了多久。
如果用户态调用链经常缺失,先确认二进制包含符号;对于省略帧指针的优化构建,可考虑使用 --call-graph dwarf 重新采样,但 DWARF 回溯开销通常更高。
再看调度时间
阻塞型锁竞争可能几乎不消耗 CPU,因此只看热点会漏掉问题。可以单独记录调度事件,再用 timehist 查看线程从等待到真正获得 CPU 的时间分布。前面的 CPU 采样已经写到 perf-cpu.data,因此这里可以让调度记录使用默认的 perf.data。
sudo perf sched record -p <PID> -- sleep 10
sudo perf sched timehist -p <PID>
预期结果
time      cpu  task name  wait time  sch delay  run time
<TIME>    <CPU> <COMM>    <WAIT>     <DELAY>    <RUN>
不同 perf 版本的列宽和单位显示可能不同,但核心含义一致:wait time 反映线程在两次运行之间等待了多久,sch delay 反映线程已经可运行却迟迟没有获得 CPU 的时间,run time 表示本次真正运行的时长。
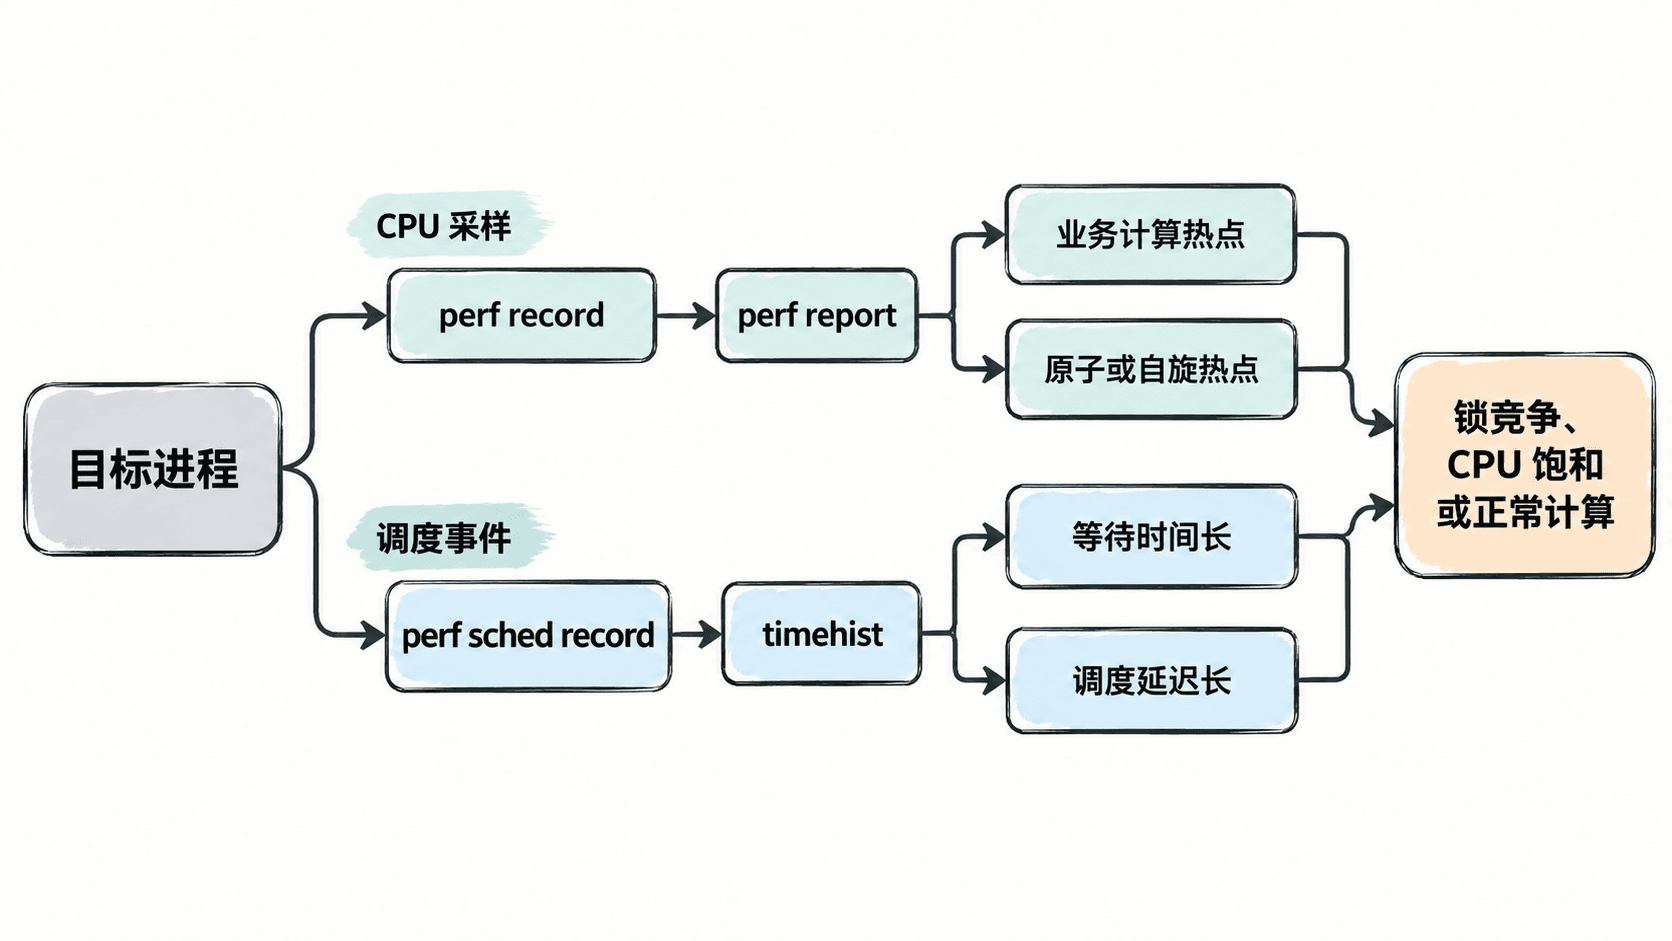
把现象映射到并发问题
出现高 CPU 时,如果 perf report 的主要样本集中在业务计算函数,通常应先优化算法或减少重复工作;如果热点集中在原子操作、自旋锁或反复重试路径,同时线程很多,则更像主动竞争。
另一种情况是进程 CPU 并不高,但吞吐下降。此时 perf report 可能没有明显业务热点,而 timehist 显示某些线程 wait time 很长。它说明线程长期没有运行,但还不能单凭这一列断言是互斥锁;还应结合线程栈、锁实现或业务事件确认等待原因。
如果 sch delay 明显偏大,含义又不同:线程已经处于 runnable 状态,却迟迟拿不到 CPU。这更接近 CPU 过载、绑核不合理或优先级竞争,而不是“线程睡在某把锁上”。
避免把采样结果读错
perf 是采样工具,不是确定性计时器。10 秒窗口只能代表这段时间,短暂尖峰可能需要重复采样;热点占比也会随着负载、编译优化和采样频率变化。
定位并发热点时,最稳妥的顺序是先用 CPU 采样回答“谁在烧 CPU”,再用调度数据回答“谁在等 CPU 或长时间没运行”。当两类证据指向同一段同步路径时,再进入锁粒度、临界区长度、线程数和调度策略的优化,结论会比只看单一热点可靠得多。