
C / C++ / 系统课时
锁竞争为什么会拖慢程序
锁竞争为什么会拖慢程序
多个线程频繁争抢同一把互斥锁时,程序即使没有死锁,也可能因为临界区串行化、阻塞唤醒和调度切换而失去并行收益。本节从竞争发生的位置入手,并用可运行示例验证缩短临界区为什么有效。
学习目标
- 理解高竞争锁如何把并行工作重新变成串行执行
- 区分锁本身的开销与等待、唤醒、上下文切换带来的额外成本
- 使用缩短临界区和拆分共享状态的方法降低竞争
竞争如何把并行变成排队
互斥锁保证同一时刻只有一个线程进入临界区。如果八个工作线程都需要频繁修改同一个共享对象,那么真正能够执行这段代码的仍然只有一个线程,其余线程只能等待。
问题不只是一条加锁指令有成本。竞争激烈时,线程可能从运行态进入等待态;锁释放后又需要被唤醒并重新参与调度。任务越短、加锁越频繁,这些管理成本占总执行时间的比例越高。
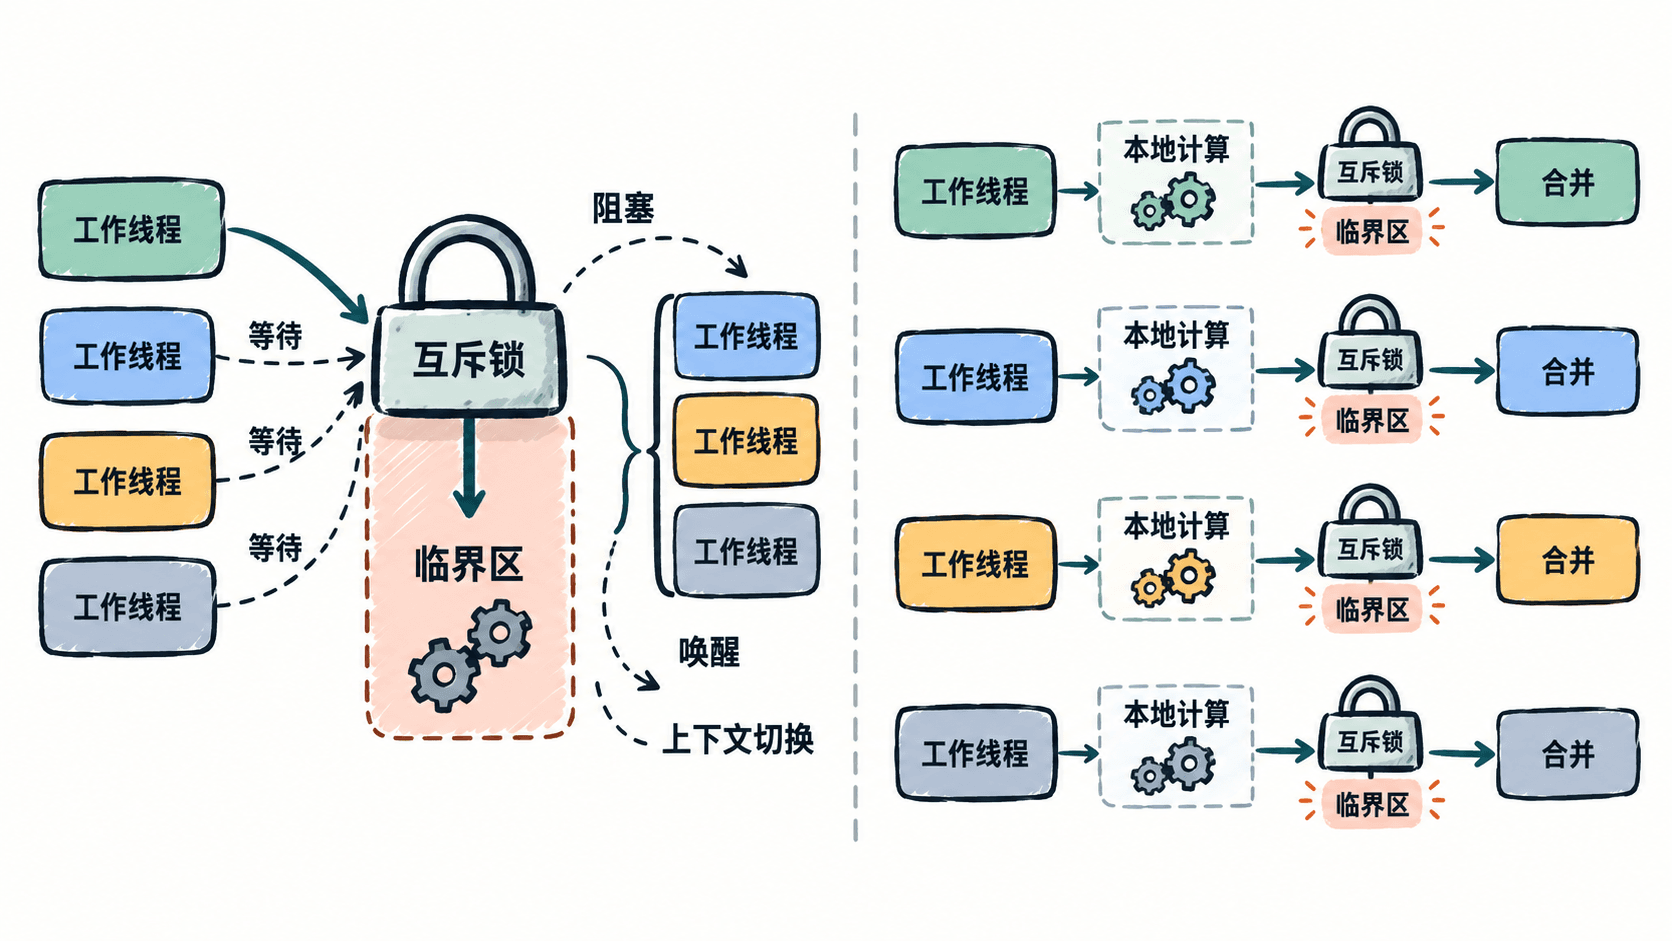
锁竞争通常可以从两个维度判断:一是同一把锁被多少线程同时需要,二是线程持锁多久。竞争线程越多、临界区越长,排队越明显。如果线程持锁期间还进行磁盘、网络或耗时计算,影响会进一步放大。
用一次合并代替反复加锁
下面的程序完成同样的计数任务。第一种方式每次递增都进入共享临界区;第二种方式先在线程本地累计,最后只持锁一次完成合并。
#include <cstdint>
#include <iostream>
#include <mutex>
#include <thread>
#include <vector>

int main() {
    constexpr int kThreads = 8;
    constexpr int kIterations = 100000;

    std::mutex mutex;
    std::uint64_t fineTotal = 0;
    std::vector<std::thread> workers;

    // 高频进入临界区:每次修改共享计数器都需要竞争同一把锁。
    for (int t = 0; t < kThreads; ++t) {
        workers.emplace_back([&] {
            for (int i = 0; i < kIterations; ++i) {
                std::lock_guard<std::mutex> lock(mutex);
                ++fineTotal;
            }
        });
    }
    for (auto& worker : workers) {
        worker.join();
    }

    workers.clear();
    std::uint64_t batchedTotal = 0;

    // 先在线程私有变量中计算,只在最终合并时进入临界区。
    for (int t = 0; t < kThreads; ++t) {
        workers.emplace_back([&] {
            std::uint64_t local = 0;
            for (int i = 0; i < kIterations; ++i) {
                ++local;
            }
            std::lock_guard<std::mutex> lock(mutex);
            batchedTotal += local;
        });
    }
    for (auto& worker : workers) {
        worker.join();
    }

    std::cout << "fine_total=" << fineTotal
              << ", lock_entries=" << kThreads * kIterations << std::endl;
    std::cout << "batched_total=" << batchedTotal
              << ", lock_entries=" << kThreads << std::endl;
}
预期输出:
fine_total=800000, lock_entries=800000
batched_total=800000, lock_entries=8
两种实现得到相同结果,但进入共享临界区的次数从 800000 次降到 8 次。这个例子没有把运行时间作为判断依据,因为具体耗时会受 CPU、编译优化和系统负载影响;真正需要关注的是共享资源访问频率明显下降。
降低竞争的常用策略
首先检查临界区里是否包含与共享状态无关的工作。解析数据、计算中间结果或准备输出通常可以移到锁外,只把读取或提交共享状态的部分留在锁内。
如果不同线程实际上处理彼此独立的数据,可以把一个全局共享对象拆成多个分片,例如按连接、桶或工作线程保存局部状态,再在必要时汇总。这样可以减少所有线程集中争抢同一把锁的情况。
判断优化是否真正有效
优化前后应在相同负载下观察吞吐量、请求延迟、CPU 利用率以及线程阻塞情况。若锁竞争是主要瓶颈,缩短临界区后通常会看到等待减少,同时有效计算占用的 CPU 时间比例提高。
不要为了消除所有锁而破坏数据一致性。正确的目标是让共享范围尽可能小、持锁时间尽可能短,并让本来互不依赖的工作能够真正并行执行。