
C / C++ / 系统课时
memory_order该怎么理解
memory_order该怎么理解
看到 std::memory_order 时,不要先把它理解成“性能档位”。它真正控制的是原子操作之间允许怎样排序,以及一个线程何时能够可靠地看到另一个线程此前写入的数据。掌握这些关系后,才能判断哪里可以用 relaxed,哪里必须建立 acquire/release 同步。
学习目标
- 区分 relaxed、acquire、release 与 seq_cst 分别保证什么
- 理解 release/acquire 如何建立跨线程的可见性关系
- 根据计数、状态发布等场景选择合适的内存序
内存序控制的不只是原子变量
原子操作首先保证目标对象本身不会发生数据竞争,但这并不等于周围的普通内存也自动同步。memory_order 的关键作用,是约束当前原子操作与线程中其他读写之间的顺序,并决定这些读写能否跨线程建立 happens-before 关系。
以“生产者写数据,再通知消费者”为例,真正需要传递的并不是 ready 这个布尔值本身,而是 ready 之前写入的业务数据。
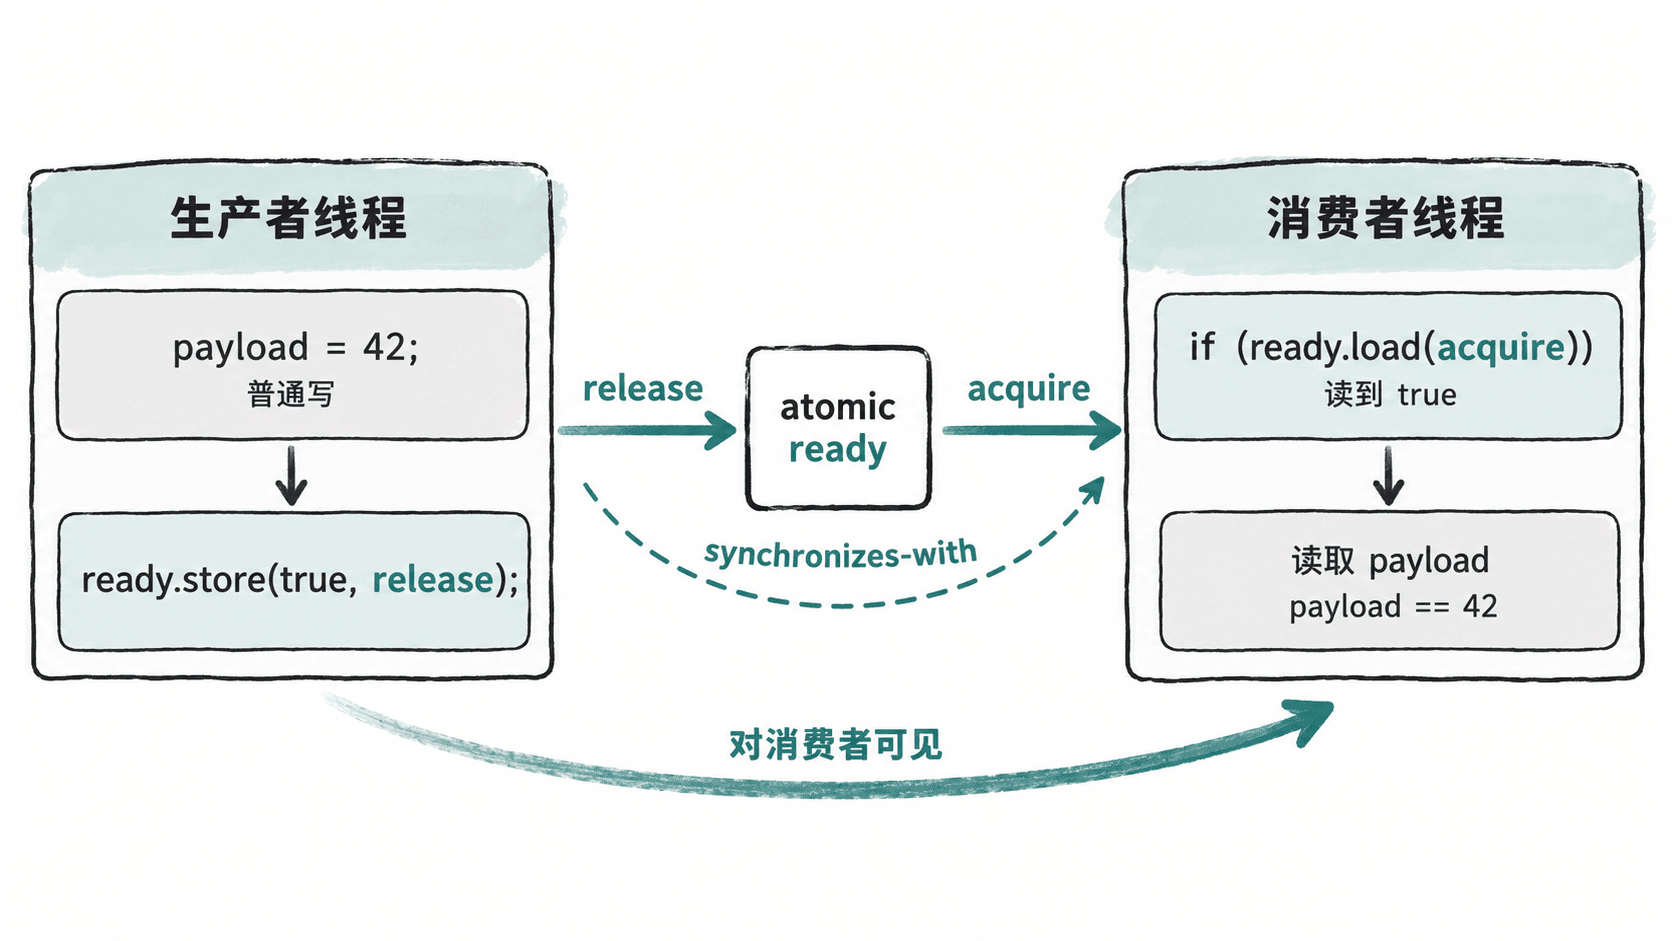
如果消费者的 acquire load 读到了生产者 release store 写入的值,这两个原子操作会建立同步关系。生产者在 release 之前完成的普通写,就能在消费者 acquire 之后安全读取。
四种常用内存序的边界
memory_order_relaxed 只要求这次访问保持原子性,并维持同一个原子对象自身的修改顺序。它适合统计计数、独立序号等“不负责发布其他数据”的场景。
memory_order_release 通常用于写端。它阻止当前线程中位于它之前、需要发布的读写被移动到发布点之后,并可以与对应的 acquire 操作建立同步。
memory_order_acquire 通常用于读端。当它读到相应 release 发布的值后,后续操作可以看到发布线程在 release 之前完成的写入。
memory_order_seq_cst 除了具备相应的 acquire/release 约束,还要求所有 seq_cst 原子操作能够放入一个所有线程一致观察到的全局顺序。它最容易推理,也是默认内存序,但约束通常比实际需求更强。
用 release 和 acquire 发布数据
下面的程序中,payload 本身不是原子变量。它之所以能够被消费者安全读取,是因为对 ready 的 release/acquire 配对建立了跨线程同步。
#include <atomic>
#include <iostream>
#include <thread>

std::atomic<bool> ready{false};
int payload = 0;

void producer() {
    // 先完成普通数据写入,再通过 release 发布完成状态。
    payload = 42;
    ready.store(true, std::memory_order_release);
}

void consumer() {
    // acquire 读到 true 后,能够看到 release 之前的 payload 写入。
    while (!ready.load(std::memory_order_acquire)) {
        std::this_thread::yield();
    }
    std::cout << "payload=" << payload << '\n';
}

int main() {
    std::thread t1(producer);
    std::thread t2(consumer);

    t1.join();
    t2.join();
}
预期输出
payload=42如果把这里的 store 和 load 都改成 memory_order_relaxed,虽然 ready 自身仍然是原子的,但它不再为普通变量 payload 建立所需的同步关系;此时一个线程写 payload、另一个线程读取它会形成未同步的并发访问,程序存在数据竞争。
怎么选择而不是一律降级
选择内存序时,可以先问“这个原子变量是否承担了发布其他数据的职责”。如果只是独立计数,并且计数值之外没有需要一起传递的数据,relaxed 往往就足够。
如果一个线程写完数据后通过原子状态通知另一个线程,典型组合是写端 release、读端 acquire。如果暂时无法证明更弱的顺序仍然正确,使用默认的 seq_cst 通常比为了性能直接改成 relaxed 更安全。
内存序优化的前提始终是先证明同步关系正确,再判断约束是否可以变弱。把 memory_order 当作可见性与排序协议,而不是简单的“快慢开关”,通常更容易写出可验证的并发代码。