
C / C++ / 系统课时
为什么不能每个任务都创建线程
为什么不能每个任务都创建线程
为每个短任务直接创建一个线程看起来最简单,但任务数量增长后,线程创建与销毁、栈和内核资源、调度切换都会成为额外负担。线程池通过复用固定数量的工作线程,把任务数量与并发线程数量分离开。
学习目标
- 理解按任务创建线程在高并发下产生的资源与调度成本
- 明确任务数量和实际并行线程数量为什么不应该一一对应
- 理解线程池通过固定工作线程和任务队列解决什么问题
一个任务一个线程的问题
在主流 C++ 实现中,std::thread 通常对应原生操作系统线程。创建线程需要建立线程运行所需的数据结构和栈空间,退出时还需要回收这些资源。对于运行几毫秒的任务,线程管理成本可能已经不可忽略。
线程数量超过可用 CPU 核心后,并不会凭空增加计算能力。大量可运行线程需要轮流获得 CPU,调度器必须不断保存和恢复执行上下文。对于 CPU 密集型任务,过多线程甚至可能降低吞吐量。
线程栈还会消耗虚拟地址空间及相关系统资源。栈的预留空间并不等于全部立即占用物理内存,但线程数量持续增长仍然会受到进程和操作系统资源上限约束。
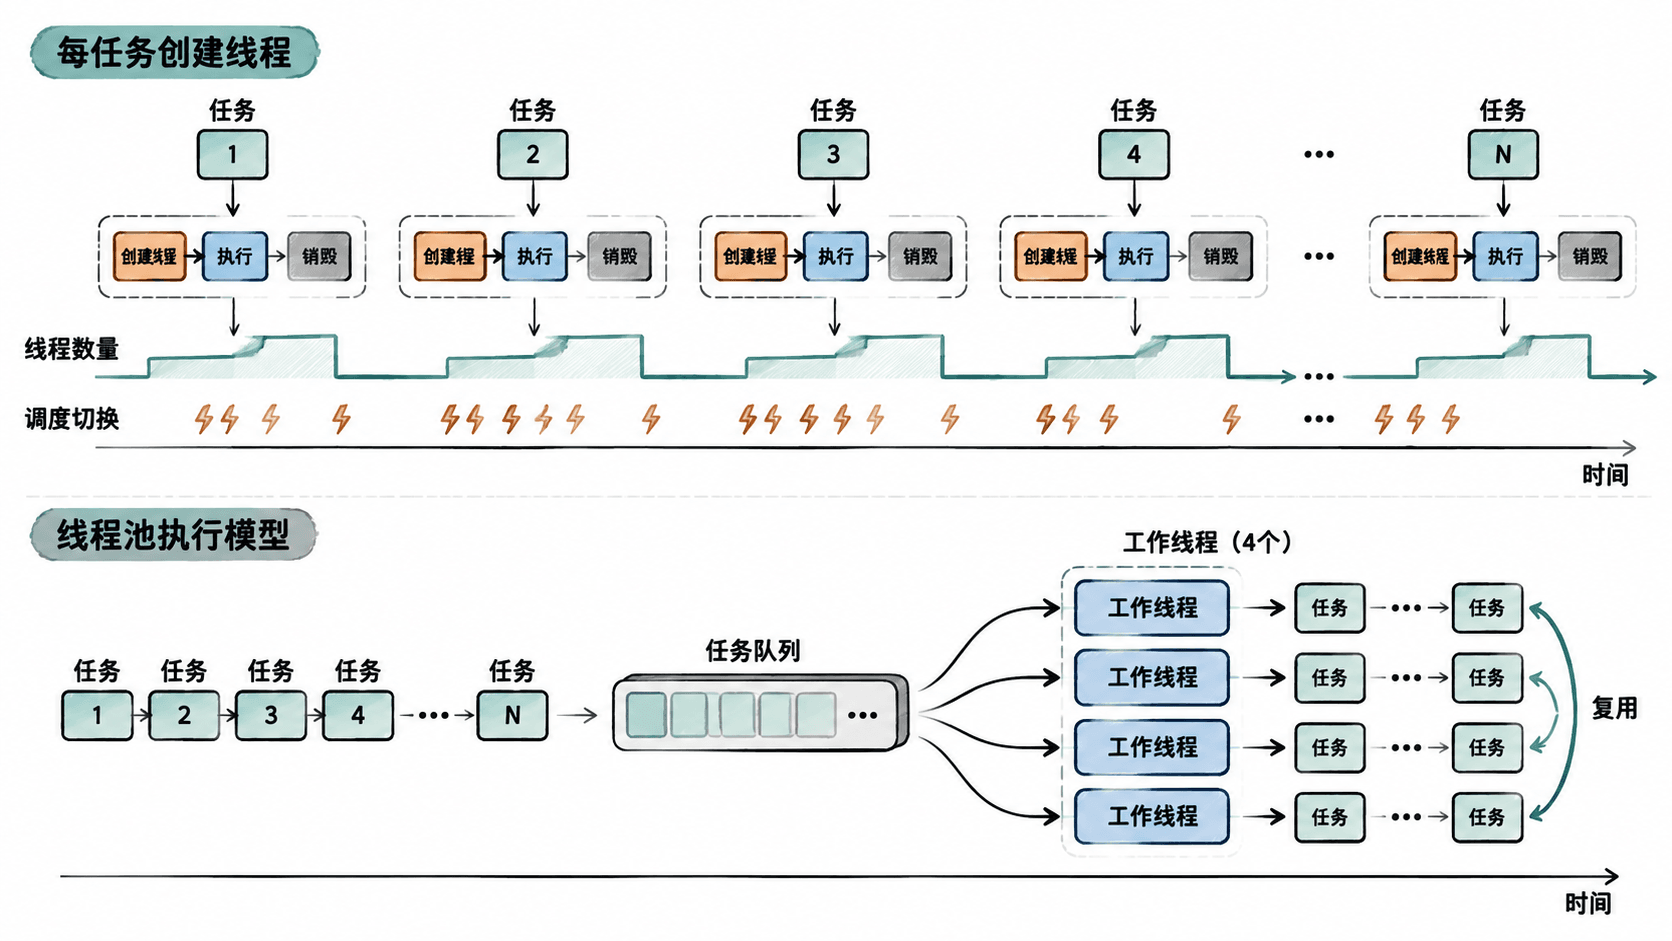
用固定工作线程处理多项任务
下面用 64 个短任务对比两种组织方式。第一阶段创建 64 个线程;第二阶段只创建 4 个工作线程,让它们反复取得下一个任务。示例用原子索引代替正式任务队列,目的是只观察线程数量如何被限制。
#include <atomic>
#include <chrono>
#include <iostream>
#include <thread>
#include <vector>

void doTask() {
    std::this_thread::sleep_for(std::chrono::milliseconds(5));
}

int main() {
    constexpr int kTasks = 64;
    constexpr int kWorkers = 4;

    std::atomic<int> directCompleted{0};
    std::vector<std::thread> threads;

    // 每个任务创建一个线程,任务数直接决定线程数。
    for (int i = 0; i < kTasks; ++i) {
        threads.emplace_back([&] {
            doTask();
            ++directCompleted;
        });
    }
    for (auto& thread : threads) {
        thread.join();
    }

    std::atomic<int> nextTask{0};
    std::atomic<int> pooledCompleted{0};
    threads.clear();

    // 固定数量的工作线程重复取得任务,模拟线程池的核心执行方式。
    for (int i = 0; i < kWorkers; ++i) {
        threads.emplace_back([&] {
            while (true) {
                const int task = nextTask.fetch_add(1);
                if (task >= kTasks) {
                    break;
                }
                doTask();
                ++pooledCompleted;
            }
        });
    }
    for (auto& thread : threads) {
        thread.join();
    }

    std::cout << "per_task_threads=" << kTasks
              << ", completed=" << directCompleted.load() << std::endl;
    std::cout << "pooled_workers=" << kWorkers
              << ", completed=" << pooledCompleted.load() << std::endl;
}
预期输出:
per_task_threads=64, completed=64
pooled_workers=4, completed=64
两种方式都完成 64 个任务,但第二种方式只需要 4 个长期存在的工作线程。真正的线程池通常会把待执行工作放进线程安全的任务队列,并让空闲工作线程在条件变量等同步机制上等待新任务。
线程池真正控制的是并发度
线程池不是为了让所有任务同时运行,而是为了限制同时运行的线程数量。假设瞬间到来一万个任务,可以让任务先排队,而不是立即创建一万个线程。这样系统资源消耗由工作线程数量决定,而不是由突发任务数量直接决定。
对 CPU 密集型工作,工作线程数量通常围绕可用 CPU 并行度选择,再通过实测调整。对包含阻塞 I/O 的任务,可以允许更多工作线程,但仍应设置明确上限,避免下游变慢时线程数量失控。
线程池还能够集中处理任务取消、异常、关闭和背压等问题。任务生产速度长期高于处理速度时,真正需要解决的是队列持续增长,而不是继续增加线程掩盖容量不足。
哪些任务不值得单独创建线程
生命周期很短、数量可能突发增长,并且彼此执行方式相似的任务,通常更适合提交给线程池。服务端请求处理、批量小计算和后台作业都是常见场景。
如果程序只需要启动少量长期线程,并且这些线程拥有明确职责,例如专用事件循环或设备采集线程,直接管理线程反而可能更简单。关键不是禁止使用 std::thread,而是避免让任务数量无上限地决定线程数量。