
C / C++ / 系统课时
死锁现场应该先看什么
死锁现场应该先看什么
线程卡住但进程没有退出时,最重要的不是先翻日志,而是先保存“谁在等谁”的现场。本节建立一条可复用的死锁排查顺序:确认线程是否阻塞,抓取全部线程调用栈,识别锁等待关系,再把循环等待映射回具体代码位置。
学习目标
- 能用 Linux 线程视图区分阻塞、运行和忙等线程
- 能通过 GDB 全线程调用栈定位锁等待位置
- 能从“持有锁 → 等待锁”关系识别死锁环并验证修复
先确认是不是锁等待
死锁的典型现象是业务不再推进,但进程仍存活,部分线程长期停在互斥锁、条件变量或 futex 等待路径。第一步应查看线程级状态,而不是只看进程级 CPU 使用率。
先找到目标进程,再查看其线程状态与内核等待点:
PID="$(pgrep -n deadlock-demo)"
ps -L -p "$PID" -o pid,tid,stat,wchan:32,comm
预期输出
  PID   TID STAT WCHAN                            COMMAND
 <PID> <TID> Sl   futex_wait_queue_me             deadlock-demo
 <PID> <TID> Sl   futex_wait_queue_me             deadlock-demo
 <PID> <TID> Sl   futex_wait_queue_me             deadlock-demo
WCHAN 名称受内核版本和调试信息影响,实际值可能不同。关键不是必须看到某个固定函数名,而是多个线程是否长期停在等待路径。如果线程持续占满 CPU,则更像自旋、死循环或活锁,排查方向应先转向热点线程。
抓全线程调用栈
只看一个线程的栈很容易漏掉循环等待。对死锁现场,应一次性抓取全部线程,让“等待点”和调用者同时保留下来。示例程序使用两个互斥量构造确定性的循环等待:
#include <atomic>
#include <cstdio>
#include <mutex>
#include <thread>

std::mutex mutex_a;
std::mutex mutex_b;
std::atomic<int> ready{0};

void worker_a() {
    std::lock_guard<std::mutex> first(mutex_a);
    std::puts("worker_a holds mutex_a");
    ++ready;
    while (ready.load() < 2) {
        std::this_thread::yield();
    }
    std::lock_guard<std::mutex> second(mutex_b);
}

void worker_b() {
    std::lock_guard<std::mutex> first(mutex_b);
    std::puts("worker_b holds mutex_b");
    ++ready;
    while (ready.load() < 2) {
        std::this_thread::yield();
    }
    std::lock_guard<std::mutex> second(mutex_a);
}

int main() {
    std::thread a(worker_a);
    std::thread b(worker_b);
    a.join();
    b.join();
}
预期结果
worker_a holds mutex_a
worker_b holds mutex_b
<以上两行顺序可能互换;程序随后不再退出>
保存为 deadlock-demo.cpp 后编译并运行:
g++ -std=c++17 -O0 -g -pthread deadlock-demo.cpp -o deadlock-demo
./deadlock-demo
预期输出
worker_a holds mutex_a
worker_b holds mutex_b
<以上两行顺序可能互换;进程保持运行,等待人工终止>
另开终端附加 GDB,并打印所有线程栈:
PID="$(pgrep -n deadlock-demo)"
gdb -q -p "$PID"   -ex "set pagination off"   -ex "info threads"   -ex "thread apply all bt"   -ex "detach"   -ex "quit"
预期输出
<可见主线程停在 join 等待路径>
<一个工作线程停在 worker_a 中获取 mutex_b 的位置>
<另一个工作线程停在 worker_b 中获取 mutex_a 的位置>
具体函数帧会随 libstdc++、glibc 和编译器版本变化,但使用 -g -O0 编译后,应能在回溯中看到 worker_a、worker_b 及对应源码位置。生产环境若缺少符号,先保存 core 或现场信息,再补齐与二进制匹配的调试符号分析。
从调用栈还原等待关系
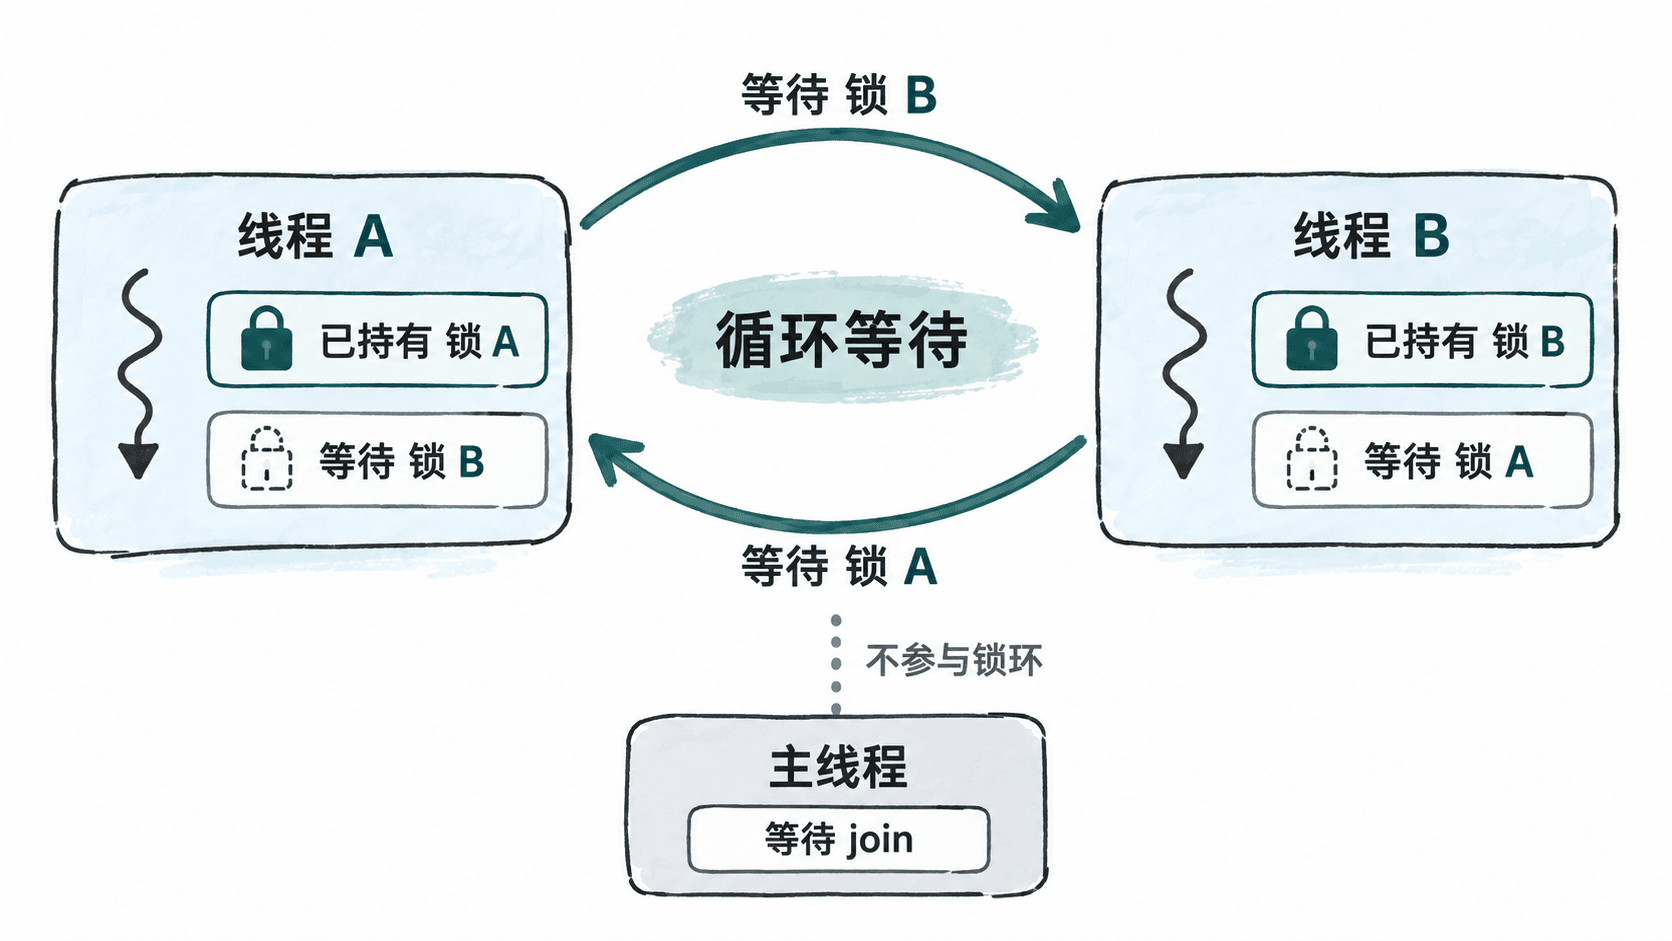
排查时把每个阻塞线程写成“线程 → 当前持有的锁 → 正在等待的锁”。如果最终形成闭环,就满足死锁的循环等待条件。示例中关系可以还原为:
worker_a:持有mutex_a,等待mutex_bworker_b:持有mutex_b,等待mutex_a- 主线程:等待两个工作线程结束,本身不是锁环的一部分
调用栈能告诉你“线程卡在哪里”,但不一定直接告诉你“锁由谁持有”。如果现场复杂,可结合源码中的加锁顺序、锁对象地址、core dump,以及调试器对互斥量内部状态的观察来补全关系。不要仅凭某个线程停在 pthread_mutex_lock 就断言它是根因。
修复时先消除锁顺序不一致
最稳妥的修复通常不是增加超时,而是让多个线程按同一顺序获取多把锁。C++17 可以用 std::scoped_lock 一次管理多个互斥量,避免手写相反顺序:
void safe_worker() {
    std::scoped_lock lock(mutex_a, mutex_b);
    // 同时持有两把锁后再访问受保护的数据。
}
预期结果
多个线程调用 safe_worker 时,不会因为 mutex_a 与 mutex_b 的获取顺序相反而形成该循环等待。修复后应重复压力测试,并再次抓取线程状态确认不再长期停在同一组锁等待点。对于偶发死锁,保留带时间戳的线程 dump 或 core 比反复增加日志更有价值,因为锁环必须依赖同一时刻的全局现场才能可靠还原。