
C / C++ / 系统课时
happens-before在代码里怎么找
happens-before在代码里怎么找
分析并发代码时,happens-before 不需要靠猜测线程实际先后运行。更可靠的方法是先找每个线程内部的顺序,再寻找锁、原子操作和线程生命周期产生的跨线程同步边,最后利用传递性判断冲突读写是否已经被排序。
学习目标
- 按固定步骤从代码中定位 happens-before 关系
- 识别 mutex、release/acquire、线程启动与 join 产生的同步边
- 根据传递关系判断一组共享读写是否存在数据竞争
先从冲突访问开始找
面对一段并发代码,不必先画所有语句。先找到真正需要证明安全的共享对象:哪些线程访问了它,哪些访问是写操作。如果同一内存位置存在跨线程冲突访问,就尝试从写操作沿着顺序边和同步边一路走到读操作。
可以按下面的顺序检查:
- 标出目标共享变量的写和读。
- 在线程内部连接明确的 sequenced-before 顺序。
- 寻找 mutex、原子操作、线程启动和
join()等产生的 synchronizes-with 边。 - 利用 happens-before 的传递性把多段关系连接起来。
- 如果两个冲突的非原子访问仍无法排序,就应继续寻找数据竞争,而不是根据日志时间推断安全性。
常见同步边怎么识别
| 代码结构 | 可以寻找的跨线程关系 | 常见用途 |
|---|---|---|
mutex.unlock() 与之后成功的 mutex.lock() |
前一次解锁 synchronizes-with 后一次成功加锁 | 保护临界区中的普通数据 |
| release 原子写与读取到它的 acquire 原子读 | release synchronizes-with acquire | 发布数据、状态或指针 |
std::thread 启动 |
线程构造阶段与新线程函数开始之间存在标准规定的同步关系 | 把启动前准备的数据交给新线程 |
线程结束与成功返回的 join() |
工作线程完成 synchronizes-with join() 返回 |
在等待完成后读取工作线程结果 |
需要特别注意“读取到它”这个条件。看到一边使用 release、另一边使用 acquire,并不能自动断言二者同步;必须确认 acquire 操作观察到了能与该 release 建立相应关系的原子值。
把多条边连接成一条路径
下面的关系同时涉及主线程、生产线程和消费线程。主线程先准备 seed 再创建生产线程;生产线程计算普通变量 payload,随后通过 release store 发布;消费线程的 acquire load 观察到发布后读取 payload;最后主线程等待消费线程结束再使用 result。
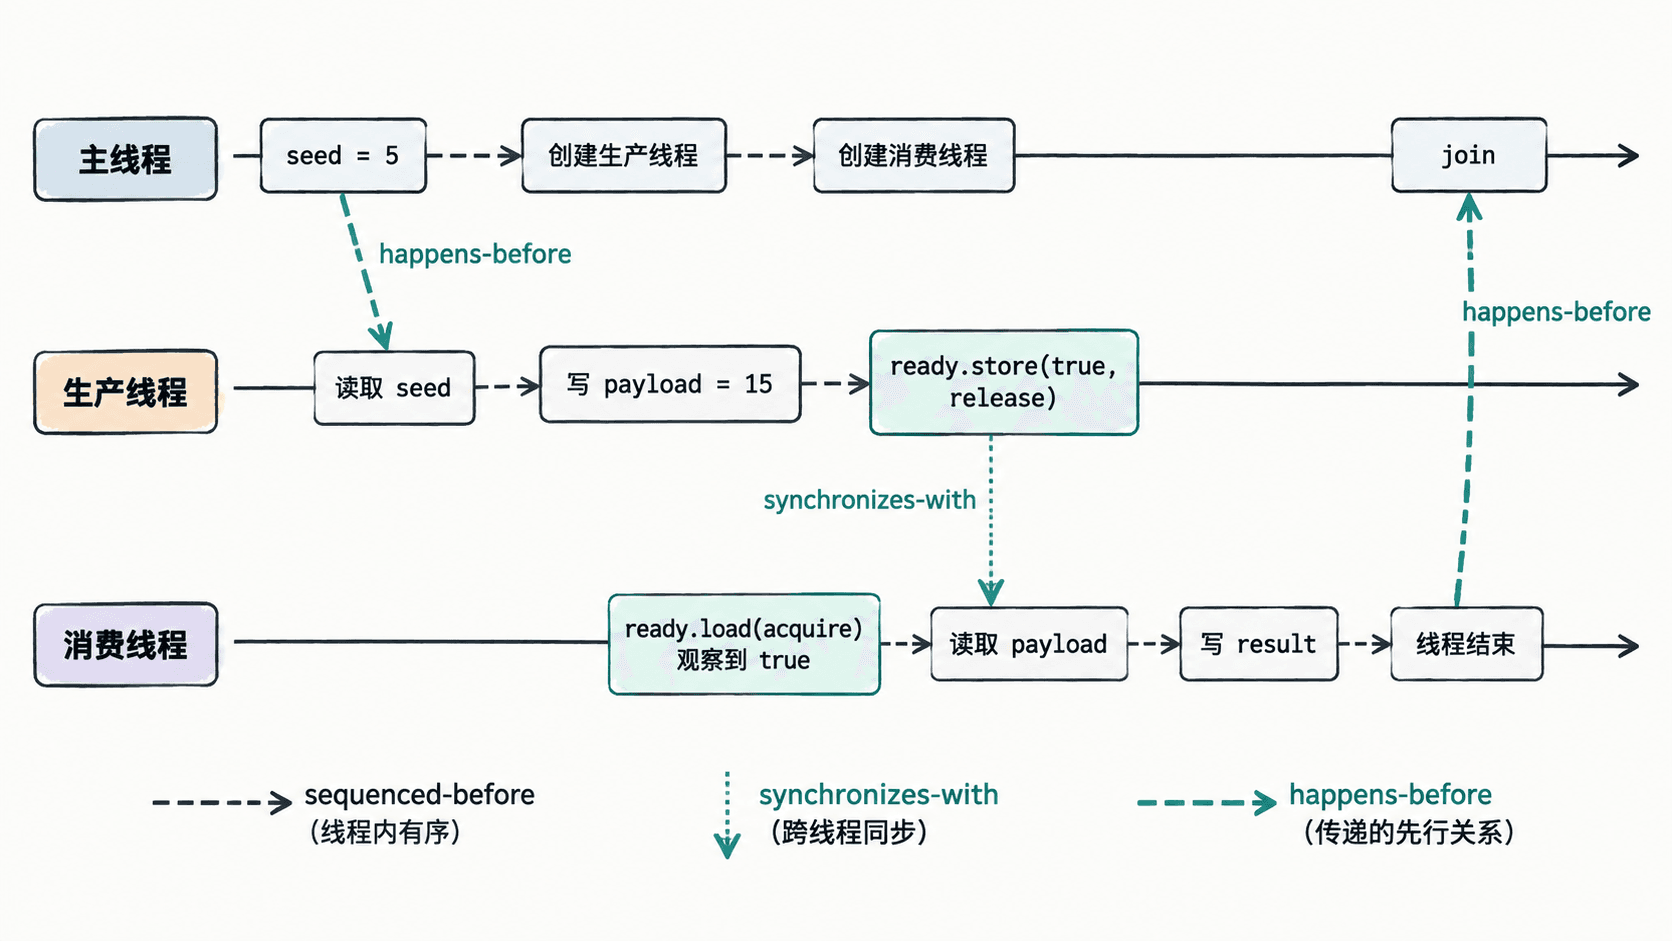
这类图的价值不是表现真实调度时间,而是检查是否存在一条由标准保证的有向路径。只要目标写操作能够沿 happens-before 路径到达目标读操作,就可以据此判断相应顺序受到语言内存模型约束。
在完整代码中验证路径
下面的程序把几种关系串在一起。seed 在创建线程前已经写好;生产线程通过 release/acquire 发布 payload;消费线程结束后,主线程通过 join() 再读取 result。
#include <atomic>
#include <iostream>
#include <thread>

int main() {
    int seed = 5;
    int payload = 0;
    int result = 0;
    std::atomic<bool> ready{false};

    std::thread producer([&] {
        payload = seed * 3;
        ready.store(true, std::memory_order_release);
    });

    std::thread consumer([&] {
        while (!ready.load(std::memory_order_acquire)) {
            std::this_thread::yield();
        }
        result = payload;  // acquire 后读取已发布的普通数据
    });

    producer.join();
    consumer.join();
    // consumer 完成 happens-before join 返回,因此这里可读取 result
    std::cout << result << '\n';
}
预期输出
15从 payload = seed * 3 到 result = payload,路径是“线程内顺序 → release/acquire 同步边 → 线程内顺序”。从 result = payload 到主线程输出,则经过“消费线程完成 → consumer.join() 返回”。因此这些普通变量虽然不是原子对象,仍可以在已经建立的 happens-before 关系下安全访问。
锁也按同样方法分析
互斥锁并不是因为“同一时刻只有一个线程进入”就自动解决所有可见性问题。真正可用于内存模型推导的是:对同一 mutex 的一次解锁,会与之后成功取得该 mutex 的加锁建立同步关系。临界区内解锁前的写入,因此能够有序到后续获得锁之后的读取。
分析锁保护的数据时,要确认读写确实都处于同一同步协议中。如果写线程持锁修改对象,而读线程绕过锁直接访问普通对象,那么互斥锁无法为这次直接读取补出 happens-before 路径。
最终可以把 happens-before 当成一次图搜索:节点是需要关心的读写与同步操作,线程内顺序和标准规定的同步关系是有向边。能从写走到读,就有顺序保证;走不到时,再好的运行日志和“通常先执行”都不能替代缺失的同步关系。