
P2P 与分布式存储 / 系统课时
读懂 v2 的 Merkle 文件树
读懂 v2 的 Merkle 文件树
BitTorrent v2 不再使用 v1 那种覆盖整个资源的连续 SHA-1 分块哈希列表,而是按文件构建 SHA-256 Merkle 树。本课通过一个具体的文件集合,拆解 BEP 52 的 file tree、pieces root、piece layers 与 info hash,学会判断元数据如何对应实际文件并验证下载数据。
学习目标
- 读懂 v2 文件树中的路径、文件长度与 pieces root。
- 解释 SHA-256 Merkle 树如何生成文件根哈希及 Piece 验证信息。
- 区分 v1、纯 v2 与 hybrid 种子的资源标识和兼容性。
从 v1 哈希列表到 v2 文件树
v1 种子的 info 字典通常包含 piece length、pieces,以及单文件的 length 或多文件的 files。其中 pieces 是按整个资源的连续字节流计算的 SHA-1 摘要串,每个摘要占 20 字节。
v2 则要求 info 字典包含 meta version = 2 和 file tree。文件树以路径组件为字典键,逐层表示目录,最终在文件节点的空字符串键 "" 下存放文件属性。每个非空文件通常具有 length 与 32 字节的 pieces root。
例如,资源目录中有 docs/readme.txt(1000 字节)和 data/sample.bin(32768 字节),v2 的逻辑结构是根目录下两个子目录,各自包含一个文件叶节点。文件哈希分别计算,文件之间不会拼接成同一条哈希输入流。
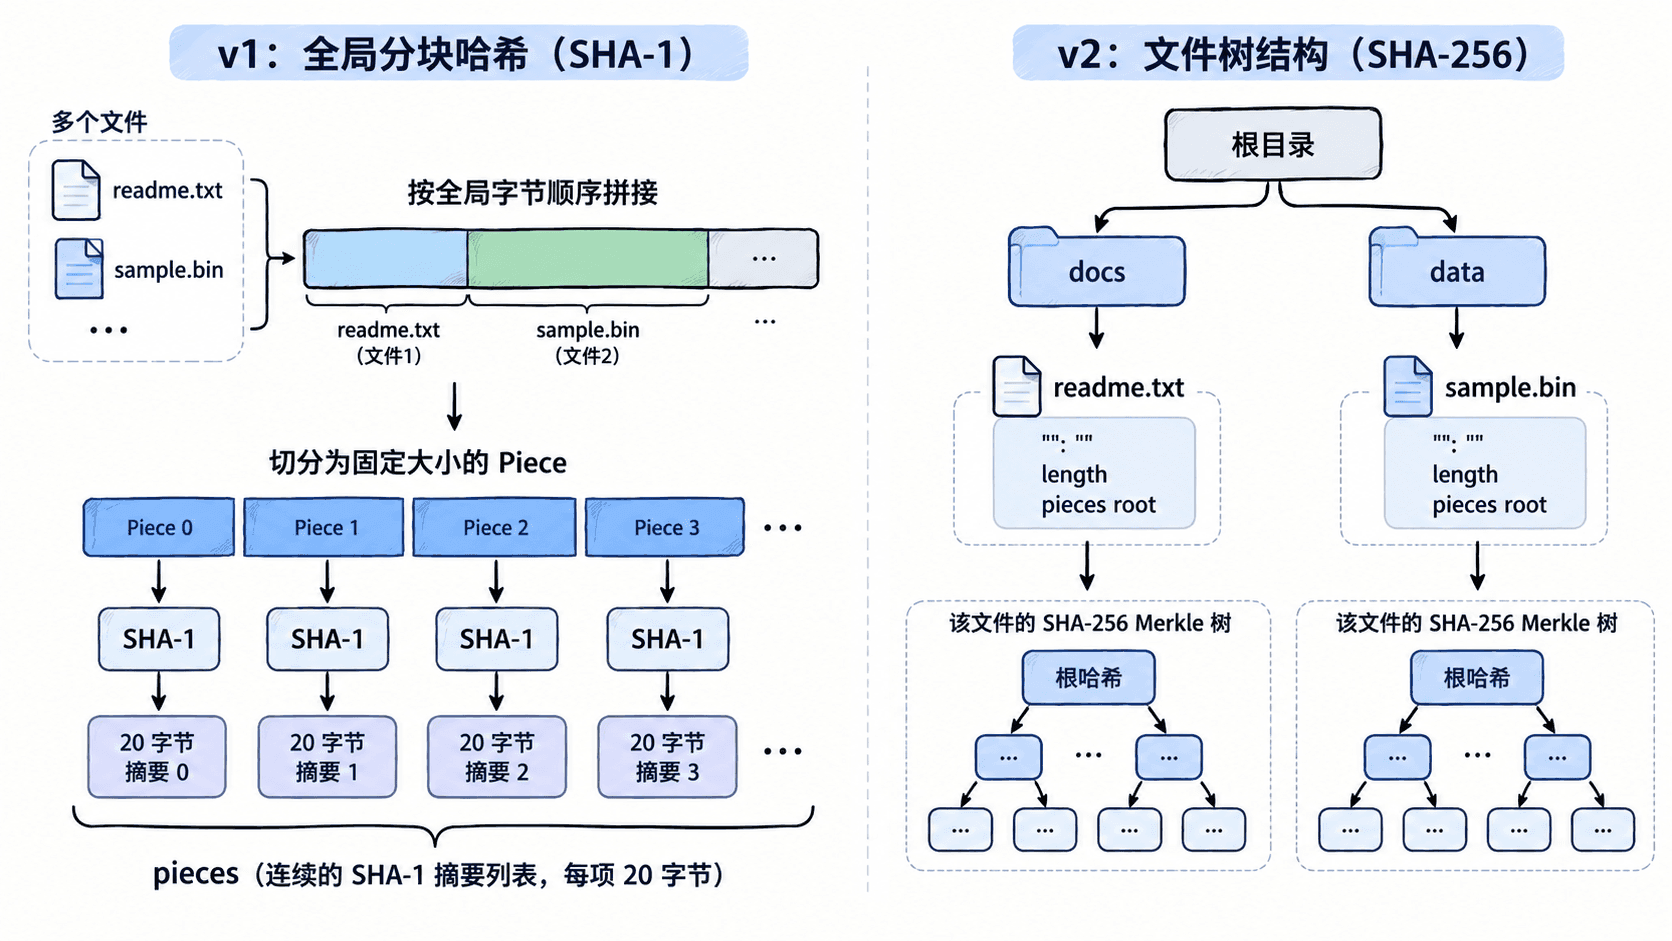
这里要区分两种树:file tree 是组织文件路径的字典树,Merkle 树是验证某个文件内容的哈希树。前者回答文件在哪里,后者回答文件内容是否正确。
SHA-256 Merkle 根怎样计算
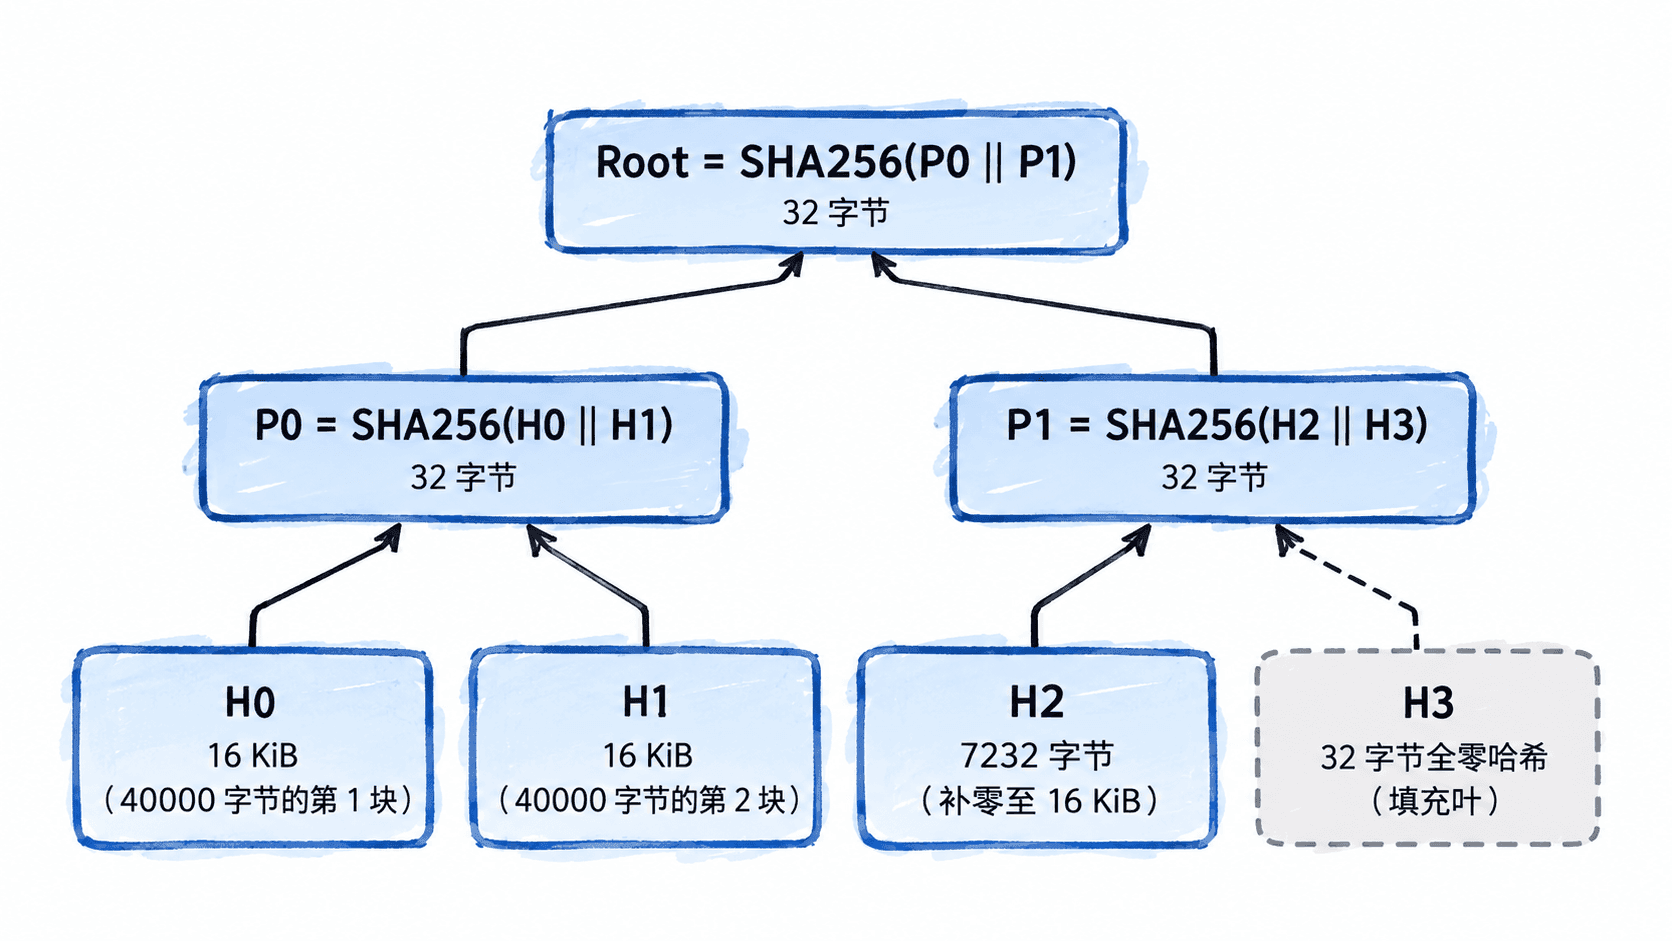
BEP 52 将文件内容按 16 KiB(16384 字节)的叶块计算 SHA-256。对于不足 16 KiB 的最后一个叶块,先补零至 16 KiB,再计算叶哈希。文件叶块数向上补齐到二的幂,缺失叶位置使用全零的 32 字节哈希作为填充叶;内部节点计算左右两个 32 字节子哈希拼接后的 SHA-256。
以长度为 40000 字节的文件为例,它包含三个实际叶块,第四个位置为全零哈希填充叶:
- 计算前三个实际叶块的 SHA-256,得到 H0、H1、H2。
- 设 H3 为 32 字节全零哈希。
- 计算 P0 = SHA256(H0 || H1),P1 = SHA256(H2 || H3)。
- 计算 Root = SHA256(P0 || P1),将结果作为文件的
pieces root。
其中 || 表示字节拼接,不是字符串拼接。零填充叶也不能与真实的全零数据块混为一谈。
下面的 Python 3 示例计算这个文件的根哈希。使用确定性的 40000 字节测试数据,便于重复运行与修改。
import hashlib

LEAF_SIZE = 16 * 1024
ZERO_HASH = bytes(32)

def merkle_root(data: bytes) -> bytes:
    if not data:
        return ZERO_HASH

    leaves = []
    for offset in range(0, len(data), LEAF_SIZE):
        block = data[offset:offset + LEAF_SIZE]
        # 最后一个实际数据叶块补齐到16KiB
        block = block.ljust(LEAF_SIZE, b"\x00")
        leaves.append(hashlib.sha256(block).digest())

    # 填充缺失的树叶位置,不对零哈希再次做SHA-256
    target = 1 << (len(leaves) - 1).bit_length()
    leaves.extend([ZERO_HASH] * (target - len(leaves)))

    while len(leaves) > 1:
        leaves = [
            hashlib.sha256(leaves[i] + leaves[i + 1]).digest()
            for i in range(0, len(leaves), 2)
        ]
    return leaves[0]

data = bytes(i % 256 for i in range(40000))
root = merkle_root(data)
print("文件字节数:", len(data))
print("叶块数:", (len(data) + LEAF_SIZE - 1) // LEAF_SIZE)
print("根哈希字节数:", len(root))
print("重复计算一致:", root == merkle_root(data))
预期输出:
文件字节数: 40000
叶块数: 3
根哈希字节数: 32
重复计算一致: True
这是演示 Merkle 根计算的最小实现,不是完整的 .torrent 解析器。空文件根哈希为全零的 32 字节值,实际 v2 文件树中的空文件不需要存储 pieces root。真实客户端还需要处理 Bencode 原始字节、路径安全、文件属性与完整的分块验证。
Piece Layers 怎样支持局部验证
Merkle 根可以证明整份文件的内容,但下载客户端需要逐 Piece 验证。BEP 52 使用 piece length 定义 Piece 大小,它必须是至少 16 KiB 的二的幂;每个 Piece 对应若干个 16 KiB 叶块。
假设 piece length = 32768 字节,即每个 Piece 对应两个叶块。对于前述 40000 字节文件:
| 项目 | 结果 |
|---|---|
| 文件长度 | 40000 字节 |
| 叶块数量 | 3 个实际叶块 |
| Piece 0 | 字节 0~32767 |
| Piece 1 | 字节 32768~39999 |
| Piece 层哈希 | P0、P1 |
| 文件根哈希 | SHA256(P0 |
当文件长度超过一个 Piece 时,种子顶层的 piece layers 字典可以用该文件的 pieces root 作为二进制键,值为按顺序拼接的 Piece 层 32 字节哈希。这里的 P0、P1 就构成示例文件的 Piece Layer,客户端能够用它们分别检查两个 Piece,并验证这一层与文件根一致。
对于长度不超过一个 Piece 的文件,不需要单独的 Piece Layer:文件的 pieces root 已足以表示其对应的验证根。不要把 piece layers 当成每个文件必有的字段,也不要把它放进 info 字典内部。
v2 Info Hash 与 Magnet 资源标识
纯 v2 种子的资源标识是对 info 字典原始 Bencode 字节计算 SHA-256,结果长度为 32 字节。它与文件的 pieces root 不同:前者标识整份种子资源的元数据,后者验证单个文件的内容。
可以用下面的 Python 3 代码验证哈希算法与输出长度。这里采用一个已经编码好的示例 info 字典,仅演示原始字节哈希;它不包含 BEP 52 所要求的完整 v2 字段,因此不能作为有效 v2 种子使用。
import hashlib

# 演示原始Bencode字节的哈希,实际应提取完整info字节范围
info_bytes = b"d4:name4:demoe"
info_hash = hashlib.sha256(info_bytes).digest()
print("SHA-256摘要字节数:", len(info_hash))
print("十六进制字符数:", len(info_hash.hex()))
预期输出:
SHA-256摘要字节数: 32
十六进制字符数: 64
v2 Magnet 链接通常使用 xt=urn:btmh:,后接表示 SHA2-256 多重哈希的 multihash 编码。常见十六进制形式以 1220 开头,其中 12 是 SHA2-256 的多重哈希算法代码,20 表示摘要长度为 32 字节;后面才是 64 个十六进制字符的 SHA-256 摘要。
相比之下,v1 常用 xt=urn:btih: 表示 SHA-1 info hash。不能把 v2 的 32 字节 SHA-256 摘要截断为 20 字节后当成 v1 标识。
Hybrid 种子与实际解析检查
Hybrid 种子同时携带 v1 和 v2 所需的元数据,使支持不同协议版本的客户端能够识别对应资源。它可以有不同的 v1 SHA-1 info hash 与 v2 SHA-256 info hash;两者并非相互转换的结果。
检查一个真实 .torrent 文件时,建议按以下顺序进行:
- Bencode 解码顶层字典,并保留
info的原始编码字节范围。 - 查看
info是否存在整数值为 2 的meta version和file tree。 - 递归遍历
file tree,将路径组件组合为文件路径,读取叶节点""下的length与非空文件的pieces root。 - 检查
piece length是否满足 16 KiB 及二的幂约束,结合文件长度确定 Piece 数量。 - 对超过一个 Piece 的文件,查找对应的
piece layers,检查摘要数量及其合并后的根是否匹配pieces root。 - 对原始
info字节计算 SHA-256,并检查 Magnet 中的 v2 资源标识是否对应。
若解析结果显示文件树路径正确,但 Piece Layer 根校验失败,应优先检查最后一个叶块的补零方式、缺失叶使用的全零哈希、Piece 层级选择以及哈希拼接顺序。只有这几项都正确,才能把验证失败进一步归因于下载数据损坏。