
P2P 与分布式存储 / 系统课时
区分 Piece 与 Block 的编号范围
区分 Piece 与 Block 的编号范围
实现 BitTorrent 下载调度时,必须把种子定义的 Piece 与网络请求使用的 Block 分开计算。本文通过一组具体数值,推导 Piece 索引、Block 起始偏移、请求长度及尾块边界,并实现可运行的请求规划程序,避免越界请求和分块拼接错误。
学习目标
- 区分 Piece 与 Block 的层级关系及 Peer Wire Protocol 中的定位字段。
- 根据文件总长度、Piece 长度和请求块大小计算编号、偏移与尾块长度。
- 使用 Python 生成合法的 Block 请求,并验证最后一个 Piece 的边界。
Piece 与 Block 分别负责什么
Piece 是种子元数据定义的完整性校验单位。BitTorrent v1 的 info 字典包含 piece length 和 pieces:前者规定通常使用的 Piece 长度,后者按 Piece 索引顺序存放每个 Piece 的 20 字节 SHA-1 摘要。一个 Piece 下载完整后才能进行对应的 SHA-1 校验。
Block 是客户端为了传输和调度而从 Piece 内切出的请求区间。Block 不需要与种子元数据中的独立哈希一一对应;客户端通常先接收多个 Block,再拼接为完整 Piece 进行验证。
例如,资源总长度为 700000 字节,piece length = 262144 字节(256 KiB),请求块大小取 16384 字节(16 KiB):
| 项目 | 数值 | 含义 |
|---|---|---|
| Piece 0 | 262144 字节 | 包含 16 个完整 Block |
| Piece 1 | 262144 字节 | 包含 16 个完整 Block |
| Piece 2 | 175712 字节 | 最后一个 Piece,包含 11 个 Block |
| Piece 2 的最后一个 Block | 11872 字节 | 不足 16 KiB 的尾块 |
因此,Piece 索引为 0、1、2;Block 在每个 Piece 内按偏移定位,不能把所有 Block 的序号直接当成 Piece 索引。
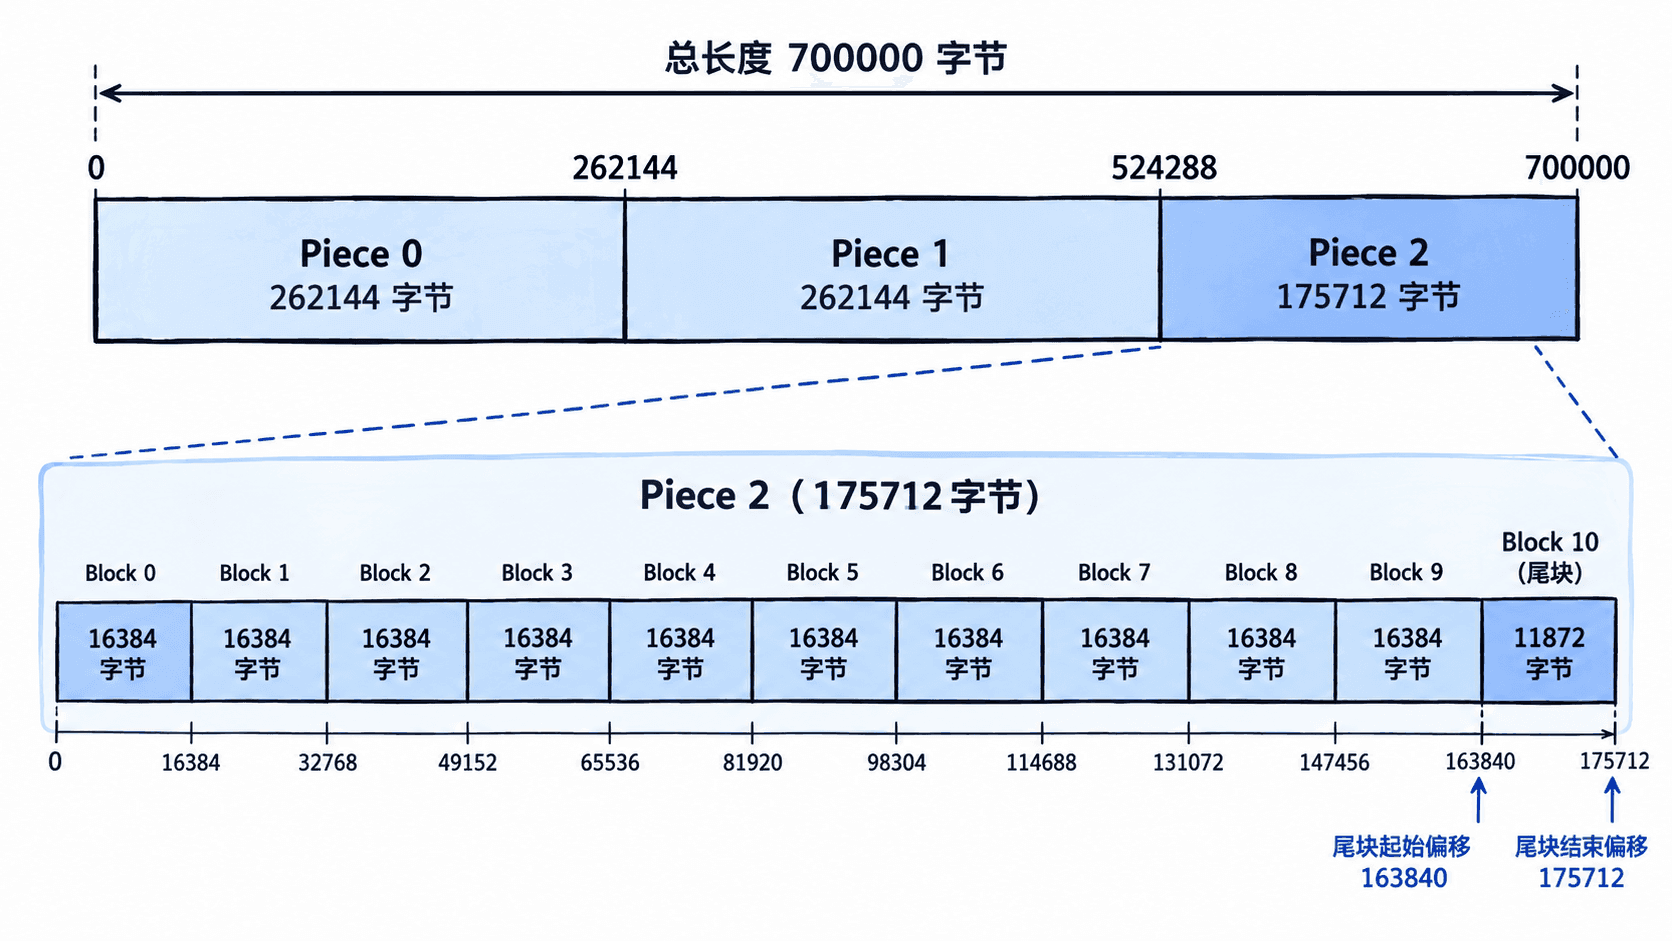
计算 Piece 索引与有效长度
设资源总长度为 ,标准 Piece 长度为 ,请求块上限为 。在单个 BitTorrent v1 资源中,多文件模式也按文件列表顺序拼接成连续字节空间后再划分 Piece,而不是每个文件重新从 Piece 0 开始。
Piece 总数使用向上取整:
合法 Piece 索引满足 。Piece 的全局起点为 ,实际长度为:
以上述资源为例,。Piece 2 的起点是 524288,实际长度是 字节。
已知某个全局字节位置 时,可以反向求出它属于哪个 Piece:Piece 索引为 ,Piece 内偏移为 。例如,全局偏移 540672 对应 Piece 2、内部偏移 16384。
计算 Block 偏移与请求长度
在 BitTorrent Peer Wire Protocol 中,request 消息使用三个 4 字节无符号大端整数定位一个请求:index、begin、length。消息另有 4 字节长度前缀和 1 字节消息 ID(值为 6)。
index:从 0 开始的 Piece 索引。begin:Block 在所属 Piece 内的字节偏移,不是整个资源的全局偏移。length:本次请求的字节数,不能超过 Piece 剩余长度。
如果在一个 Piece 内采用固定的请求块上限 ,第 个 Block 的偏移和长度分别为:
其中 从 0 开始,且必须满足 。实际网络请求还应遵守双方支持的最大请求长度;16 KiB 是常见且具有良好兼容性的选择,不能假设任意 Peer 都接受更大的请求。
以 Piece 2 为例,第 10 个 Block(从 0 编号)的 begin = 163840,length = 11872。它覆盖 Piece 内半开区间 [163840,175712),对应资源全局区间 [688128,700000),恰好到达资源末尾。
使用 Python 生成请求清单
下面的完整示例适用于 Python 3.9 及以上版本。程序先计算每个 Piece 的实际长度,再按 16 KiB 切分请求,并检查所有请求是否连续覆盖资源且不越界。
from math import ceil

TOTAL = 700000
PIECE_LENGTH = 262144
BLOCK_SIZE = 16384


def plan_requests(total, piece_length, block_size):
    if total <= 0 or piece_length <= 0 or block_size <= 0:
        raise ValueError("长度参数必须为正整数")

    requests = []
    piece_count = ceil(total / piece_length)
    for index in range(piece_count):
        # 尾部 Piece 可能短于元数据规定的标准长度
        actual_size = min(piece_length, total - index * piece_length)
        for begin in range(0, actual_size, block_size):
            length = min(block_size, actual_size - begin)
            requests.append((index, begin, length))
    return requests


def main():
    requests = plan_requests(TOTAL, PIECE_LENGTH, BLOCK_SIZE)
    last_piece = max(item[0] for item in requests)
    tail = [item for item in requests if item[0] == last_piece]

    # 将 Piece 内偏移换算成全局偏移,验证无缺口、无重叠
    cursor = 0
    for index, begin, length in requests:
        start = index * PIECE_LENGTH + begin
        assert start == cursor
        assert 0 < length <= BLOCK_SIZE
        cursor += length
    assert cursor == TOTAL

    print("Piece 数量:", last_piece + 1)
    print("Block 请求总数:", len(requests))
    print("最后 Piece 的 Block 数:", len(tail))
    print("最后一个请求:", tail[-1])
    print("连续覆盖校验:", "PASS")


if __name__ == "__main__":
    main()
预期输出:
Piece 数量: 3
Block 请求总数: 43
最后 Piece 的 Block 数: 11
最后一个请求: (2, 163840, 11872)
连续覆盖校验: PASS
这里的 43 个请求由前两个 Piece 各 16 个 Block、最后一个 Piece 的 11 个 Block 组成。输出元组 (2, 163840, 11872) 可直接映射为请求消息的三个定位字段,但示例尚未包含 Peer 连接、请求窗口、超时重试或网络报文编码。
处理边界错误与校验时机
实现下载器时,最容易出现的错误是对所有 Piece 使用同一长度,或者对最后一个 Block 仍然请求完整的 16384 字节。
| 错误做法 | 具体后果 | 正确处理 |
|---|---|---|
将 Block 序号当作 index |
请求错误 Piece | index 使用 Piece 编号 |
将全局偏移写入 begin |
请求超出当前 Piece | begin 从当前 Piece 起点计算 |
| 尾块始终请求 16384 字节 | 最后请求越界 | 使用 min(B, 剩余字节数) |
| 收齐单个 Block 就验证 Piece SHA-1 | 缺少其余数据,无法完成 Piece 校验 | 收齐整个 Piece 后校验 |
对收到的 Block,先确认 Piece 索引合法、begin 与请求匹配、载荷长度符合预期,且 begin + length 不超过该 Piece 的实际长度。接收端还应维护已请求和已接收的区间,避免重试产生的重复响应被错误累计为新数据。
所有 Block 收齐后,按 begin 排序或写入对应偏移,得到完整 Piece,再与 v1 种子中对应的 SHA-1 摘要比较。哈希不匹配时,应将该 Piece 标记为未验证并重新获取数据,不能仅因为 Block 数量齐全就宣布下载成功。
可以修改示例中的 TOTAL = 524289 再运行:预期出现 3 个 Piece,最后一个 Piece 只有 1 字节,最后请求为 (2, 0, 1),总请求数为 33。这个边界测试能够同时检查 Piece 向上取整和不足一个 Block 的尾块处理。