
P2P 与分布式存储 / 系统课时
请求流水线怎样避免带宽空转
请求流水线怎样避免带宽空转
下载端如果每收到一个 Piece 数据块才发送下一个 Request,网络往返等待就会反复打断传输。本课通过串行与流水线请求对比,计算 RTT、Block 大小和未完成请求窗口对吞吐量的影响,并实现一个可运行的窗口估算器,最后确定超时重试和动态调整规则。
学习目标
- 解释串行请求为什么无法充分利用高带宽、高 RTT 的 Peer 连接。
- 根据 RTT、Block 大小和目标吞吐量计算合理的请求窗口。
- 设计包含请求状态、超时回收和窗口调整的调度规则。
串行请求为什么浪费带宽
BitTorrent Peer Wire Protocol 使用 Request 消息请求数据块,典型字段为 index、begin、length。上传端返回 Piece 消息,携带相同的 index 和 begin,以及实际数据 block。下载端据此匹配请求与响应。
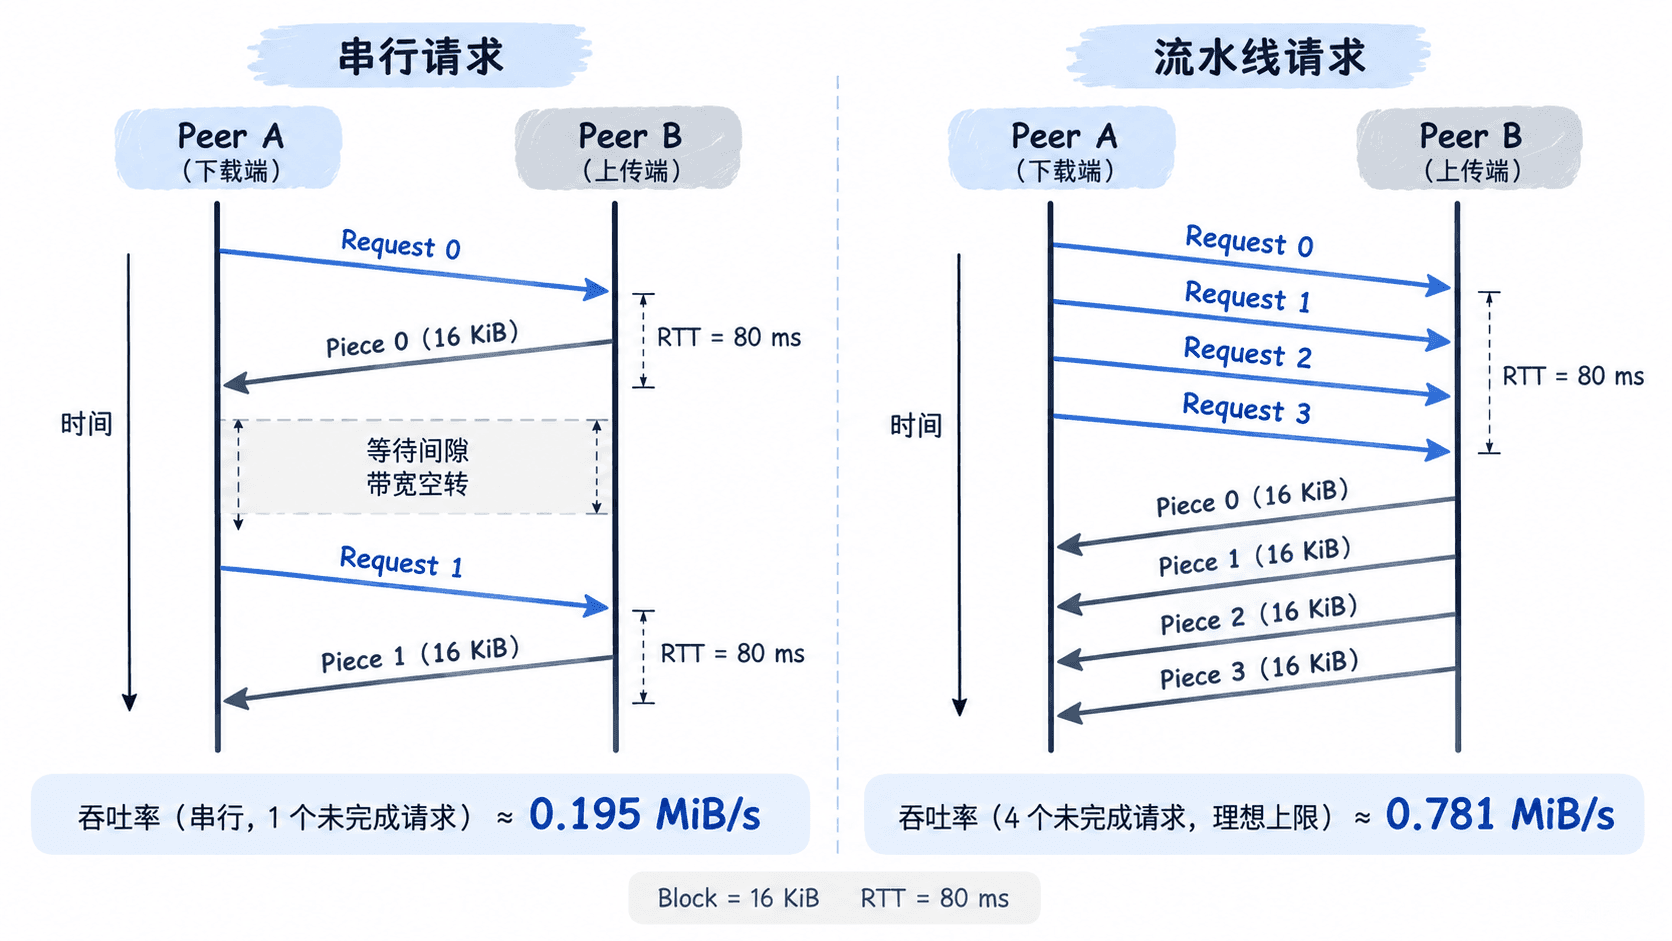
假设一个 Block 为 16 KiB,即 16384 字节,Peer 之间 RTT 为 80 ms,下载链路可用带宽为 10 MiB/s。串行模式一次只保留一个未完成 Request,必须等待响应后才发出下一条请求。
忽略协议开销、服务端处理时间与链路拥塞,串行请求的理论吞吐上限约为:
这仅达到 10 MiB/s 可用带宽的约 1.95%。原因不是 TCP 无法传输更多字节,而是应用层没有提前提交足够的数据请求。上传端发送完当前 Block 后,可能没有下一条 Request 可处理。
流水线模式允许同一 Peer 连接同时存在多个尚未完成的 Request。下载端连续发送多个不同 Block 的请求,上传端就能持续准备并发送数据,不必在每个 Block 后等待新的往返周期。
用带宽时延积确定请求窗口
请求窗口 W 表示对同一个 Peer 允许同时存在的未完成 Block 请求数量。若每个 Block 大小为 B,往返时间为 RTT,理想情况下窗口限制的吞吐上限近似为:
为达到目标吞吐量 R,窗口至少应满足:
其中 R 使用字节每秒,RTT 使用秒,B 使用字节。分子 R × RTT 就是带宽时延积,表示为了持续填满链路,平均需要多少字节处于传输或等待完成状态。
继续使用 16 KiB Block、80 ms RTT 和 10 MiB/s 目标吞吐量:
不同窗口对应的理想吞吐上限如下:
| 未完成请求数 | 在途数据 | 理想吞吐上限 |
|---|---|---|
| 1 | 16 KiB | 0.195 MiB/s |
| 4 | 64 KiB | 0.781 MiB/s |
| 16 | 256 KiB | 3.125 MiB/s |
| 32 | 512 KiB | 6.25 MiB/s |
| 52 | 832 KiB | 10.156 MiB/s |
这些数值只是应用层窗口模型的上限,不是实测速度。实际吞吐还受到上传端限速、磁盘读取、TCP 拥塞控制、排队延迟和其他 Peer 竞争的影响。RTT 也不等于每个请求的实际完成时间,上传端排队可能使响应明显变慢。
实现可运行的窗口估算器
下面使用 Python 3 标准库计算不同窗口的理论吞吐,并根据目标带宽估算所需请求数。代码不依赖 BitTorrent 网络环境,可以先验证窗口计算,再将结果用于实际调度器的初始参数。
import math

BLOCK_BYTES = 16 * 1024
RTT_SECONDS = 0.080
TARGET_MIB_PER_SEC = 10


def required_window(rate_mib, rtt, block_bytes):
    # 将目标速率换算成字节每秒,再计算带宽时延积
    target_bytes_per_sec = rate_mib * 1024 * 1024
    return math.ceil(target_bytes_per_sec * rtt / block_bytes)


def window_limit_mib(window, rtt, block_bytes):
    # 只估算应用层请求窗口造成的吞吐上限
    return window * block_bytes / rtt / (1024 * 1024)


def main():
    for window in (1, 4, 16, 32, 52):
        limit = window_limit_mib(window, RTT_SECONDS, BLOCK_BYTES)
        print(f"window={window}, limit={limit:.3f} MiB/s")
    required = required_window(
        TARGET_MIB_PER_SEC, RTT_SECONDS, BLOCK_BYTES
    )
    print(f"required_window={required}")


if __name__ == "__main__":
    main()
预期输出:
window=1, limit=0.195 MiB/s
window=4, limit=0.781 MiB/s
window=16, limit=3.125 MiB/s
window=32, limit=6.250 MiB/s
window=52, limit=10.156 MiB/s
required_window=52
这里的 required_window=52 是满足理想吞吐目标的数学估算,不意味着实际客户端应无条件向每个 Peer 发送 52 条 Request。若对端队列较短或网络发生拥塞,应降低窗口。不同 Peer 的 RTT 和吞吐能力不同,窗口也应分别计算,不能直接共享同一个固定值。
请求生命周期与超时回收
流水线必须记录每个未完成请求,否则响应乱序、重复响应或超时后重试都可能造成重复写入。一个实用的请求记录至少包含 peerId、pieceIndex、begin、length、sentAt 和 state。
请求可按以下顺序处理:
- 从尚未完成的 Piece 中选择缺失 Block,确认该 Peer 拥有对应 Piece,且当前允许请求。
- 当
outstanding < window时发送 Request,将 Block 标记为 InFlight,并记录发送时间。 - 收到 Piece 后,用
pieceIndex、begin和数据长度匹配未完成请求;验证边界后写入临时缓冲区。 - Block 接收完成后释放窗口名额,立即调度下一个缺失 Block,不等待整个 Piece 完成。
- 若请求超过超时阈值仍未完成,将其标记为超时,按策略重试或改由其他 Peer 请求。
- Piece 所有 Block 收齐后执行哈希校验;只有校验通过,才把 Piece 标记为已完成并向其他 Peer 宣告 Have。
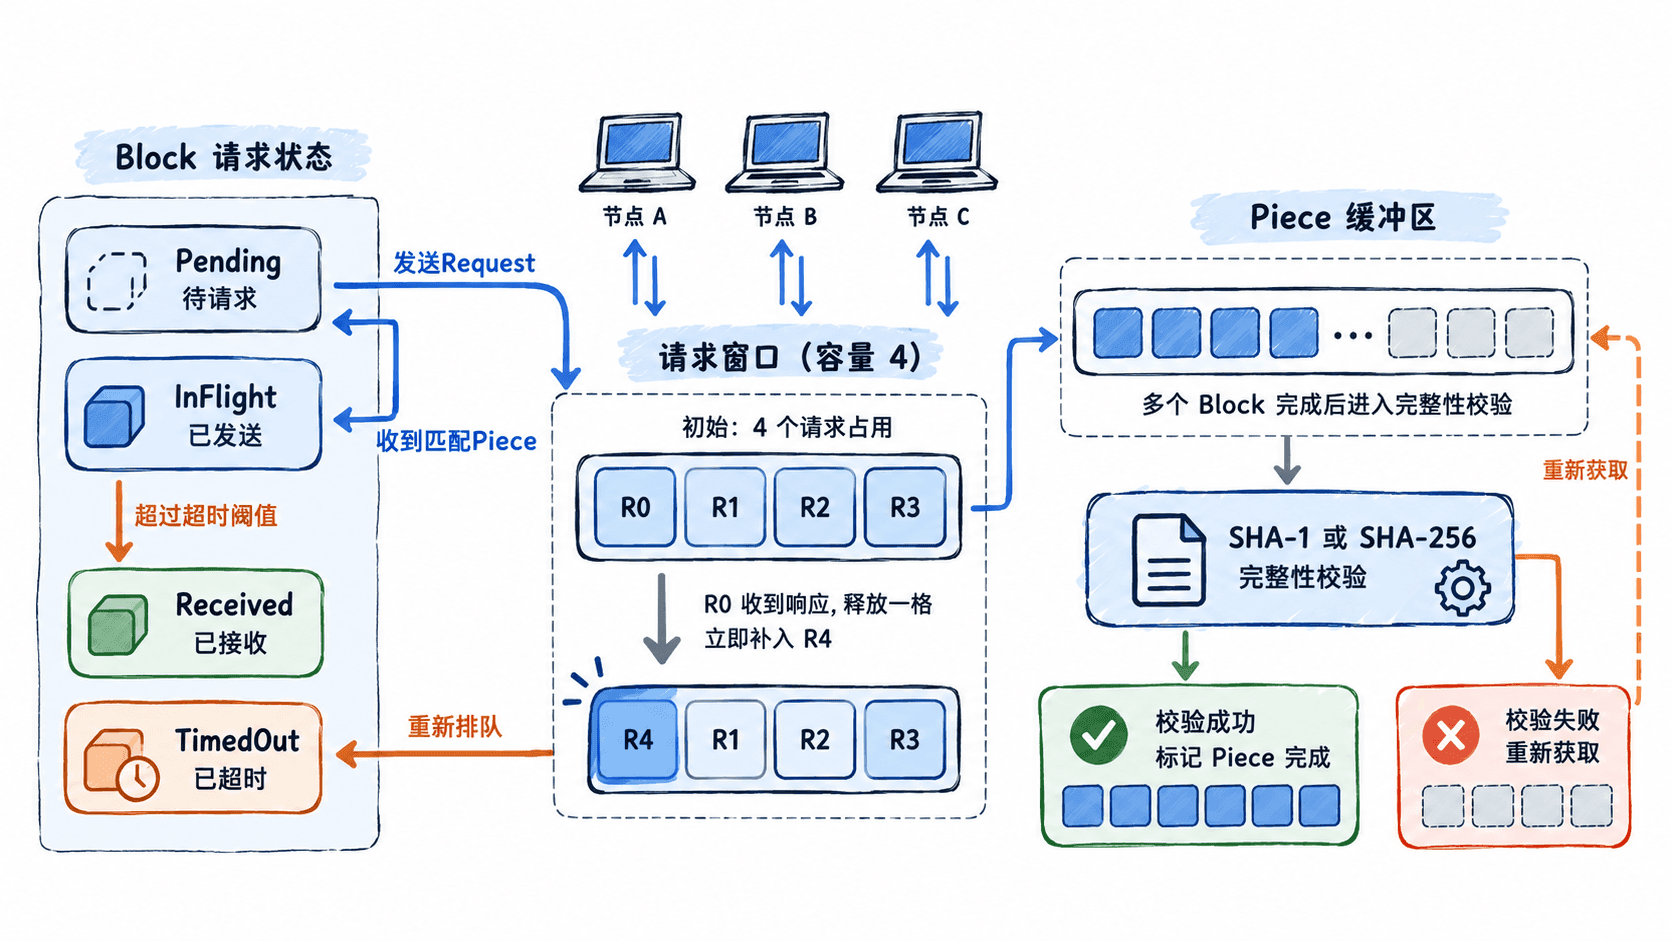
超时阈值不应直接等于 RTT。RTT 为 80 ms 时,请求可能还要经历上传端排队和磁盘读取。可以先用 2 秒作为实验性请求超时阈值,再根据实际响应完成时间分布调整;这不是 BitTorrent 协议规定的统一值。
同一 Block 超时后不要立即向所有 Peer 无限重复发送。正常调度应优先避免重复在途请求,超时重试要有次数和退避限制。若多个 Peer 同时返回同一 Block,应只接受有效且尚未提交的数据,其他响应不能重复计入进度。进入 Endgame 阶段时,客户端可以有意向多个 Peer 请求剩余 Block,并在收到有效数据后发送 Cancel 清理其他尚未完成的重复请求。
根据实际吞吐动态调整窗口
固定窗口在网络条件变化时容易出现两种问题:窗口太小导致上传端缺少待处理请求;窗口太大导致排队时间增加、内存占用上升和超时请求积压。
一个可用于实验的调节策略是每 5 秒评估一次 Peer 连接,记录已完成有效数据字节数、请求完成时间、超时次数和当前未完成请求数。先以窗口 8 启动,设置最小窗口 2、最大窗口 64;这些是示例调度参数,不是协议常量。
| 观测情况 | 调整动作 |
|---|---|
| 窗口持续占满、吞吐上升、无超时 | 窗口增加 4 |
| 窗口持续占满、吞吐不再上升 | 保持窗口 |
| 超时率超过 5%,且完成延迟明显上升 | 窗口减半,最低为 2 |
| Peer 进入 Choked 状态 | 停止发送普通新请求,等待许可恢复 |
例如窗口从 8 增加到 12、16、20 后,吞吐从 1.4 MiB/s 提升到 2.0、2.5、2.6 MiB/s;继续增至 24 时,吞吐仍为 2.6 MiB/s,但请求完成延迟从 120 ms 上升到 260 ms。此时应停止增加窗口,而不是继续追求更高的在途字节数。
这里的 5% 超时率和每次增加 4 条只是便于复现实验的启发式规则。生产实现应结合采样量、延迟分位数、上传端行为和网络波动设置滞回,避免每个评估周期反复增减。
还要区分请求流水线与 TCP 发送窗口:前者控制应用层有多少个 Block 请求未完成,后者由传输层拥塞控制与流量控制决定。即使应用层窗口足够大,TCP 或远端上传能力仍可能限制最终吞吐。
验证流水线是否真正减少空转
测试时使用同一个 Peer、相同 Block 大小和相近网络条件,分别运行窗口 1、4、16、32。记录 30 秒内的有效接收字节数,并计算吞吐量。不要把发送的 Request 数量当作下载成功量。
建议同时检查三个指标:
- 有效吞吐量:成功接收并通过完整性校验的数据量除以测量时长;对尚未完成校验的 Piece 单独统计,避免短时窗口误判。
- 请求完成延迟:从发送 Request 到收到匹配 Block 的时间,观察中位数和 P95 是否随窗口扩大而急剧增加。
- 超时与重复比例:统计超时请求数、重复请求数和无效响应数,判断是否出现过度流水线。
例如窗口从 1 提升到 16 后,有效吞吐量由 0.18 MiB/s 提升到 2.7 MiB/s,且 P95 完成延迟保持在 150 ms 以下,可以继续测试更大窗口。如果窗口从 32 增至 64 后吞吐不变、P95 延迟翻倍并出现大量超时,就应回退到较小窗口。
请求流水线的有效窗口应由目标吞吐、RTT、Block 大小和实测 Peer 行为共同决定。实现时先保证请求状态与响应匹配正确,再逐步扩大窗口,最终选择能够持续供给数据、又不会制造明显排队和重复传输的请求数量。