
P2P 与分布式存储 / 系统课时
扩展握手怎样协商 ut_metadata
扩展握手怎样协商 ut_metadata
Magnet 链接通常只提供资源标识,客户端还缺少文件列表、分块长度和校验信息。要补齐这些数据,客户端需要先通过 BEP 10 扩展握手确认对端是否支持 ut_metadata,再按照 BEP 9 分块请求并验证元数据。本课用具体报文还原协商过程,并实现一个可运行的元数据请求解析示例。
学习目标
- 识别扩展握手中的扩展消息 ID、
m字典和metadata_size。 - 理解
ut_metadata请求、响应与拒绝报文的编码规则。 - 能够按正确的消息 ID 请求元数据,并在拼接后验证 Info Hash。
扩展握手如何建立能力协商
BEP 10 使用普通 Peer Wire Protocol 的扩展消息机制。客户端必须先完成基础握手,并检查握手中 8 字节 reserved 字段的扩展协议支持位:reserved[5] & 0x10 非零表示支持扩展协议。
确认双方支持后,客户端才能发送扩展消息。其外层报文格式为:4 字节大端长度、1 字节消息 ID 20、1 字节扩展消息 ID,以及后续载荷。扩展握手固定使用扩展消息 ID 0,载荷是 Bencode 字典。
例如,一个支持元数据交换的客户端可以在扩展握手中发送以下逻辑内容:
{
  "m": {
    "ut_metadata": 3
  },
  "metadata_size": 32768
}
这里的 JSON 仅用于展示解码后的字段结构,线上实际传输的是 Bencode 字节,而不是 JSON。m.ut_metadata=3 表示发送方声明:其他 Peer 向它发送 ut_metadata 消息时,应使用扩展消息 ID 3。这个编号由发送方分配,并非协议固定值。
metadata_size=32768 表示该 Peer 声明的原始 Bencode info 字典大小为 32768 字节,不是整个 .torrent 文件的大小。没有该字段时,不能直接推断对端元数据大小,应按照实现支持的协议行为处理。
元数据请求如何在 Peer 之间流转
假设客户端 A 只有 Magnet 中的 v1 Info Hash,Peer B 已持有完整元数据,并在扩展握手中声明 ut_metadata=3、metadata_size=32768。
BEP 9 将元数据按每块 16384 字节划分,因此本例共有两块,编号分别为 0 和 1。A 应使用 B 声明的扩展消息 ID 3 发出请求。
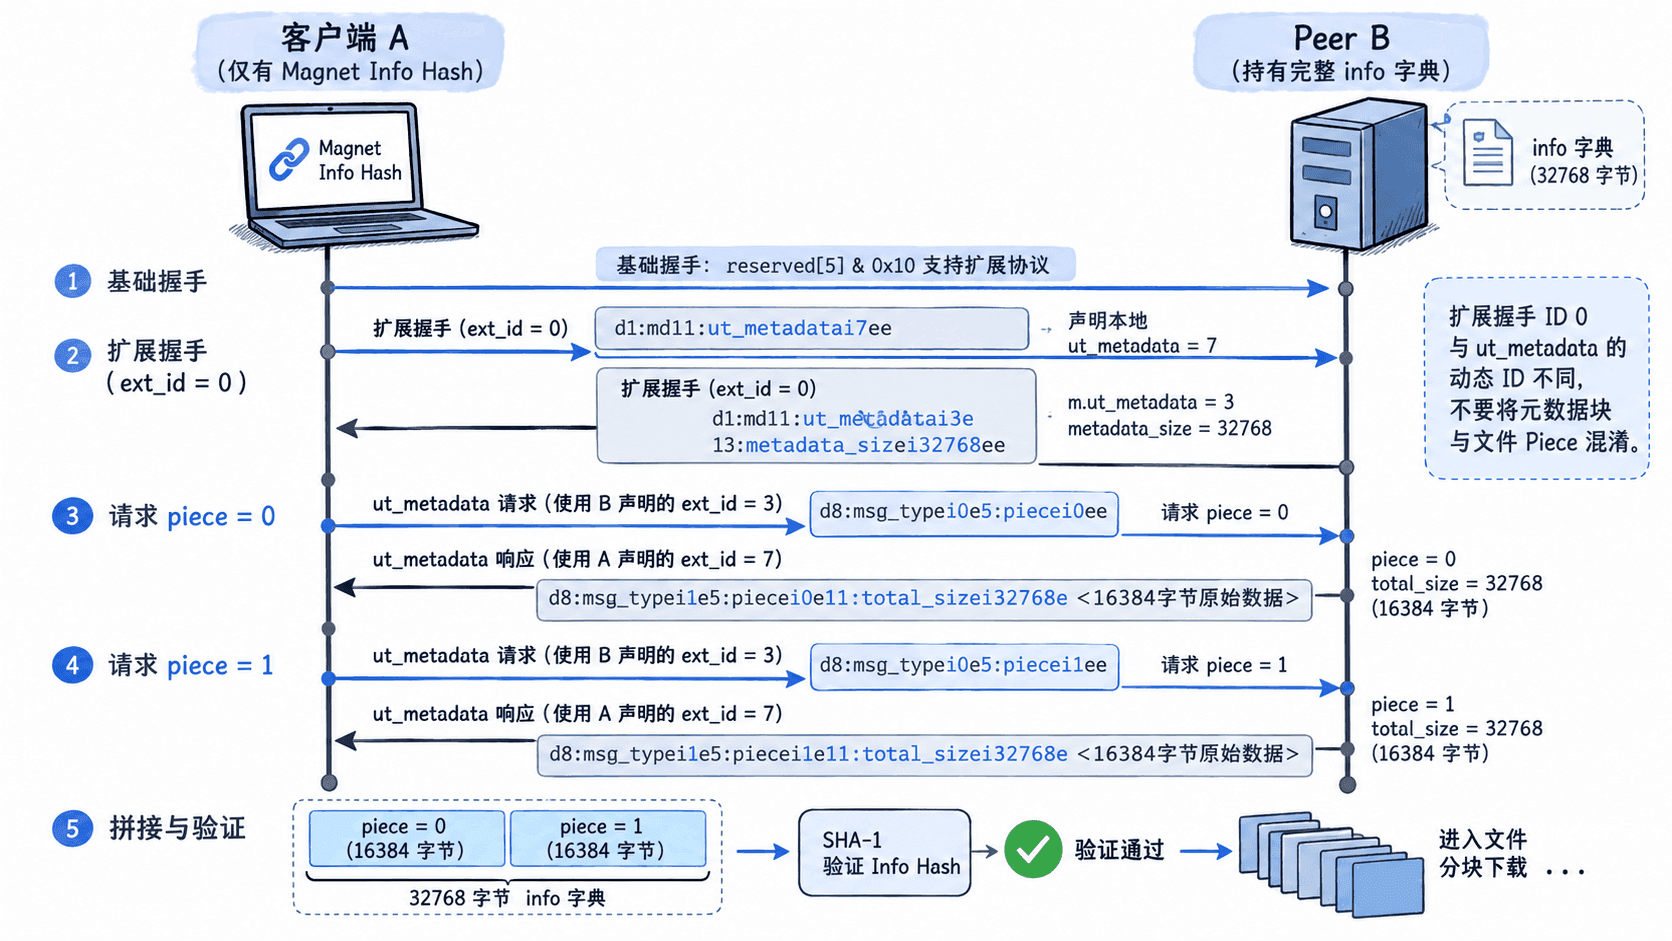
元数据消息载荷由一个 Bencode 字典开头,响应消息还会在该字典后直接追加原始元数据块字节。三种消息通过 msg_type 区分:
| msg_type | 含义 | 关键字段 |
|---|---|---|
| 0 | 请求指定元数据块 | piece |
| 1 | 返回元数据块 | piece、total_size、后续原始字节 |
| 2 | 拒绝请求 | piece |
一次成功交换按以下顺序进行:
- A 解析 B 的扩展握手,记录 B 声明的
ut_metadata消息 ID 和元数据总大小。 - A 发送
msg_type=0, piece=0,外层使用 B 声明的扩展消息 ID。 - B 返回
msg_type=1, piece=0, total_size=32768,并附带第一块 16384 字节原始数据。 - A 请求
piece=1,B 返回第二块。实际客户端可以并发请求,但必须按块编号重组。 - A 拼接全部块,验证元数据哈希后再解析文件列表与分块校验信息。
这里的元数据块不是文件内容 Piece。ut_metadata 的 16 KiB 固定块大小只用于传输 info 字典;文件 Piece 的大小由元数据内部的 piece length 决定。
构造和解析实际元数据消息
下面使用 Python 3 标准库构造 BEP 9 请求消息,再解析对应的 Bencode 字典。为了保持示例可独立运行,编码器只处理本例需要的整数、字节串和字典,完整客户端还需要支持 Bencode 列表及严格格式校验。
import struct


def bencode(value):
    if isinstance(value, int):
        return b"i" + str(value).encode() + b"e"
    if isinstance(value, bytes):
        return str(len(value)).encode() + b":" + value
    if isinstance(value, dict):
        return b"d" + b"".join(
            bencode(k) + bencode(v)
            for k, v in sorted(value.items())
        ) + b"e"
    raise TypeError("unsupported type")


def parse_int_dict(data):
    # 只解析BEP 9请求所需的字节串键与整数值
    if not data.startswith(b"d"):
        raise ValueError("not a dictionary")
    pos = 1
    result = {}
    while data[pos:pos + 1] != b"e":
        colon = data.index(b":", pos)
        key_len = int(data[pos:colon])
        pos = colon + 1
        key = data[pos:pos + key_len].decode("ascii")
        pos += key_len
        if data[pos:pos + 1] != b"i":
            raise ValueError("expected integer")
        end = data.index(b"e", pos)
        result[key] = int(data[pos + 1:end])
        pos = end + 1
    if pos != len(data) - 1:
        raise ValueError("trailing data")
    return result


# 对端声明ut_metadata=3;请求元数据块0
payload = bencode({b"msg_type": 0, b"piece": 0})
message = struct.pack(">I", len(payload) + 2) + bytes([20, 3]) + payload
print(message.hex(" "))
print(parse_int_dict(message[6:]))
预期输出:
00 00 00 1b 14 03 64 38 3a 6d 73 67 5f 74 79 70 65 69 30 65 35 3a 70 69 65 63 65 69 30 65 65
{'msg_type': 0, 'piece': 0}
其中 00 00 00 1b 是长度 27,14 是十六进制的普通消息 ID 20,03 是 B 声明的扩展消息 ID,后面的 64 对应 Bencode 字典起始字符 d。
真实网络接收时必须先读取完整的 4 字节长度,再按该长度收齐消息。对于响应,不能直接将整个扩展载荷当作 Bencode 字典解析,因为字典结束标记 e 后还跟着原始元数据字节。解析器必须返回字典结束偏移,再从该位置提取数据块。
验证元数据并处理异常 Peer
收到所有块后,先检查块编号、块长度、声明总大小和实际拼接长度是否一致。对 32768 字节元数据,块 0 与块 1 均应为 16384 字节;如果总大小是 20000 字节,则最后一块应为 3616 字节。
对于 v1 Magnet,xt=urn:btih: 对应的资源标识是 20 字节 SHA-1 Info Hash。客户端应对拼接得到的原始 Bencode info 字典字节计算 SHA-1,并与 Magnet 中的目标哈希比较。不能对重新编码后的字典、整个 .torrent 文件或单独的元数据块计算后直接作为最终验证结果。
以下代码验证一份已经下载到本地的原始 info 字典,适用于 Python 3:
import hashlib
from pathlib import Path

# 演示使用自建的合法Bencode info字典与对应目标哈希
info_bytes = b"d4:name4:demo12:piece lengthi16384ee"
expected_hash = hashlib.sha1(info_bytes).digest()
Path("info.bin").write_bytes(info_bytes)

received = Path("info.bin").read_bytes()
actual_hash = hashlib.sha1(received).digest()
print("metadata bytes:", len(received))
print("info hash verified:", actual_hash == expected_hash)
预期输出:
metadata bytes: 37
info hash verified: True
这里的目标哈希由本地示例数据生成,仅验证计算方法;真实客户端必须使用 Magnet 提供的目标哈希,不能根据下载结果重新生成期望值,否则失去真实性校验作用。对于 v2 资源,需要按照 BEP 52 的 SHA-256 资源标识与元数据规则验证,不能直接套用 v1 的 SHA-1 判定。
实现客户端时还要处理以下边界:
- 对端未声明
ut_metadata:不能假设默认扩展消息 ID,应尝试其他支持该扩展的 Peer。 - 对端返回
msg_type=2:记录被拒绝的piece,避免对同一 Peer 无限制重试。 - 对端宣称的
metadata_size过大:设置明确的内存上限,例如客户端策略上限 8 MiB;这是本地防护策略,不是 BEP 9 规定的统一上限。 - 收到重复、越界或长度不匹配的块:按块编号检查并丢弃异常数据,必要时切换 Peer。
- 哈希验证失败:不得信任解析出的文件名或 Piece 信息,应丢弃不可信元数据并重新获取。
完成 ut_metadata 交换的判定条件是:所有元数据块齐全、字节长度符合预期、原始 info 字典可正确解码且资源哈希验证通过。此后客户端才具备可靠解析文件布局、校验分块并进入常规 Piece 下载的条件。