
P2P 与分布式存储 / 系统课时
解析 Peer 握手和资源校验字段
解析 Peer 握手和资源校验字段
建立 BitTorrent Peer TCP 连接后,双方需要先交换握手报文,确认协议类型、目标资源和扩展能力。本课拆解标准 68 字节握手结构,使用 Python 实现编码、解析与资源校验,并验证错误握手如何被拒绝。
学习目标
- 识别 Peer 握手中的协议标识、保留位、Info Hash 和 Peer ID。
- 实现握手报文的字节级编码、解析和目标资源校验。
- 区分握手阶段的能力声明与后续扩展协议协商。
标准握手报文的字节布局
BitTorrent v1 的经典 Peer Wire Protocol 握手不使用普通消息的四字节长度前缀,而是以一个字节的协议名称长度开始。使用标准协议名称时,整个握手固定为 68 字节。
| 字节偏移 | 长度 | 字段 | 内容 |
|---|---|---|---|
| 0 | 1 | pstrlen | 协议名称长度,固定为 19 |
| 1~19 | 19 | pstr | ASCII 字符串 BitTorrent protocol |
| 20~27 | 8 | reserved | 保留位及部分扩展能力标志 |
| 28~47 | 20 | info_hash | 目标 v1 资源的 20 字节 SHA-1 信息哈希 |
| 48~67 | 20 | peer_id | 发送方的 20 字节 Peer 标识 |
握手长度计算为 1 + 19 + 8 + 20 + 20 = 68。其中 info_hash 是原始二进制摘要,不是 40 字符的十六进制文本。peer_id 同样必须是 20 字节,不能直接发送长度不固定的客户端名称。
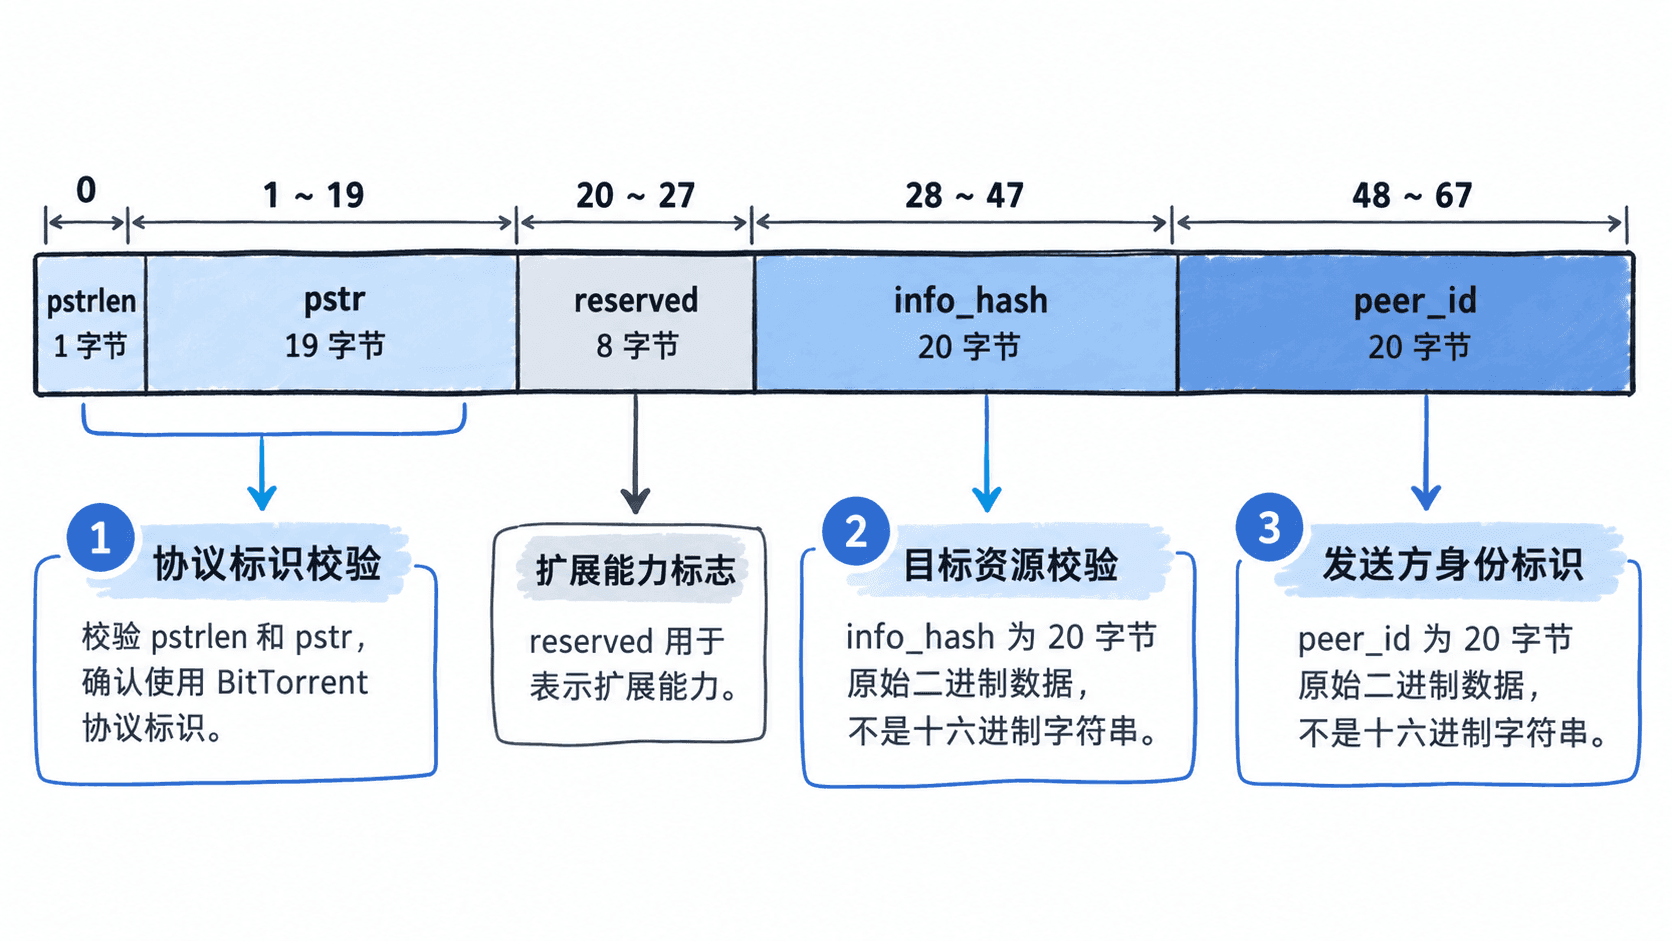
接收端必须先读取一个字节的 pstrlen,再根据该长度读取协议名称和剩余字段。对于只支持经典 BitTorrent 握手的客户端,可以要求 pstrlen == 19 且 pstr == b"BitTorrent protocol",避免错误协议进入后续解析。
Info Hash 如何确认双方下载同一资源
info_hash 是 BitTorrent v1 种子中 info 字典原始 Bencode 字节序列的 SHA-1 摘要。两端只有针对同一个目标资源建立会话,才应继续交换 Bitfield、Have 和 Request 等分块消息。
例如客户端准备下载的资源哈希为 00112233445566778899aabbccddeeff00112233,接收到的握手也必须包含相同的 20 字节摘要。若对端发送 ffeeddccbbaa99887766554433221100ffeeddcc,即使协议名称正确,也应拒绝该连接。
需要注意三个边界:
- 不要对解析后的
info字典重新序列化后再随意计算哈希;字节表示变化可能造成摘要不同。 - 不要将整个
.torrent文件作为 v1 Info Hash 的计算输入;计算范围是顶层info值的原始编码字节。 - Info Hash 匹配只能证明双方声明了相同资源标识,不能证明对端可信,也不能替代 Piece 的哈希校验。
在实际客户端中,入站连接可根据收到的 info_hash 查找本机正在参与的任务;若没有对应任务,应拒绝连接。出站连接则应检查响应中的 info_hash 是否等于发起连接时指定的目标值。
使用 Python 编码并解析握手
下面使用 Python 3.10 及以上版本的标准库 struct 构造标准握手。示例覆盖字段长度、协议名称、目标哈希和 Peer ID 的基本校验,不依赖真实 Tracker 或网络连接。
import struct

PROTOCOL = b"BitTorrent protocol"
FORMAT = "!B19s8s20s20s"
TARGET_HASH = bytes.fromhex("00112233445566778899aabbccddeeff00112233")
LOCAL_PEER_ID = b"-PC0001-123456789012"


def build_handshake(info_hash, peer_id, reserved=b"\x00" * 8):
    if len(info_hash) != 20 or len(peer_id) != 20 or len(reserved) != 8:
        raise ValueError("字段长度不正确")
    return struct.pack(FORMAT, 19, PROTOCOL, reserved, info_hash, peer_id)


def parse_handshake(data, expected_hash):
    # 只接受完整的经典68字节握手,防止截断和字段错位。
    if len(data) != 68:
        raise ValueError("握手长度错误")
    pstrlen, pstr, reserved, info_hash, peer_id = struct.unpack(FORMAT, data)
    if pstrlen != 19 or pstr != PROTOCOL:
        raise ValueError("协议标识不匹配")
    # 资源不匹配时不能进入分块交换阶段。
    if info_hash != expected_hash:
        raise ValueError("目标资源不匹配")
    return reserved, peer_id


def main():
    packet = build_handshake(TARGET_HASH, LOCAL_PEER_ID)
    reserved, peer_id = parse_handshake(packet, TARGET_HASH)
    print("握手长度:", len(packet))
    print("协议名称:", packet[1:20].decode("ascii"))
    print("Peer ID:", peer_id.decode("ascii"))
    print("保留位:", reserved.hex())
    try:
        wrong_hash = bytes.fromhex("ffeeddccbbaa99887766554433221100ffeeddcc")
        parse_handshake(packet, wrong_hash)
    except ValueError as exc:
        print("拒绝原因:", exc)


if __name__ == "__main__":
    main()
预期输出:
握手长度: 68
协议名称: BitTorrent protocol
Peer ID: -PC0001-123456789012
保留位: 0000000000000000
拒绝原因: 目标资源不匹配
struct 格式中的 ! 指定网络字节序,B 表示无符号单字节整数,19s、8s 和 20s 表示定长字节字段。这里使用固定长度格式,是因为示例仅支持标准协议名称;通用解析器应先读取 pstrlen,再按实际长度解析,并限制允许的最大长度。
保留位与扩展能力的判定
reserved 是八个字节的能力标志区域。最简单的实现可以全部填零,但真实客户端可能在其中声明扩展协议或其他协议能力。保留位不是一个可以直接转成客户端版本号的字段。
BEP 10 扩展协议通过 reserved[5] 的 0x10 位声明支持扩展消息。设置这一位表示可以使用扩展消息机制,但并不意味着对方已经支持某个具体扩展。
例如下面的独立 Python 示例可以检查该标志:
reserved = bytes.fromhex("0000000000100000")
# BEP 10使用第6个保留字节的0x10位。
supports_extension = bool(reserved[5] & 0x10)
print("支持扩展消息:", supports_extension)
预期输出:
支持扩展消息: True当双方均声明支持 BEP 10 时,后续可以使用扩展消息 ID 20,发送扩展握手来协商 ut_metadata、ut_pex 等具体扩展。扩展握手里的 m 字典负责映射扩展名称与消息 ID;这些 ID 不应该从 Peer ID 或保留位中推断。
TCP 接收中的半包与拒绝策略
TCP 提供字节流,不保证一次 recv(68) 就能收到完整握手。即使对端一次写入 68 字节,接收端也可能分多次读取。因此生产实现需要按协议字段分阶段读取,或者循环读取直到达到指定长度。
下面的独立示例使用 socket.socketpair() 模拟 TCP 风格的字节流分段到达,验证读取逻辑。此示例适用于支持 socketpair() 的 Python 3 运行环境。
import socket


def recv_exact(sock, count):
    chunks = bytearray()
    while len(chunks) < count:
        # recv返回空字节意味着连接提前关闭。
        part = sock.recv(count - len(chunks))
        if not part:
            raise ConnectionError("连接提前关闭")
        chunks.extend(part)
    return bytes(chunks)


def main():
    left, right = socket.socketpair()
    try:
        left.settimeout(3)
        right.sendall(b"abc")
        right.sendall(b"def")
        right.shutdown(socket.SHUT_WR)
        print("读取结果:", recv_exact(left, 6).decode("ascii"))
    finally:
        left.close()
        right.close()


if __name__ == "__main__":
    main()
预期输出:
读取结果: abcdef实际握手读取可先调用 recv_exact(sock, 1) 获取 pstrlen,校验其值为 19 后,再读取剩余 67 字节。对每条连接设置合理的读取超时,例如 5 秒,并限制并发连接数量,避免恶意客户端持续占用连接资源。
拒绝连接时建议按以下顺序检查:
pstrlen与pstr是否符合支持的协议。- 后续字段是否完整,长度是否正确。
info_hash是否对应本机允许参与的任务。reserved是否包含可识别的扩展能力,并记录必要标志。- 记录对端
peer_id,根据客户端策略执行自连接检测和连接去重。
peer_id 是对端自行声明的标识,不能视为经过认证的身份凭证。收到相同 Peer ID 也不应直接证明两个网络端点属于同一可信设备。
验收握手解析器
可以用四组输入验证实现是否满足最基本的协议约束:
| 测试输入 | 预期行为 |
|---|---|
| 标准 68 字节握手,哈希一致 | 接受并返回保留位及 Peer ID |
| 将协议名称首字节改为其他字符 | 拒绝,协议标识不匹配 |
| 将 Info Hash 改为另一资源摘要 | 拒绝,目标资源不匹配 |
| 只收到 40 字节后连接关闭 | 拒绝,握手不完整 |
若要增加第五组测试,可以将 reserved[5] 的 0x10 位设置为 1,检查解析器是否正确识别 BEP 10 能力,同时确保它不会仅凭该标志就认定 ut_metadata 已协商成功。
通过这些测试后,客户端才适合进入后续的 Peer 消息交换阶段。握手负责识别协议、声明资源与初步能力;分块可用性、请求授权和数据完整性仍须由后续消息与哈希验证分别处理。