
P2P 与分布式存储 / 系统课时
构造 DHT 的 Kademlia 路由表
构造 DHT 的 Kademlia 路由表
BitTorrent DHT 需要在没有中心服务器维护节点名单的情况下,快速找到负责某个资源信息哈希的邻近节点。本课使用简化的节点 ID 和可运行的 Python 示例,构造 K-bucket 路由表,演示 XOR 距离、引导发现、邻近节点查询与失效节点维护,并说明如何映射到真实的 BitTorrent DHT。
学习目标
- 计算节点 ID 之间的 XOR 距离,理解 Kademlia 的距离排序和桶划分规则。
- 使用 K-bucket 保存已知节点,并模拟按目标 ID 查找邻近节点。
- 区分引导节点、路由表维护和资源 Peer 发现的职责。
节点 ID 与 XOR 距离
BitTorrent 主线 DHT 基于 Kademlia 思想。传统 BEP 5 DHT 使用 160 位节点 ID,通常表示为 20 字节。节点 ID 用来标识路由空间中的位置,不等同于节点的公网 IP、TCP 端口或资源文件名。
两个节点 ID 的距离由按位异或计算:
例如使用 8 位 ID 演示,节点 A 为 00101100(44),节点 B 为 00101000(40),两者 XOR 结果为 00000100(4)。节点 C 为 11101100(236),与 A 的距离为 11000000(192)。因此 B 比 C 更接近 A。
XOR 距离是整数距离,不是地理距离,也不能用于推断 RTT。距离为 0 表示 ID 相同;不同 ID 的 XOR 距离大于 0。Kademlia 利用这种距离确定查询优先级,而不是选择物理网络上延迟最低的机器。
K-bucket 怎样划分路由空间
路由表以本地节点 ID 为参照,按 XOR 距离的最高有效位位置分桶。对于 160 位 ID,可以有 160 个距离区间;第 i 个桶覆盖距离 [2^i, 2^(i+1)),其中 i 从 0 开始。自身距离为 0,不进入桶。
为了方便观察,假设本地节点 ID 为 44,采用 8 位空间,桶容量 k=3。真实 BitTorrent DHT 通常采用 k=8;这里缩小容量只是为了展示淘汰行为。
| 桶 | XOR 距离范围 | 已知节点示例 |
|---|---|---|
| B0 | 1 | 45 |
| B1 | 2~3 | 46 |
| B2 | 4~7 | 40、41 |
| B3 | 8~15 | 32、33 |
| B4 | 16~31 | 60 |
| B5 | 32~63 | 12 |
| B6 | 64~127 | 100 |
| B7 | 128~255 | 200 |
节点 40 和 41 相对于本地节点 44 的 XOR 距离分别为 4 和 5,因此进入 B2。节点 32 的距离为 12,进入 B3。不能直接按节点 ID 的十进制大小划桶。
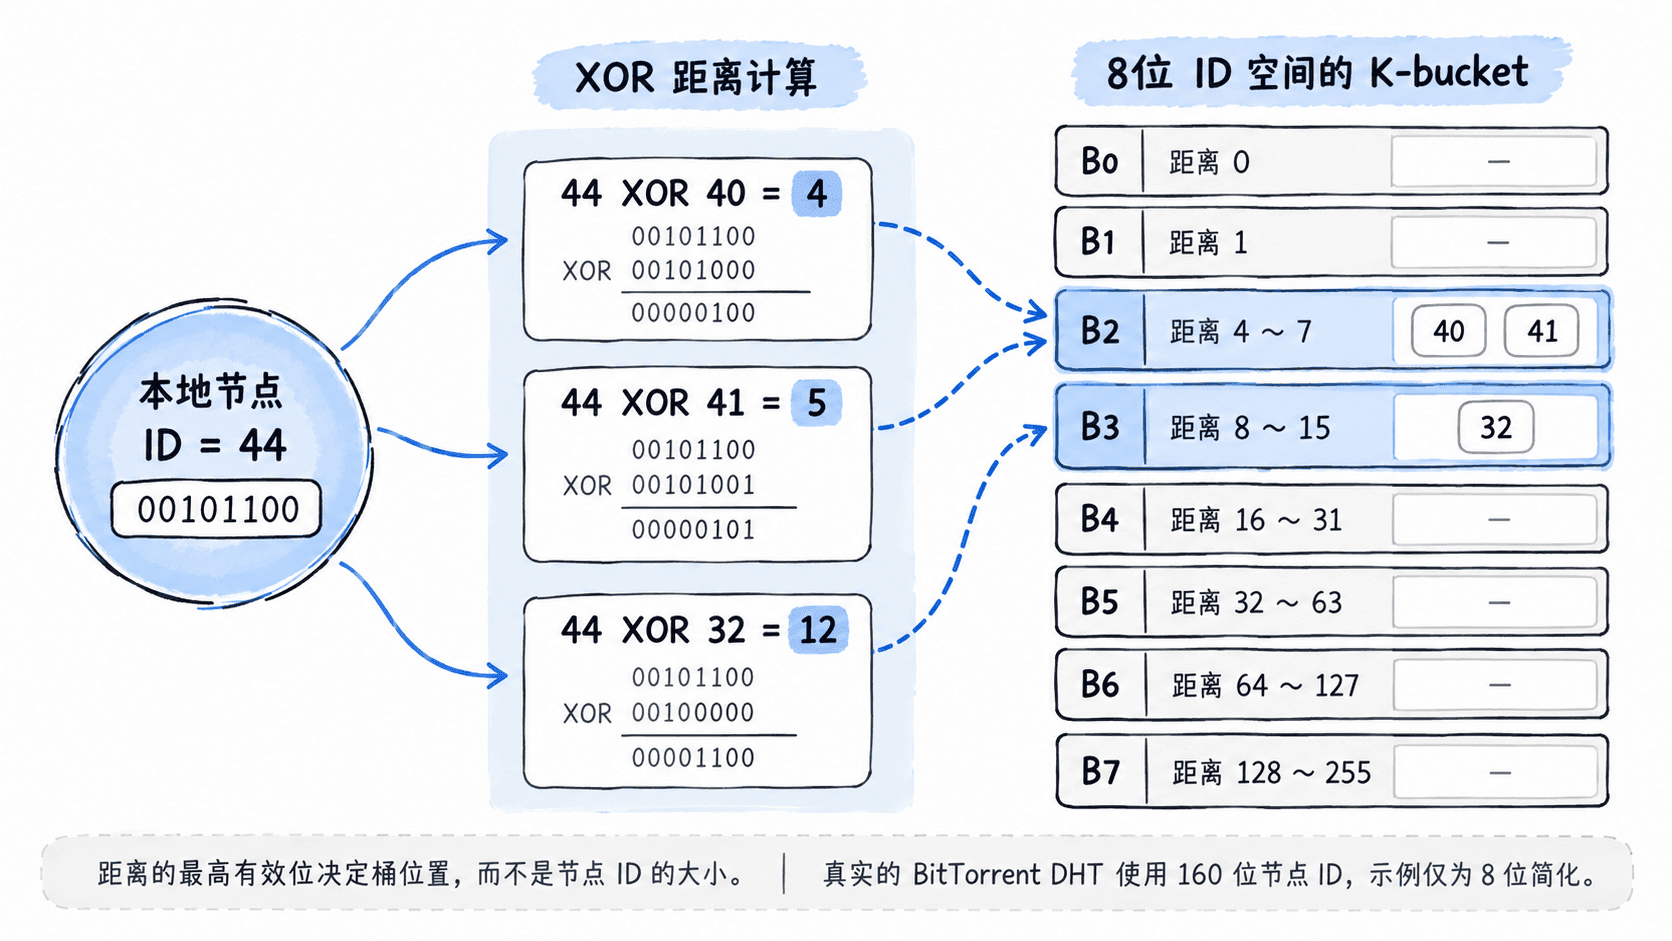
K-bucket 不应无限增长。满桶时通常优先保留已经验证且持续响应的旧节点,对新节点进行候选处理或检查旧节点是否失效,而不是直接替换最早加入的健康节点。这种策略利用了长期在线节点通常更可靠的特点。
用 Python 构造并查询路由表
下面的程序使用 Python 3.10+ 标准库,实现简化版路由表。它支持插入节点、按最近活跃时间更新顺序、计算桶编号和查找目标 ID 附近的已知节点。示例没有网络通信,因此只模拟本地路由表,不实现完整 DHT 协议。
from collections import OrderedDict

BITS = 8
K = 3
LOCAL_ID = 44

# 每个桶以插入顺序表示最近活跃顺序:左旧右新。
buckets = [OrderedDict() for _ in range(BITS)]


def bucket_index(node_id):
    distance = LOCAL_ID ^ node_id
    return distance.bit_length() - 1 if distance else None


def observe(node_id):
    if not 0 <= node_id < (1 << BITS):
        raise ValueError("节点 ID 超出范围")
    index = bucket_index(node_id)
    if index is None:
        return "self"
    bucket = buckets[index]
    if node_id in bucket:
        bucket.move_to_end(node_id)
        return "refreshed"
    if len(bucket) >= K:
        return "full: probe old node first"
    bucket[node_id] = None
    return "added"


def closest(target, limit=3):
    if not 0 <= target < (1 << BITS):
        raise ValueError("目标 ID 超出范围")
    nodes = [node for bucket in buckets for node in bucket]
    return sorted(nodes, key=lambda node: node ^ target)[:limit]


for node in [40, 41, 32, 33, 60, 100, 200]:
    observe(node)

print("B2:", list(buckets[2]))
print("B3:", list(buckets[3]))
print("closest to 42:", closest(42))
print("distance:", [node ^ 42 for node in closest(42)])
print("observe 34:", observe(34))
print("observe 35:", observe(35))
预期输出:
B2: [40, 41]
B3: [32, 33]
closest to 42: [40, 41, 32]
distance: [2, 3, 10]
observe 34: added
observe 35: full: probe old node first
目标 ID 为 42 时,程序按 node_id XOR 42 排序,而不是按节点加入顺序返回。节点 34 进入 B3 后,该桶达到容量 3;随后插入 35 被暂缓,等待旧节点探测。
此实现只存储整数 ID。真实路由项至少还需要节点 ID、IP 地址、UDP 端口和活跃性信息。observe 返回的满桶提示也不是完整替换逻辑:生产实现应向最久未确认活跃的节点发送探测请求,确认失效后才考虑替换,并处理超时和并发响应。
从引导节点开始迭代查找
新启动的 DHT 节点通常没有可用的路由项,因此需要已知的 Bootstrap 节点。引导节点只提供进入 DHT 网络的入口,不是全网节点数据库,也不会代替后续的分布式查询。
真实 BitTorrent DHT 通过 UDP 发送基于 Bencode 的 KRPC 消息。find_node 请求携带本地节点 ID 和目标 ID,响应中的 nodes 字段可包含紧凑格式编码的邻近 IPv4 节点信息。一个 IPv4 节点条目通常为 26 字节:20 字节节点 ID、4 字节 IP 和 2 字节端口。
典型的迭代查询过程如下:
- 从配置的引导地址或已保存的节点列表获得初始节点,发送
find_node请求。 - 将响应节点按其 ID 与目标 ID 的 XOR 距离排序,维护已知候选集合。
- 从尚未查询的近邻候选中选择节点继续发送请求,典型并发度参数为
α=3。 - 合并响应中发现的新节点,去重并更新路由表;对于超时节点记录失败状态。
- 当查询收敛,且最接近目标的候选已得到足够检查时结束本轮查找。
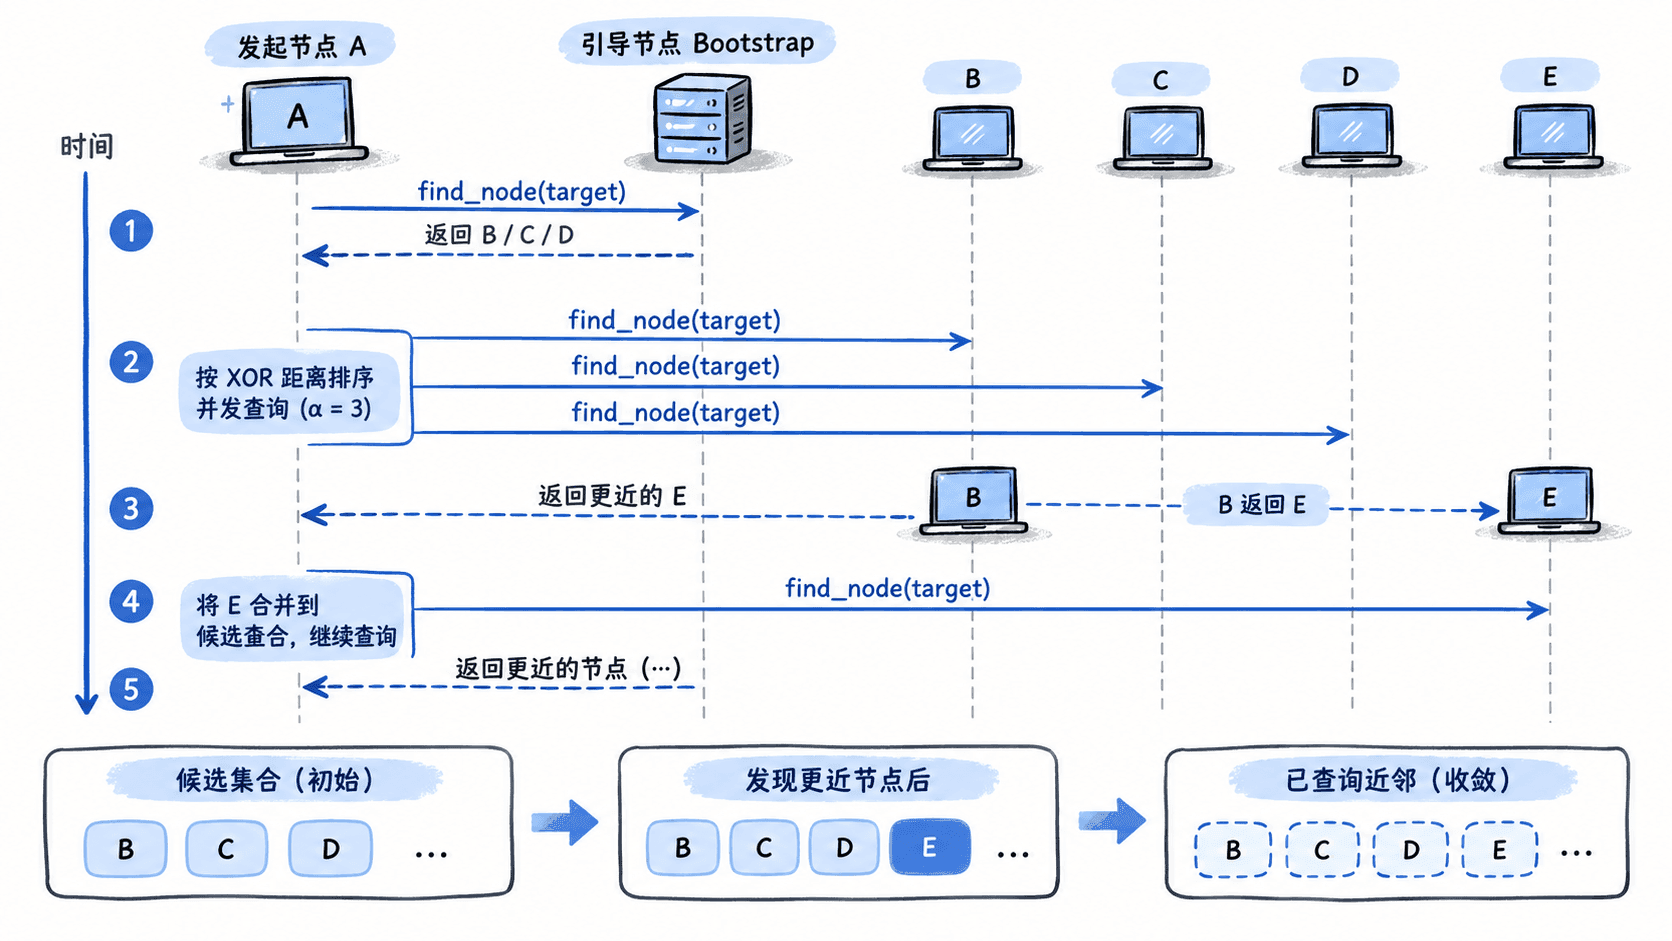
α=3 是常见的 Kademlia 查询并发参数,不代表必须等待每一批三个请求全部返回后才能继续。实际实现可以根据响应和超时动态补充查询。候选列表应限制大小,避免恶意节点返回大量地址导致内存或带宽耗尽。
路由表维护与资源发现的边界
节点可能因 NAT 映射变化、断网或进程退出而失效。维护路由表时,应将收到有效响应视为活跃证据,更新对应节点在桶内的位置;不能仅凭节点曾经出现在其他节点的响应中,就认定它当前可达。
可采用以下维护策略作为实验基线,具体时间值属于应用策略而非 BEP 5 强制常量:
| 事件 | 处理方式 |
|---|---|
| 已知节点有效响应 | 更新最近活跃时间,移到桶的最近使用端 |
| 新节点遇到满桶 | 探测最久未确认活跃的旧节点,健康则保留 |
| 探测超时 | 结合重试与失败记录,确认失效后替换 |
| 桶长期无有效活动 | 选择该桶距离范围内的随机目标进行查找 |
| 节点重启 | 从已保存的可信节点或引导节点重新建立路由表 |
在真实 BitTorrent DHT 中,找到接近目标信息哈希的节点,并不等于已经获得下载者地址。路由表保存的是 DHT 节点;资源发现需要 get_peers 查询。接收方可能返回 values 中的 Peer 地址,也可能返回 nodes 供继续查询。拥有有效 token 后,节点可通过 announce_peer 宣告资源可用性。
可以修改示例,把本地 ID 改为 0、节点集合改为 [1, 2, 3, 4, 8],检查各节点是否分别进入 B0、B1、B1、B2、B3;再将 K 改为 2,观察重复插入和满桶行为。只有桶划分正确、邻近排序正确、满桶不误删健康节点,才能在此基础上继续实现真实 UDP 查询、超时重试和 DHT 节点发现。