
P2P 与分布式存储 / 系统课时
按规则解码 Bencode 数据
按规则解码 Bencode 数据
Bencode 是 BitTorrent 种子文件使用的二进制序列化格式。它只有整数、字节串、列表和字典四种类型,却对字节长度、结束标记和字典键顺序有严格要求。本课使用 Python 编写一个最小解码器,验证嵌套结构,并识别会影响种子解析和 info-hash 计算的编码错误。
学习目标
- 识别 Bencode 四种类型的编码规则和合法边界。
- 编写能够解析嵌套列表、字典和原始字节串的 Python 解码器。
- 验证字节长度、字典键排序、非法整数和尾随数据,并理解原始编码与 info-hash 的关系。
四种类型如何编码
Bencode 不使用 JSON 式的引号、逗号或冒号分隔容器,而是依靠首字节判断类型,再按规则读取内容。解码时必须使用字节序列,不能先将整个文件转换成 UTF-8 字符串。
| 类型 | 编码规则 | 示例 | 解码结果 |
|---|---|---|---|
| 整数 | i + 十进制整数 + e |
i42e |
整数 42 |
| 字节串 | 字节长度 + : + 原始字节 |
4:spam |
字节串 b'spam' |
| 列表 | l + 多个元素 + e |
li1e3:abce |
[1, b'abc'] |
| 字典 | d + 键值交替排列 + e |
d3:fooi7ee |
{b'foo': 7} |
整数允许负数,例如 i-12e,但规范编码不允许 i03e、i-0e、i+3e 或空整数 ie。整数不允许前导零,唯一合法的零编码是 i0e。
字节串长度以字节为单位,不是 Unicode 字符数。UTF-8 字符“中”占三个字节,因此正确编码为 3: 后接该字符的三个 UTF-8 字节,而不是 1:中。
列表允许不同类型混合,也允许空列表 le。字典键必须是字节串,并按原始字节的字典序严格递增排列。规范编码中不能出现重复键,空字典编码为 de。
解码器怎样处理嵌套结构
解析器维护一个当前位置指针,每次读取一个完整值并返回新位置。整数和字节串是终止节点;列表与字典递归调用相同的解析函数,直到遇到对应的 e。
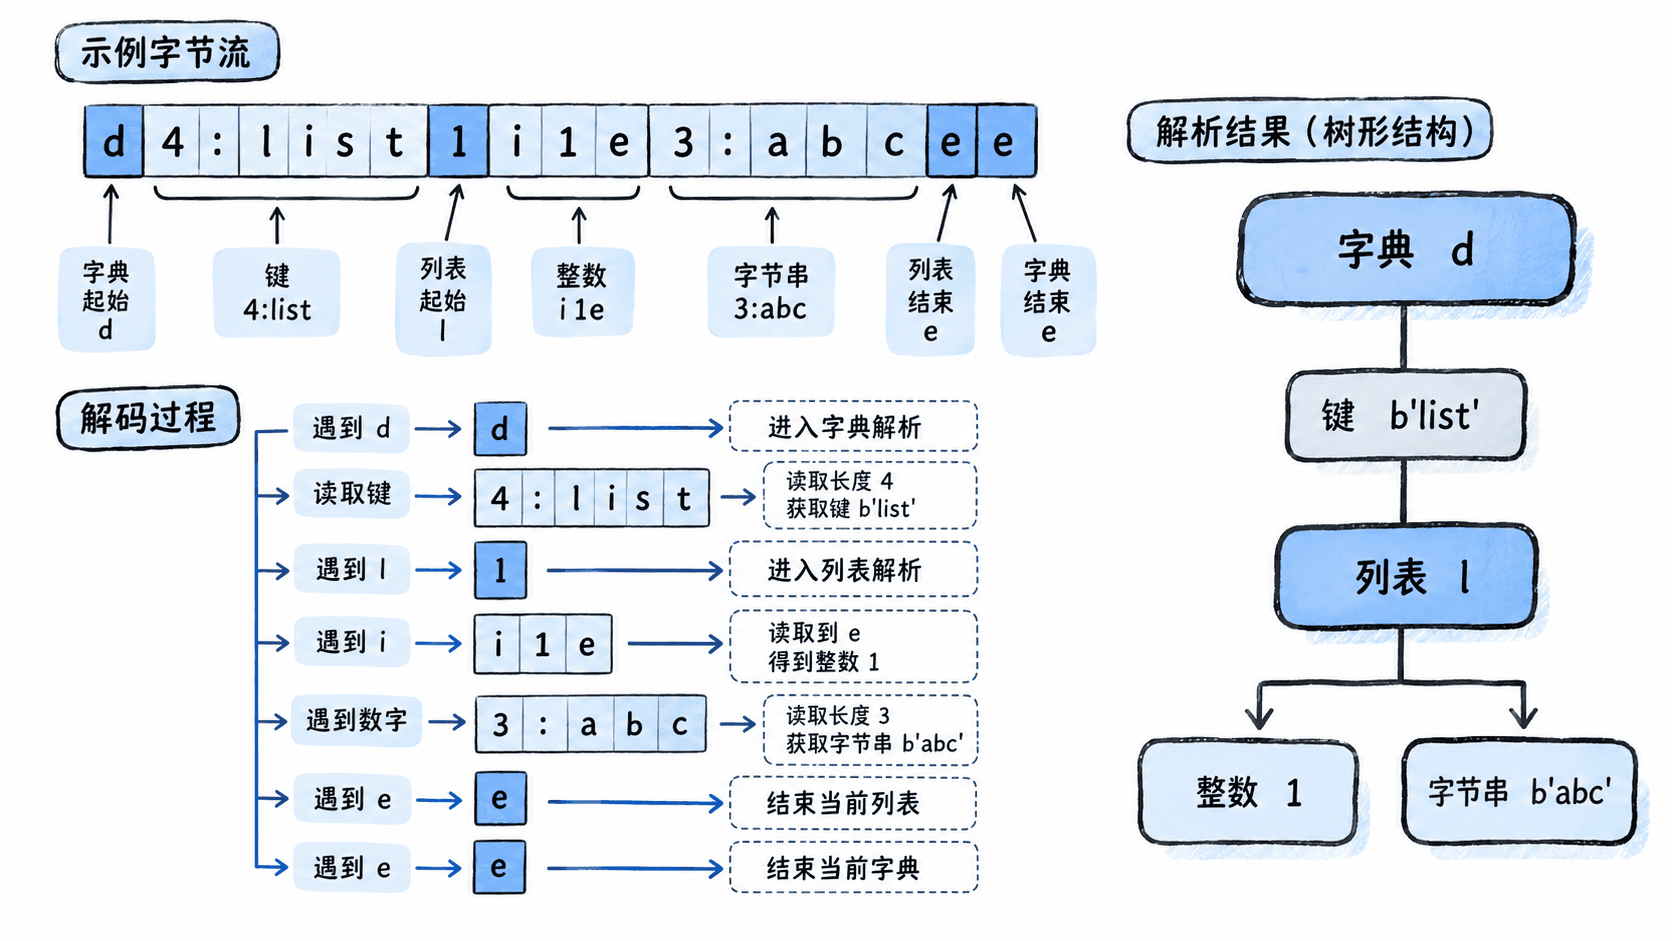
下面使用 Python 3.9 及以上版本,直接处理 bytes。程序检查读取边界、整数格式、字典键顺序和输入是否完全消费。递归深度限制为 64 层,用于避免不可信输入造成过深递归;这属于示例的安全限制,不是 Bencode 协议规定的固定深度。
class BencodeError(ValueError):
    pass


def decode(data: bytes):
    if not isinstance(data, bytes):
        raise TypeError('输入必须是 bytes')

    def parse(pos: int, depth: int):
        if depth > 64:
            raise BencodeError('嵌套过深')
        if pos >= len(data):
            raise BencodeError('数据提前结束')

        marker = data[pos]

        if marker == ord('i'):
            end = data.find(b'e', pos + 1)
            if end == -1:
                raise BencodeError('整数缺少结束符')
            raw = data[pos + 1:end]
            negative = raw.startswith(b'-')
            digits = raw[1:] if negative else raw
            if (not digits or not all(48 <= x <= 57 for x in digits)
                    or (len(digits) > 1 and digits[0] == 48)
                    or (negative and digits == b'0')):
                raise BencodeError('非法整数')
            return int(raw), end + 1

        if 48 <= marker <= 57:
            colon = data.find(b':', pos)
            if colon == -1:
                raise BencodeError('字节串缺少冒号')
            length_raw = data[pos:colon]
            if (not length_raw or not all(48 <= x <= 57 for x in length_raw)
                    or (len(length_raw) > 1 and length_raw[0] == 48)):
                raise BencodeError('非法字节长度')
            length = int(length_raw)
            start = colon + 1
            end = start + length
            if end > len(data):
                raise BencodeError('字节串长度越界')
            return data[start:end], end

        if marker == ord('l'):
            items = []
            pos += 1
            while True:
                if pos >= len(data):
                    raise BencodeError('列表缺少结束符')
                if data[pos] == ord('e'):
                    return items, pos + 1
                item, pos = parse(pos, depth + 1)
                items.append(item)

        if marker == ord('d'):
            result = {}
            previous_key = None
            pos += 1
            while True:
                if pos >= len(data):
                    raise BencodeError('字典缺少结束符')
                if data[pos] == ord('e'):
                    return result, pos + 1
                if not 48 <= data[pos] <= 57:
                    raise BencodeError('字典键必须是字节串')
                key, pos = parse(pos, depth + 1)
                if previous_key is not None and key <= previous_key:
                    raise BencodeError('字典键未严格递增')
                previous_key = key
                value, pos = parse(pos, depth + 1)
                result[key] = value

        raise BencodeError('未知类型标记')

    value, end = parse(0, 0)
    if end != len(data):
        raise BencodeError('存在尾随数据')
    return value


if __name__ == '__main__':
    sample = b'd4:listli1e3:abce4:name4:teste'
    print(decode(sample))
    print(decode(b'i-12e'))
    print(decode(b'0:'))
预期输出:
{b'list': [1, b'abc'], b'name': b'test'}
-12
b''
示例的字典键 list 排在 name 前面,符合字节序要求。4:list 后面的 l 是列表开始标记,内部的 i1e 与 3:abc 各自消耗完整编码,随后一个 e 结束列表,最后一个 e 结束外层字典。
用错误输入验证边界
解码器不能只在合法数据上成功,还必须拒绝长度不匹配、非法整数、无序字典以及多余字节。以下测试直接复用上一节的 decode 和 BencodeError,属于同一 Python 文件中的追加片段示例。
cases = {
    '前导零整数': b'i03e',
    '负零整数': b'i-0e',
    '字节长度越界': b'5:abc',
    '字典键逆序': b'd1:bi1e1:ai2ee',
    '重复字典键': b'd1:ai1e1:ai2ee',
    '列表未结束': b'li1e',
    '尾随数据': b'i1ei2e',
}

for name, payload in cases.items():
    try:
        decode(payload)
        print(f'{name}: 意外通过')
    except BencodeError as exc:
        print(f'{name}: {exc}')
预期输出:
前导零整数: 非法整数
负零整数: 非法整数
字节长度越界: 字节串长度越界
字典键逆序: 字典键未严格递增
重复字典键: 字典键未严格递增
列表未结束: 列表缺少结束符
尾随数据: 存在尾随数据
这些测试覆盖了容易忽略的三类边界:编码形式必须规范、容器必须正确闭合、整个输入必须恰好被消费。尤其不能使用普通字典赋值的覆盖行为来容忍重复键,否则两个不同的原始输入可能在解析后得到相同对象。
解码结果与 info-hash 的关系
传统 BitTorrent v1 种子文件的顶层通常是字典,其中 info 字段包含文件信息。v1 的 info-hash 是对 info 值在原始种子文件中的完整 Bencode 编码字节计算 SHA-1,而不是对 Python 字典的字符串表示求哈希,也不是对整个 .torrent 文件求哈希。
例如,下面的 info 值是一个仅含 name 字段的演示字典。它足以说明哈希的输入范围,但不是可用于实际下载的完整种子元数据。
import hashlib

info_bytes = b'd4:name4:teste'
parsed = decode(info_bytes)

print(parsed)
print(len(info_bytes))
print(len(hashlib.sha1(info_bytes).digest()))
print(len(hashlib.sha1(info_bytes).hexdigest()))
预期输出:
{b'name': b'test'}
16
20
40
SHA-1 的二进制摘要固定为 20 字节,十六进制表示为 40 个字符。计算真实 v1 info-hash 时,必须从原始文件定位并保留 info 值的起止字节位置,包含它自己的 d 和 e,再对这一段原始字节求哈希。
本课解码器返回解析后的对象,没有暴露原始字节区间,因此不能直接拿它的返回值计算真实种子的 info-hash。若后续扩展为种子解析工具,可以让解析函数同时记录顶层 info 值的 start 和 end 偏移,再使用 data[start:end] 取得原始编码。BitTorrent v2 使用 SHA-256 及不同的元数据规则,不能直接套用这里的 v1 哈希定义。
实际读取 .torrent 文件时,可以使用 Python 的 Path.read_bytes() 获得原始字节,再交给 decode。对于来自外部的不可信种子,还应增加文件大小、容器元素数量和字节串长度上限,避免超大输入消耗过多内存。能够完整解码并不等于种子语义合法;文件长度、分片长度及哈希字段等协议约束仍需单独校验。