
P2P 与分布式存储 / 系统课时
用 SHA-1 验证 v1 分块完整性
用 SHA-1 验证 v1 分块完整性
BitTorrent v1 客户端不能仅凭接收字节数判断下载成功。每个 Piece 必须与种子元数据中的 SHA-1 摘要匹配,才能标记为已完成。本课使用 Python 模拟接收、校验、数据损坏、丢弃和重新下载,建立可以直接应用于下载器的完整性检查规则。
学习目标
- 正确读取 v1 种子中的
pieces字段,并定位指定 Piece 的 SHA-1 摘要。 - 使用 Python 对完整 Piece 计算 SHA-1,识别损坏数据并执行重新下载。
- 明确 Block 接收、Piece 校验、磁盘提交和 Have 通告之间的边界。
从种子元数据取得预期摘要
BitTorrent v1 的 info 字典包含 piece length 和 pieces 两个关键字段。前者指定标准 Piece 长度,后者是连续拼接的 SHA-1 摘要字节串,每个摘要固定为 20 字节,并非由 40 个 ASCII 十六进制字符组成。
假设资源总长度为 700000 字节,piece length = 262144,则共有 3 个 Piece:
| Piece 索引 | 全局起始偏移 | 实际长度 | 摘要在 pieces 中的位置 |
|---|---|---|---|
| 0 | 0 | 262144 | 字节 0~19 |
| 1 | 262144 | 262144 | 字节 20~39 |
| 2 | 524288 | 175712 | 字节 40~59 |
Piece 数量采用向上取整:(total_length + piece_length - 1) // piece_length。因此本例 pieces 必须恰好包含 60 字节。第 2 个 Piece 是尾块,不能补齐到 262144 字节再计算哈希。
提取索引为 i 的预期摘要时,使用 pieces[i * 20:(i + 1) * 20]。计算摘要时必须使用 Piece 的原始字节,不能先转成文本,也不能对每个 Block 的哈希再次拼接求哈希。
接收完整 Piece 后再执行校验
Peer Wire Protocol 的 Piece 消息携带 Piece 索引、Piece 内起始偏移和数据内容。下载器通常以更小的 Block 请求数据,例如每次请求 16384 字节,但 v1 元数据并没有为每个 Block 单独保存 SHA-1 摘要。
因此,接收一个 Block 只意味着对应字节区间已收到,不能据此宣布整个 Piece 已验证。应当在所有区间完整、无重叠冲突且长度正确后,对按偏移组装的整个 Piece 计算 SHA-1。
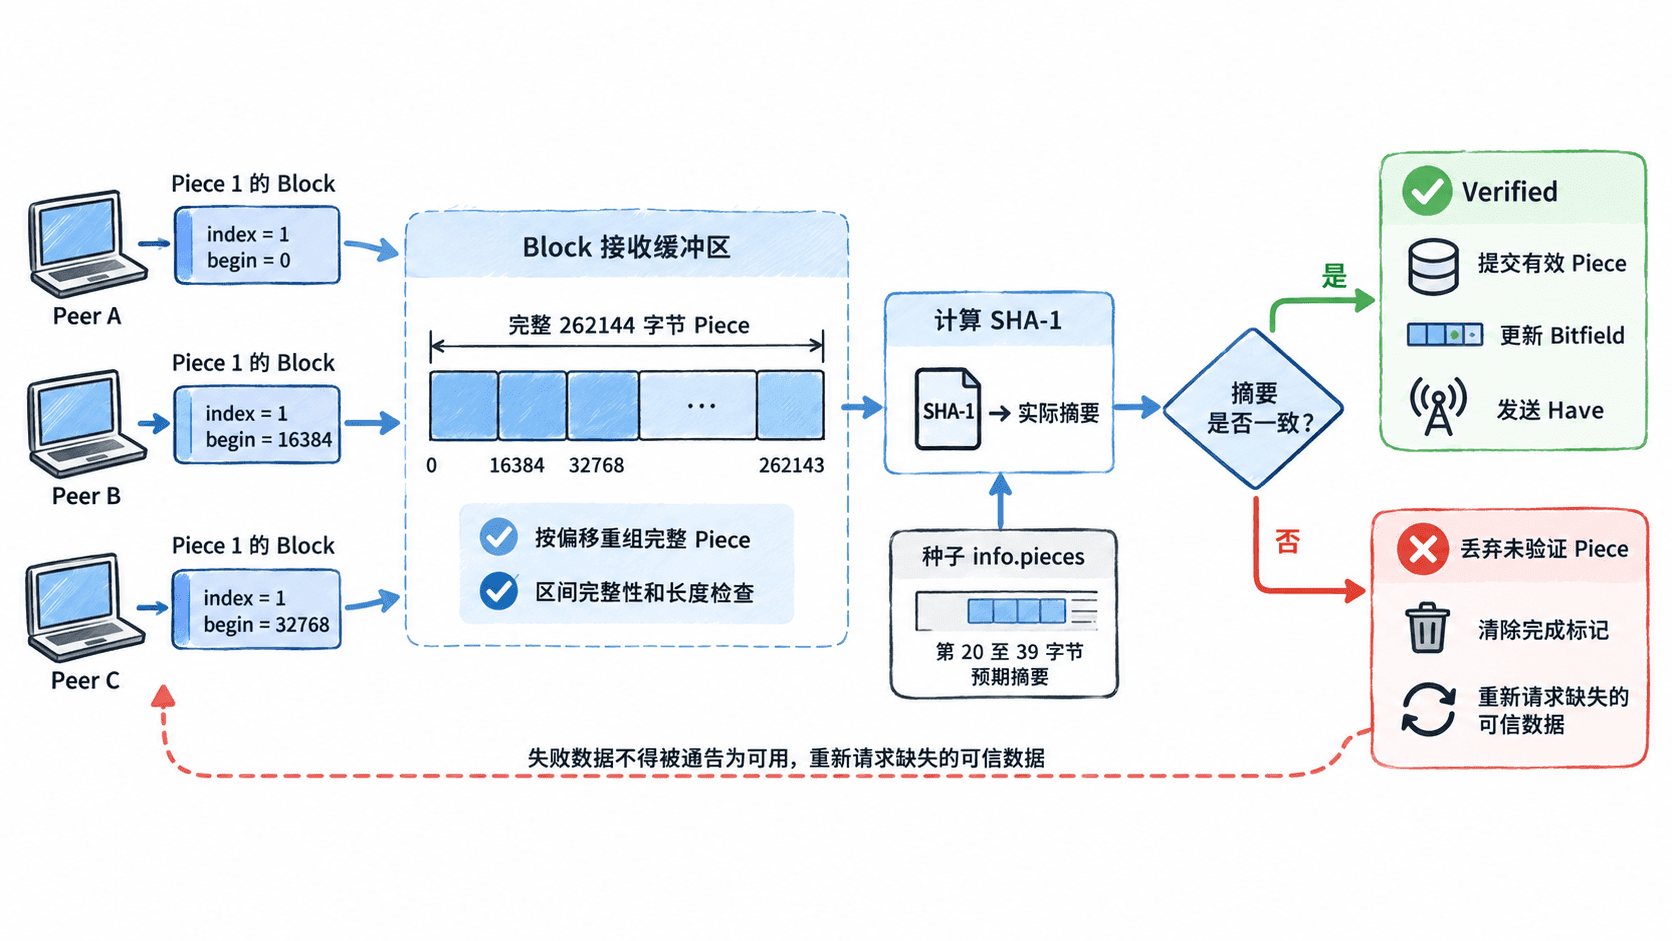
一个合理的 Piece 状态处理顺序如下:
- 收到 Block 时检查
index、begin和数据长度,拒绝越界或与现有内容冲突的异常报文。 - 将合法 Block 写入临时缓冲区,并记录已收到的字节区间。重复收到相同内容不重复计数。
- 所有区间齐全后,检查 Piece 实际长度是否等于预期长度。
- 对完整字节串执行
SHA-1,与种子中对应的 20 字节摘要逐字节比较。 - 匹配则标记已验证并允许对外提供;不匹配则清除该 Piece 的有效状态,重新调度下载。
在真实下载器中,Block 可能乱序到达,不能依照网络到达顺序直接拼接。对于同一 Piece 的多个并发请求,还需要记录请求所属 Peer 和区间,以便超时、取消及错误统计。
用 Python 模拟损坏与重新下载
下面的程序仅使用 Python 3.8 及以上版本的标准库。它先生成一份正确的 Piece 和对应种子摘要,再模拟传输中一个字节被篡改,验证失败后重新取得正确数据。示例采用 32768 字节的 Piece,便于快速运行;生产环境应以实际种子元数据为准。
import hashlib

PIECE_LENGTH = 32768
original = bytes(range(256)) * 128

# 模拟从可信种子 info.pieces 读取的20字节摘要
pieces_field = hashlib.sha1(original).digest()


def verify_piece(index, data, expected_length, pieces):
    start = index * 20
    expected = pieces[start:start + 20]
    if len(expected) != 20 or len(data) != expected_length:
        return False
    return hashlib.sha1(data).digest() == expected


# 模拟下载过程中一个字节被错误修改
received = bytearray(original)
received[100] ^= 0x01

print('首次校验:', verify_piece(0, received, PIECE_LENGTH, pieces_field))

if not verify_piece(0, received, PIECE_LENGTH, pieces_field):
    received = None  # 丢弃不可信的完整Piece
    received = original  # 模拟从Peer重新下载正确数据

print('重下校验:', verify_piece(0, received, PIECE_LENGTH, pieces_field))
print('摘要长度:', len(pieces_field))
预期输出:
首次校验: False
重下校验: True
摘要长度: 20
received[100] ^= 0x01 翻转了第 100 个字节中的一个比特。虽然数据长度完全正确,但 SHA-1 摘要发生变化,因此首次校验失败。重新取得原始字节后,计算结果与预期摘要一致,才允许将 Piece 标记为有效。
这里的 pieces_field 是为了演示而从正确数据生成的。真实客户端必须从已解析的 .torrent 文件 info.pieces 读取它,绝不能根据刚收到的下载数据重新生成预期摘要,否则损坏数据也会通过自我校验。
将失败结果接入下载调度
完整性校验失败后,客户端不能只打印错误日志,还必须恢复调度状态。假设 Piece 1 原本包含 16 个各 16384 字节的 Block,全部接收后发现哈希不匹配,可以按以下规则处理:
| 项目 | 校验通过 | 校验失败 |
|---|---|---|
| Piece 有效标记 | 设置为已验证 | 保持未验证 |
| 本地 Bitfield | 标记该 Piece 可用 | 不标记该 Piece |
| 对外 Have 消息 | 可以发送 | 禁止发送 |
| 缓冲数据 | 提交或保留为可信数据 | 丢弃或隔离 |
| 下载调度 | 结束该 Piece 的请求 | 重新安排其 Block 请求 |
如果已经把未验证字节写入临时磁盘文件,也必须保证这些字节不会被当作有效 Piece 上传。可以使用独立的已验证位图控制读取与对外通告,而不是依赖文件是否存在来判断完整性。
当同一个 Piece 来自多个 Peer 时,一次哈希失败并不能直接证明某个 Peer 恶意或故障。可记录每个 Block 的来源,重新下载后对比不同来源的数据,再累计异常统计。不要仅凭一次失败就永久封禁所有参与上传的节点。
检查尾块与异常边界
实际实现最容易遗漏的是最后一个 Piece。对总长度为 700000 字节、标准 Piece 长度为 262144 字节的资源,尾块长度必须按剩余字节数计算:
import math

total_length = 700000
piece_length = 262144
piece_count = math.ceil(total_length / piece_length)

for index in range(piece_count):
    offset = index * piece_length
    size = min(piece_length, total_length - offset)
    print(index, offset, size)
预期输出:
0 0 262144
1 262144 262144
2 524288 175712
校验器还需要拒绝以下输入:Piece 索引超出合法范围;pieces 摘要串长度与 Piece 数量不匹配;收到的 Piece 字节数不足或超出预期;同一 Block 偏移出现不一致的数据;尚未收齐全部 Block 就触发 SHA-1 校验。
可以用三个用例验收:正确数据必须通过;任意一个字节发生变化必须失败;尾块使用准确的 175712 字节时才能通过其对应摘要校验。多文件种子也应按 v1 的全局连续字节序列切分 Piece,即使 Piece 跨越两个文件边界,也必须先组装完整再计算摘要。
只有通过预期摘要验证的完整 Piece,才能进入已完成集合并向其他节点通告。这样,网络接收、磁盘存储和上传服务才会使用同一套可信的分块状态。