
P2P 与分布式存储 / 系统课时
计算 v1 种子的 Info Hash
计算 v1 种子的 Info Hash
同一个 BitTorrent v1 种子文件中,只有 info 字典的原始 Bencode 编码参与 Info Hash 计算。掌握正确的字节截取和 SHA-1 计算方法后,你可以独立验证种子的资源标识,并解释为什么重新编码元数据可能得到不同的哈希值。
学习目标
- 说明 v1 Info Hash 的计算范围及其与整个
.torrent文件哈希的区别。 - 使用 Python 从种子文件中提取原始
info字节并计算 SHA-1。 - 验证计算结果,识别重新编码、文本转换和字节截取导致的错误。
Info Hash 究竟计算哪些字节
BitTorrent v1 使用 Bencode 表示种子元数据。顶层通常是一个字典,其中 announce 描述 Tracker 地址,info 描述资源名称、文件长度、Piece 长度以及 Piece 哈希等信息。
v1 Info Hash 是 info 字典完整 Bencode 字节序列的 SHA-1 摘要,长度固定为 20 字节,通常显示为 40 位十六进制字符串。
计算时必须保留 info 字典开头的 d 和结尾的 e,但不能包含外层字典、announce 或其他顶层字段。
例如,以下是一个用于演示的最小 info 字典:
d4:name4:test6:lengthi4ee其中 4:name4:test 表示文件名,6:lengthi4e 表示文件长度为 4 字节,最外层的 d 和最后一个 e 分别标记字典开始与结束。这个简化字典用于哈希计算练习,不是完整可用的 v1 种子元数据。
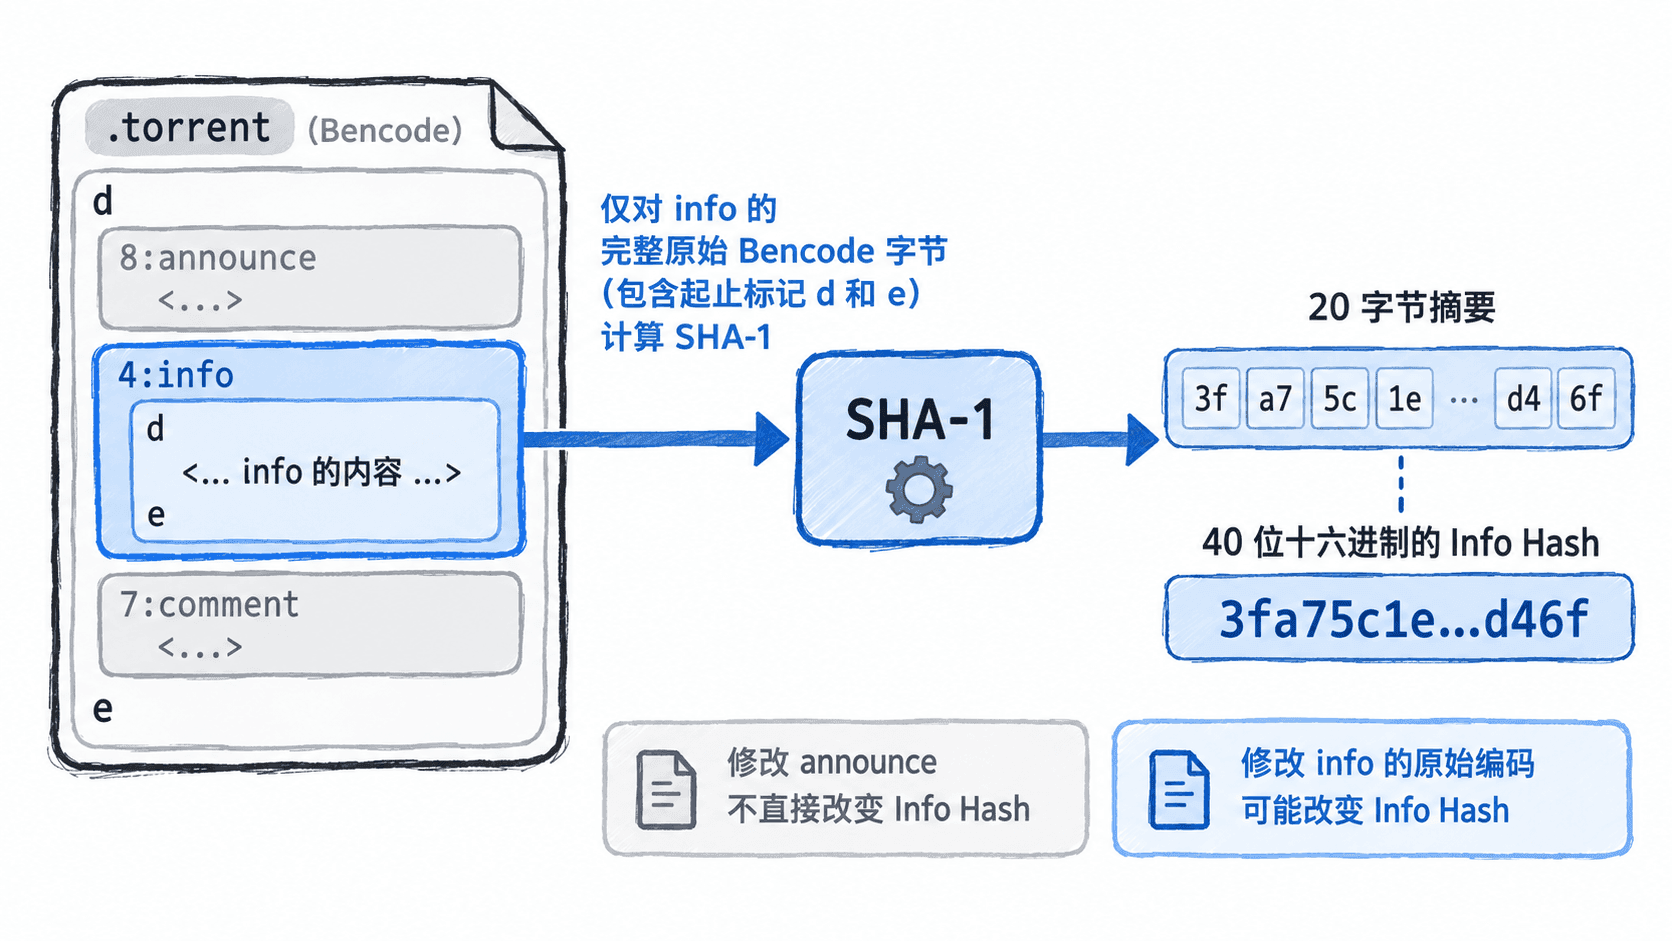
从原始 Bencode 中定位 info 字典
不能直接对整个 .torrent 文件运行 sha1sum 来获得 Info Hash。必须先解析顶层 Bencode 字典,找到键 info 对应值在原始字节流中的起止位置。
Bencode 的四种基本类型分别是整数 i...e、字节串 长度:内容、列表 l...e 和字典 d...e。字典的键是字节串,值可以递归嵌套其他类型。
以下 Python 3.9+ 示例不依赖第三方库。它使用递归解析器跳过任意 Bencode 值,同时保留 info 在源文件中的原始字节区间。
import hashlib
import sys
from pathlib import Path


def skip_value(data, pos):
    if pos >= len(data):
        raise ValueError('Bencode 数据意外结束')
    marker = data[pos]
    if marker == ord('i'):
        end = data.find(b'e', pos + 1)
        if end < 0:
            raise ValueError('整数缺少结束标记')
        raw = data[pos + 1:end]
        if not raw or (raw.startswith(b'-') and raw == b'-0'):
            raise ValueError('非法整数')
        value = int(raw)
        if str(value).encode('ascii') != raw:
            raise ValueError('非规范整数编码')
        return end + 1
    if marker in (ord('l'), ord('d')):
        pos += 1
        while True:
            if pos >= len(data):
                raise ValueError('容器缺少结束标记')
            if data[pos] == ord('e'):
                return pos + 1
            pos = skip_value(data, pos)
    if ord('0') <= marker <= ord('9'):
        colon = data.find(b':', pos)
        if colon < 0:
            raise ValueError('字节串缺少冒号')
        raw_length = data[pos:colon]
        if not raw_length.isdigit() or (
            len(raw_length) > 1 and raw_length.startswith(b'0')
        ):
            raise ValueError('非法字节串长度')
        end = colon + 1 + int(raw_length)
        if end > len(data):
            raise ValueError('字节串长度越界')
        return end
    raise ValueError('未知 Bencode 类型')


def extract_info(data):
    if not data.startswith(b'd'):
        raise ValueError('顶层必须是字典')
    pos = 1
    found = None
    while pos < len(data) and data[pos] != ord('e'):
        # 顶层键必须是字节串,不能把任意值当作键。
        key_start = pos
        pos = skip_value(data, pos)
        encoded_key = data[key_start:pos]
        colon = encoded_key.find(b':')
        if colon < 0 or not encoded_key[:colon].isdigit():
            raise ValueError('顶层字典键不是字节串')
        key = encoded_key[colon + 1:]
        value_start = pos
        pos = skip_value(data, pos)
        if key == b'info':
            if found is not None:
                raise ValueError('重复的 info 键')
            if data[value_start:value_start + 1] != b'd':
                raise ValueError('info 必须是字典')
            # 直接切片,不重新序列化,保留原始字节。
            found = data[value_start:pos]
    if pos >= len(data) or pos != len(data) - 1:
        raise ValueError('顶层字典未正确结束')
    if found is None:
        raise ValueError('缺少 info 字典')
    return found


def main():
    if len(sys.argv) != 2:
        raise SystemExit('用法: python info_hash.py <PATH>')
    data = Path(sys.argv[1]).read_bytes()
    info = extract_info(data)
    print('info bytes:', len(info))
    print('Info Hash:', hashlib.sha1(info).hexdigest())


if __name__ == '__main__':
    main()
将代码保存为 info_hash.py。运行时传入实际种子路径;<PATH> 表示需要替换的本地文件路径。
该示例用于提取和计算哈希,不是完整的种子格式验证器。生产级解析器还应严格检查字典键顺序、键重复、嵌套深度、整数范围及元数据大小,避免接受歧义编码或恶意输入。
运行计算并核对结果
先用 Python 构造一个确定性的测试种子,避免依赖网络下载或第三方种子文件。
from pathlib import Path

info = b'd4:name4:test6:lengthi4ee'
torrent = b'd4:info' + info + b'e'
Path('sample.torrent').write_bytes(torrent)
print('sample.torrent 已生成')
预期输出:
sample.torrent 已生成然后运行前面保存的脚本:
python info_hash.py sample.torrent预期结果:程序显示 info bytes: 27,随后显示一行由 40 个十六进制字符组成的 Info Hash。可以使用以下独立计算检查摘要是否一致:
import hashlib

info = b'd4:name4:test6:lengthi4ee'
print('info bytes:', len(info))
print('match:', len(hashlib.sha1(info).digest()) == 20)
print('Info Hash:', hashlib.sha1(info).hexdigest())
预期输出中前两行固定为:
info bytes: 27
match: True
第三行的十六进制值应与 info_hash.py 计算结果完全一致。这个测试验证了提取区间和摘要长度,但不代表该简化种子可用于实际下载。
真实种子还可以与支持 BitTorrent v1 的客户端或元数据解析工具显示的 Info Hash 对照。若种子是混合 v1/v2 格式,必须明确核对的是 v1 的 SHA-1 标识,而不是 v2 的 SHA-256 标识。
为什么重新编码可能改变哈希
SHA-1 接收的是字节序列,不理解字典字段的语义。即使两个 Bencode 字典解析后包含相同键值,只要原始字节不同,其 SHA-1 摘要通常也不同。
例如,以下两个字典的字段内容相同,但排列顺序不同:
import hashlib

first = b'd4:name4:test6:lengthi4ee'
second = b'd6:lengthi4e4:name4:teste'

print('相同字节:', first == second)
print('相同哈希:', hashlib.sha1(first).digest() == hashlib.sha1(second).digest())
预期输出:
相同字节: False
相同哈希: False
Bencode 规范要求字典键按字节序排序。这里故意构造了非规范排序的字典,用来说明字节差异对摘要的影响;不能把它当作推荐的种子编码方式。
常见的错误还包括将二进制内容先转换为 UTF-8 字符串、把 pieces 的原始摘要字节当作十六进制文本、修改 name 或 piece length 后继续沿用旧 Info Hash,以及解析后重新序列化却没有检查编码是否一致。
正确做法是读取原始二进制文件、定位完整 info 字节区间并直接计算 SHA-1。若确实需要修改 info,应重新生成符合规范的 Bencode,并将新摘要视为新的资源标识。
Info Hash 与实际资源发现的关系
在 BitTorrent v1 中,客户端使用 Info Hash 识别要加入的 Torrent Swarm。Tracker 请求、DHT 查找和磁力链接都可以围绕这个标识定位相关节点,但 Info Hash 本身不包含节点地址,也不能保证资源当前有人提供。
典型 v1 磁力链接使用 xt=urn:btih: 参数承载 Info Hash,通常采用 40 位十六进制或 32 位 Base32 表示。它们是同一个 20 字节摘要的不同文本表示。
验收时至少检查三个条件:提取的 info 是完整 Bencode 字典、计算得到的摘要长度为 20 字节、结果与目标种子的 v1 Info Hash 一致。只要原始 info 字节不变,修改顶层 Tracker 地址或注释不会直接改变这个摘要;一旦 info 字节变化,就必须重新计算。