
UI 视觉设计 / 系统课时
中文字体如何按字集压缩文件体积
中文字体如何按字集压缩文件体积
本课用一份可部署的 WOFF2 字体演示中文子集化,再比较按字符区间拆包的加载方式。完成后,你能从页面文案提取必需字形、检查标点和生僻字是否缺失,并通过浏览器网络面板确认压缩确实减少了字体传输量。
学习目标
- 使用 fontTools 把授权字体裁剪成指定字集的 WOFF2 文件。
- 区分单个字体子集与
unicode-range字符分片的适用场景。 - 验证字形覆盖、字体回退与真实页面的下载量。
从字体请求和实际文案确定字集
在浏览器开发者工具中打开 Network,勾选 Disable cache,刷新首页并用 Font 类型过滤。记录字体请求数、Transfer Size、加载发生的时机;再访问表单、订单详情等包含不同汉字的页面。不要只比较磁盘中的 TTF 与 WOFF2 大小,应比较优化前后浏览器实际传输的字体资源。
字集输入优先取产品的真实文案:固定导航与按钮、错误提示、数字和英文、全角标点(如“,。!?:;()《》”),以及姓名、地名、用户输入等动态字段。固定文案可以精准裁剪;动态文本无法预测时,应保留系统字体回退,或提供覆盖更全的备用字体资源。
提取字符并导出 WOFF2 子集
以下示例在装有 Python 3 的终端运行。将有合法使用与分发权限、且包含示例字符的字体放在当前目录,命名为 source.ttf。fontTools 负责保留必要字形和相关表,Brotli 用于生成 WOFF2。
python -m pip install fonttools brotli
python -c "from pathlib import Path; Path('ui-chars.txt').write_text('中文字体,订单支付成功!ABC123', encoding='utf-8')"
fonttools subset source.ttf --text-file=ui-chars.txt --flavor=woff2 --output-file=ui-subset.woff2
python -c "from pathlib import Path; print('已生成' if Path('ui-subset.woff2').stat().st_size > 0 else '空文件')"
预期输出(最后一条命令;安装及处理日志随环境不同):
已生成--text-file 读取 UTF-8 文案并按实际字符构造子集,不会因同一个字重复出现而复制字形。它适合内容相对固定的活动页、海报型落地页;如果把首页字表直接用于含任意姓名、地址的后台页面,后续新字符就可能落到系统字体,造成字形风格突变。
按字符范围拆包并按需加载
单子集通常只请求一个文件;分片方案将互不重叠的字集打成多个 WOFF2,再用 @font-face 的 unicode-range 规定各文件负责哪些字符。浏览器只在页面用到该范围字符时才请求对应文件,但命中一个字符也可能下载该分片的整个文件。
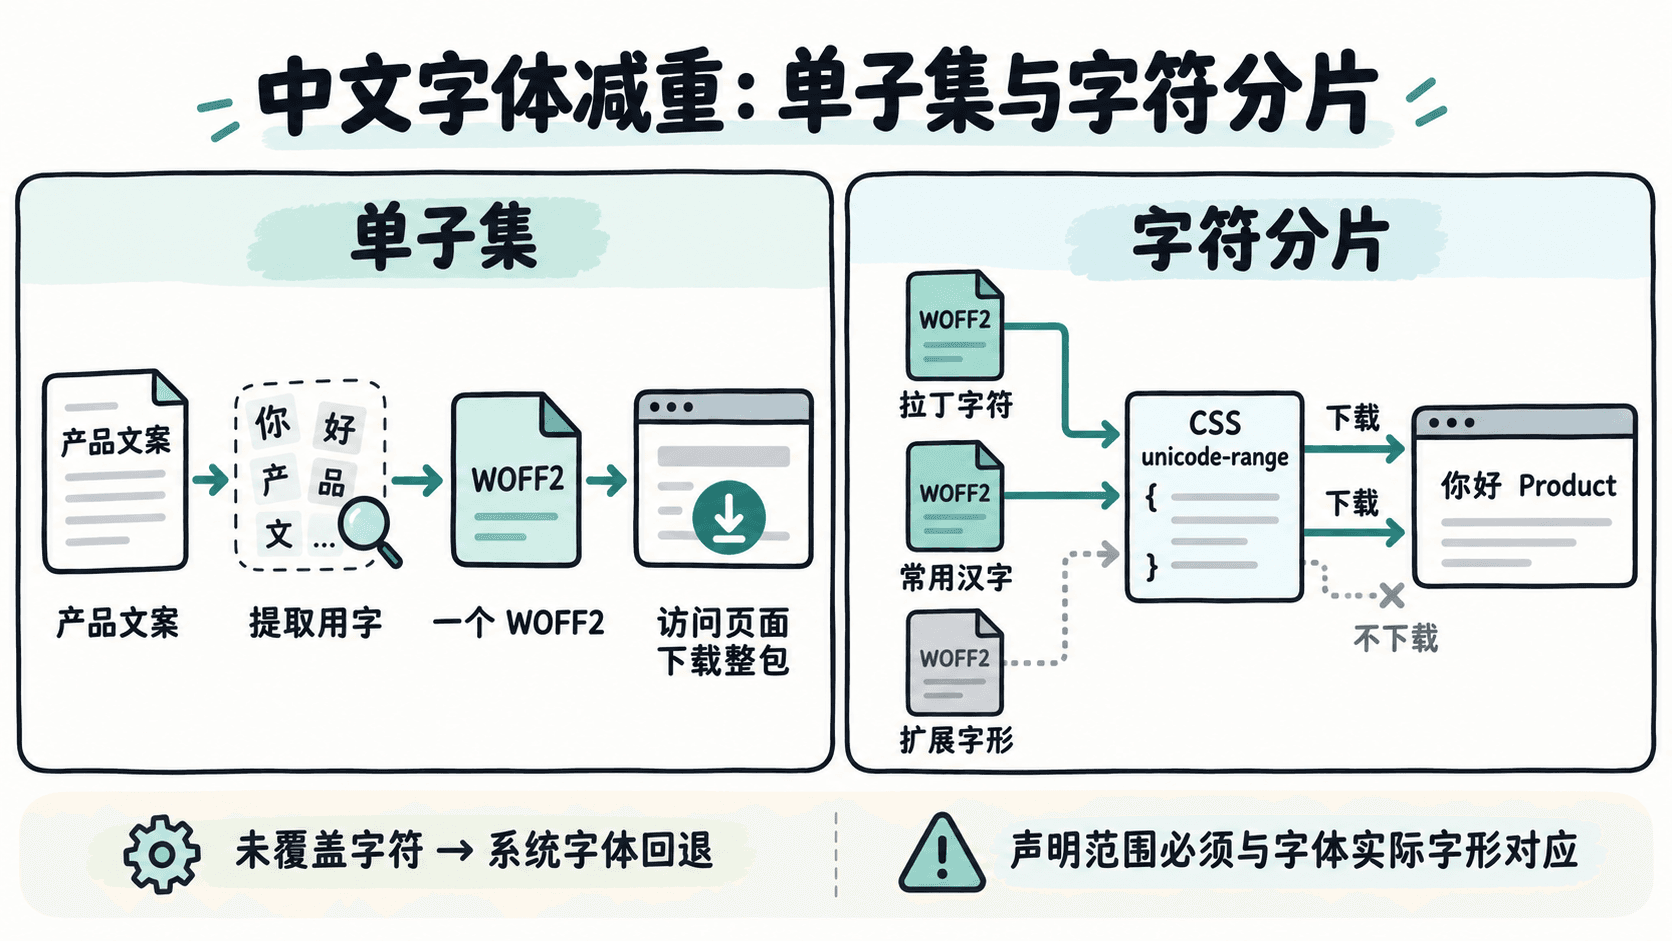
用下面的极小字集演示拆分机制:英文数字使用 ASCII 范围;中文片只收录“中、文、字、体”四字。生产环境不能直接沿用这四字示例,应根据页面用字生成完整且无重叠的分片清单。
fonttools subset source.ttf --unicodes=U+0020-007E --flavor=woff2 --output-file=ui-latin.woff2
fonttools subset source.ttf --unicodes=U+4E2D,U+6587,U+5B57,U+4F53 --flavor=woff2 --output-file=ui-han-demo.woff2
python -c "from pathlib import Path; print(all(Path(f).stat().st_size > 0 for f in ('ui-latin.woff2', 'ui-han-demo.woff2')))"
预期输出(源字体包含目标字形且处理成功时):
True把两个文件部署到网站的 /fonts/ 目录,再添加样式:
@font-face {
  font-family: "UIDemo";
  src: url("/fonts/ui-latin.woff2") format("woff2");
  font-weight: 400;
  font-display: swap;
  unicode-range: U+0020-007E;
}

@font-face {
  font-family: "UIDemo";
  src: url("/fonts/ui-han-demo.woff2") format("woff2");
  font-weight: 400;
  font-display: swap;
  unicode-range: U+4E2D, U+6587, U+5B57, U+4F53;
}

body {
  font-family: "UIDemo", "PingFang SC", "Microsoft YaHei", sans-serif;
}
预期结果:只显示“中文字体”的区域会按汉字范围请求中文片;显示 ABC123 的区域会用到拉丁片。未列入的中文不会从这两个文件得到字形,由后备字体承担。unicode-range 不是压缩命令,真正的字形裁剪必须先在字体文件中完成;详细规则见 MDN 的 unicode-range 文档。
检查覆盖率与传输收益
使用字体的 cmap 表核对样本文案,避免“文件已生成”被误认为“没有缺字”。下面命令检查前面生成的单子集:
from pathlib import Path
from fontTools.ttLib import TTFont

text = Path("ui-chars.txt").read_text(encoding="utf-8")
font = TTFont("ui-subset.woff2")
supported = font.getBestCmap() or {}
missing = sorted({c for c in text if ord(c) not in supported})
font.close()
print("覆盖通过" if not missing else "缺字:" + "".join(missing))预期输出(source.ttf 包含样本文案全部字符时):
覆盖通过上线前用“常用汉字+全半角标点+数字英文+生僻姓名字+动态字段”组成回归样本,逐页检查实际渲染和浏览器 Network。尤其要检查 ①、·、𠮷 等容易漏掉的字符:未覆盖时应能阅读且回退字形可接受,而不是空白方框。font-display: swap 可以优先显示后备字体,但仍需观察字体替换造成的布局跳动。
验收表建议至少记录首页及一个动态详情页在禁用缓存时的字体请求数、传输 KB、首次文字显示时间与缺字数。例如基线 2000 KB、优化后 320 KB,传输下降 84%;这是计算示例,不是任何字体的固定压缩率。如果把字体切得过碎,多个 HTTP 请求和重复字形也可能抵消收益。对短期固定页面优先单子集;对跨页面、字符使用差异明显的中文产品,再用真实文本统计决定分片粒度。命令参数可对照 fontTools subset 文档。