
服务注册与分布式协调 / 系统课时
完成上线与运行验收
完成上线与运行验收
上线验收要把“能部署”提升为“历史可重放、版本可回退、容量有余量、告警能触发、值守能处置”。最终产物不是一张勾选表,而是一组可以阻断发布、也能在运行期复用的客观门禁。
学习目标
- 建立覆盖 Replay、Worker 发布、容量、告警和故障处置的上线验收门禁
- 用最小运行检查确认 Worker 已就绪,并把动态容量数据与既有基线对比
- 为回滚、告警升级和常见故障明确责任人与停止条件
把上线拆成连续门禁
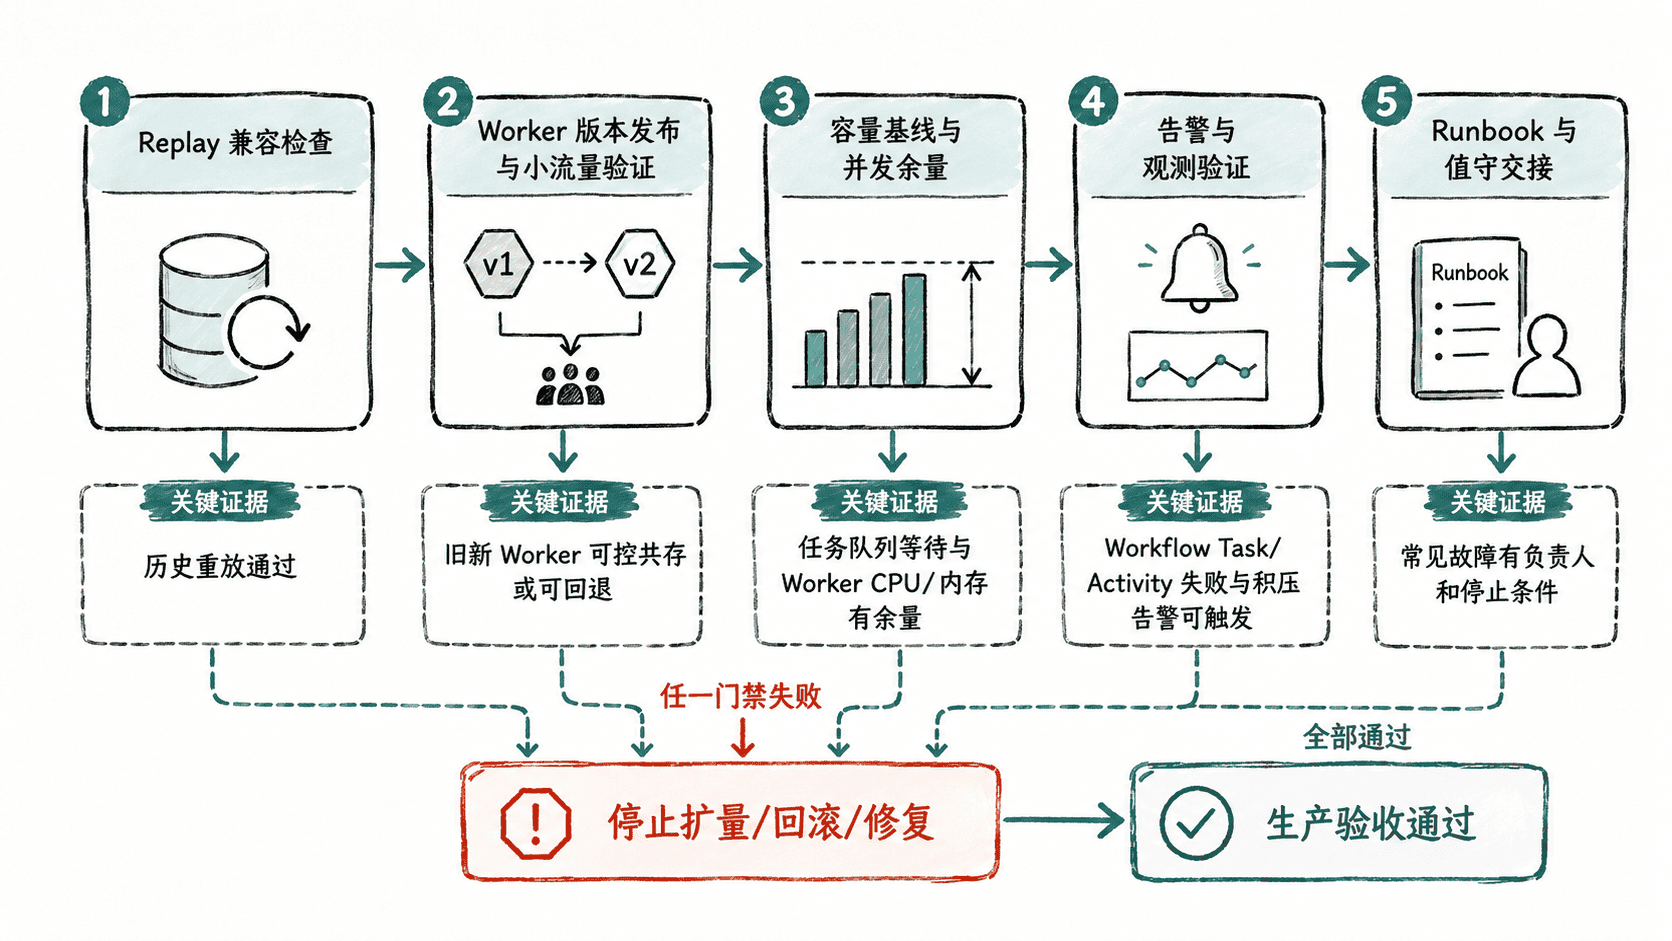
可靠编排项目建议按“代码兼容 → Worker 发布 → 容量验证 → 可观测性 → 值守准备”顺序验收。前一个门禁未通过时不要继续扩大流量,因为后续数据会被前置问题污染。
先阻断不兼容的 Workflow 代码
只要线上还有旧 Workflow History,发布前就必须用当前代码做 Replay 检查。CI 中保留代表性历史,尤其是长期运行、走过补偿分支、发生过 Activity 重试和收到过取消或外部事件的历史。任何 nondeterminism 都应直接阻断发布,而不是寄希望于新 Worker 上线后再观察。
Worker 版本发布要保证旧版本仍有明确的接管范围和回退路径。使用当前 Temporal 集群支持的 Worker Versioning 或 Worker Deployment 机制时,先让新版本承接受控流量,确认没有新增 Workflow Task 失败、任务队列等待异常或错误率抬升,再扩大范围。不要在缺少版本路由和 Replay 证据时直接替换全部 Worker。
验证 Worker 就绪与基础容量
下面的命令适合放进部署后的运行检查。它不替代 Temporal 指标,但能先确认 Kubernetes 层的 Worker 已稳定运行,并给容量核对提供 CPU、内存和副本数基线。
set -euo pipefail

# 确认发布完成,并核对就绪副本是否达到期望值
kubectl -n <K8S_NAMESPACE> rollout status deployment/<WORKER_DEPLOYMENT> --timeout=120s
kubectl -n <K8S_NAMESPACE> get deployment/<WORKER_DEPLOYMENT> -o jsonpath='readyReplicas={.status.readyReplicas} desiredReplicas={.spec.replicas}{"\n"}'
# 采集 Worker 即时资源占用,与同负载下的容量基线比较
kubectl -n <K8S_NAMESPACE> top pods -l app=<WORKER_LABEL>
预期输出
deployment "<WORKER_DEPLOYMENT>" successfully rolled out
readyReplicas=<N> desiredReplicas=<N>
NAME                 CPU(cores)   MEMORY(bytes)
<WORKER_POD>         <CPU>        <MEMORY>
CPU、内存、副本数和 Pod 名称会随环境变化;kubectl top 还依赖集群已提供 Metrics API。这里的通过条件不是固定阈值,而是“与同等负载下的已知基线相比没有异常抬升,并且在预估峰值下仍有明确余量”。容量验收还应同时观察 Workflow Task 与 Activity Task 的 schedule-to-start 延迟、任务队列积压、Worker slot 使用情况以及下游限流。
把告警与运行手册一起验收
告警必须能回答“谁需要处理、多久内处理、处理到什么状态”。至少覆盖 Workflow Task 持续失败、Activity 失败或重试异常、任务队列等待升高、Worker 不可用、下游错误率上升和 Saga 补偿失败。告警阈值应来自容量基线和业务 SLO,而不是直接照搬默认值。
运行手册则要把高频故障写成可执行路径:先看哪些指标,再查哪类 History 或日志,什么条件下允许重试、取消、补偿或回滚 Worker,什么条件下必须停止扩量。对“强行终止 Workflow”“手工修改业务状态”这类高风险操作,应明确审批和证据留存要求。
| 验收项 | 通过标准 | 阻断条件 |
|---|---|---|
| Replay | 代表性历史在当前代码上无 nondeterminism | 任一历史无法确定性重放 |
| Worker 发布 | 新版本受控接流且可回退 | Workflow Task 失败或等待显著恶化 |
| 容量 | 峰值负载下仍有可解释余量 | 队列积压持续增长或资源打满 |
| 告警 | 关键故障能触发并路由到负责人 | 告警缺失、噪声过高或无人接手 |
| Runbook | 常见故障有定位、止损、恢复和回滚步骤 | 关键操作依赖个人经验 |
用一次完整演练做最终签字
正式验收前再跑一次端到端演练:启动真实业务流程,发布新 Worker,小幅扩大流量,注入一个可恢复故障,确认告警触发、值守人员按 Runbook 处理、Workflow 最终收敛,并验证回滚路径仍可用。只有当 Replay、版本、容量、告警和处置证据都能被复查时,这套编排才具备上线后长期运行的基本条件。