
服务注册与分布式协调 / 系统课时
构建 Temporal 指标与告警
构建 Temporal 指标与告警
Temporal 生产监控不能只看“服务是否存活”。真正需要回答的是任务有没有排队、Worker 是否及时取走任务、失败是否增加,以及资源是否已经限制吞吐。本节建立从 Task Queue 到 Worker 再到业务失败的指标链,并把它转换成可执行告警。
学习目标
- 用 backlog、Schedule-to-Start、失败和 Worker 容量建立分层监控
- 区分“业务失败”“重试尝试”和“Worker 容量不足”的信号
- 为告警设置持续时间、组合条件和可操作的阈值
先建立因果链而不是堆指标
排障时最有价值的顺序是:队列是否积压 → 任务等待是否升高 → Worker 是否缺容量 → Activity 是否反复失败 → Workflow 是否最终失败。单看 CPU 或失败计数,很容易把下游症状误当根因。
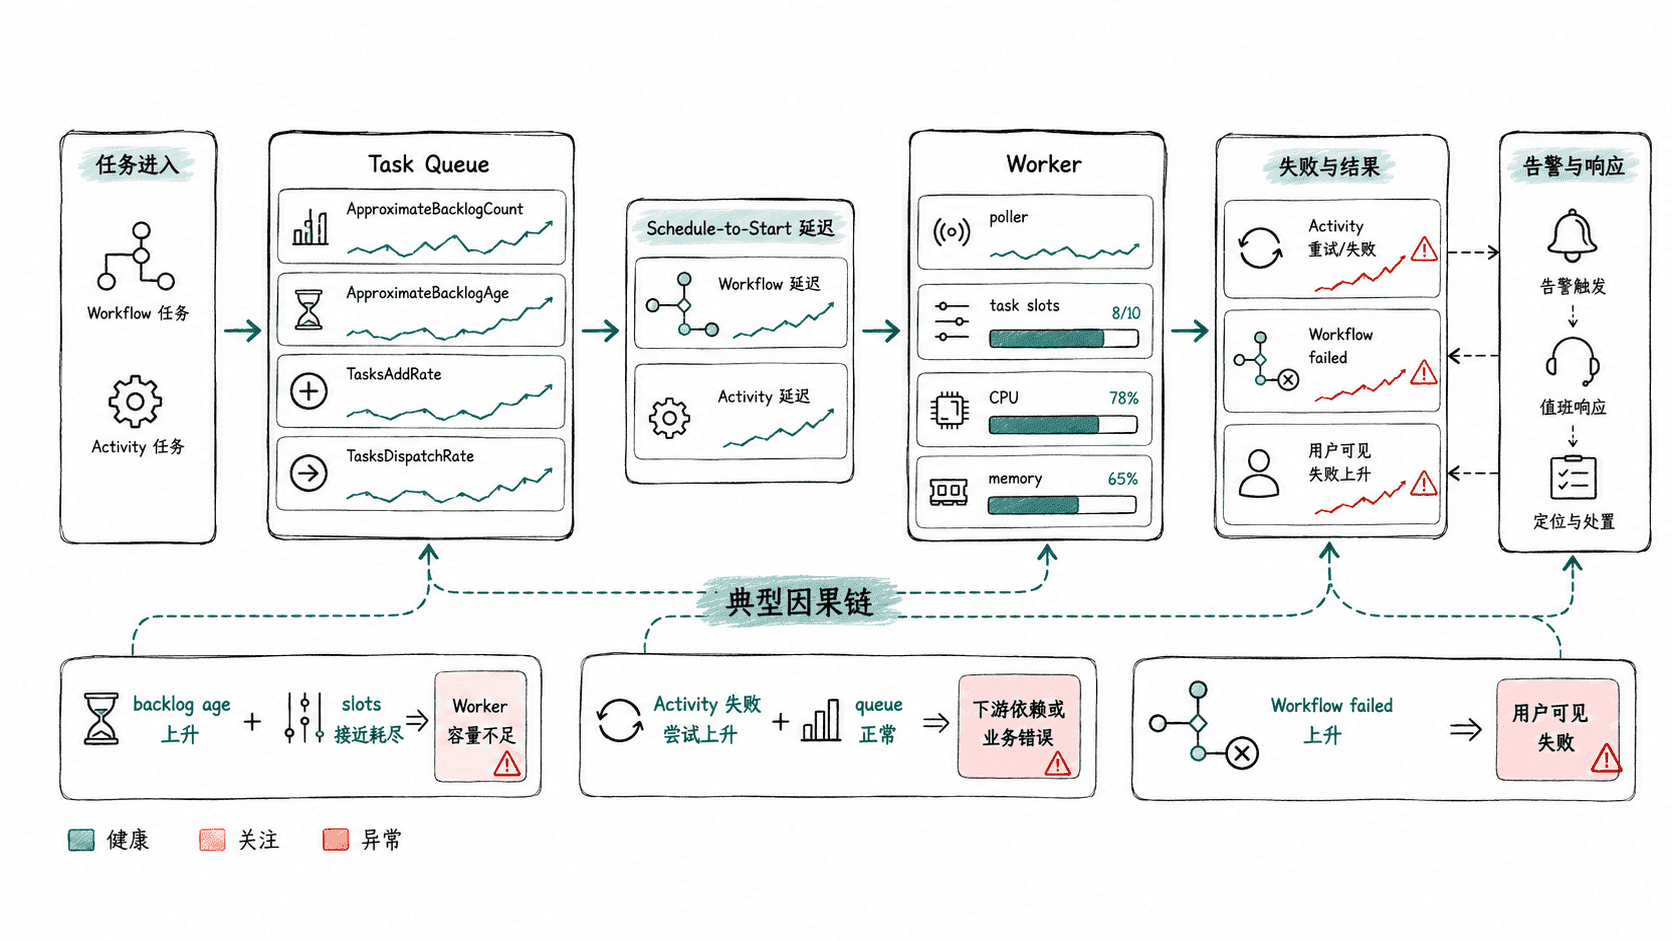
选择能解释问题的信号
Task Queue 健康优先看 ApproximateBacklogCount 和 ApproximateBacklogAge,并结合 TasksAddRate 与 TasksDispatchRate 判断积压是在增长还是消退。计数是近似值,因此告警更适合依赖“持续增长”和“最老任务等待时间”而不是瞬时单点。
Worker 侧可重点采集 temporal_workflow_task_schedule_to_start_latency、temporal_activity_schedule_to_start_latency、temporal_worker_task_slots_available、temporal_worker_task_slots_used、temporal_workflow_failed 与 temporal_activity_execution_failed。同时保留进程或容器 CPU、内存、重启次数,才能解释 Worker 为什么取不动任务。
Activity 的“重试压力”不要只用最终失败数代替。自托管 Temporal Service 可结合失败尝试类指标,例如 activity_task_fail 与终态失败类指标区分“正在重试”和“最终失败”;如果使用 Temporal Cloud,则应以当前 Cloud Metrics 暴露的对应指标为准。
用查询先验证队列现状
在写告警前,先对实际 Task Queue 做一次检查,确认名称、任务类型和 Worker 是否符合预期。
temporal task-queue describe --task-queue orders预期结果:
Task Queue: orders
<workflow/activity task queue status>
<approximate backlog and poller information>
实际输出字段会随 Temporal CLI 版本和 Task Queue 类型不同。这里的目的不是记住格式,而是确认“队列存在、Worker 正在轮询、backlog 是否持续增长”,再把相同维度映射到监控系统。
把告警写成组合条件
固定阈值应来自业务预算。例如订单要求 30 秒内开始处理,则 Activity Schedule-to-Start 的告警阈值应明显低于 30 秒,并配合持续时间避免瞬时尖峰。推荐至少建立三类规则:排队、容量和失败。
下面是 Prometheus 告警规则片段示例。它假设你已经建立了三个稳定 recording rule:队列最老任务年龄、Activity P95 Schedule-to-Start、Workflow 五分钟失败率。这样可以把不同 SDK 或 Cloud/Self-hosted 的原始指标差异隔离在 recording rule 层。
groups:
  - name: temporal-production
    rules:
      - alert: TemporalTaskQueueBacklogAging
        expr: temporal:task_queue_backlog_age_seconds{task_queue="orders"} > 15
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "orders Task Queue 最老任务等待超过 15 秒"

      - alert: TemporalActivityDispatchSlow
        expr: temporal:activity_schedule_to_start_p95_seconds{task_queue="orders"} > 10
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "orders Activity P95 Schedule-to-Start 超过 10 秒"

      - alert: TemporalWorkflowFailureRateHigh
        expr: temporal:workflow_failed_rate5m{workflow_type="OrderWorkflow"} > 0.01
        for: 10m
        labels:
          severity: critical
        annotations:
          summary: "OrderWorkflow 五分钟失败率超过 1%"
生效后预期行为:只有条件连续满足 for 指定时长才进入告警状态;阈值下恢复后自动解除。Prometheus 规则加载成功时可通过规则检查工具或 Prometheus Rules 页面确认三条规则已注册。
为每个告警绑定排障动作
告警必须告诉值班人员下一步看哪里。backlog age 上升时先检查 Worker 数量、poller 和 slots,再看 CPU/内存;Schedule-to-Start 上升但资源未满时,检查 Task Queue 路由、Worker 版本和网络;Activity 失败尝试增加而队列正常时,优先检查下游依赖、超时与重试策略。
Workflow 最终失败应按 workflow_type 和业务重要性分级,而不是所有类型一个阈值。对低流量 Workflow,百分比容易失真,可以增加最小样本条件;对高流量核心流程,则同时监控失败率和绝对失败数。
最终面板应让一个人从同一时间窗看到任务进入、排队、调度、Worker 容量和失败结果。这样告警不是“某个数字变红”,而是能直接指向扩容、修复路由、检查下游依赖或处理业务失败的具体动作。