
服务注册与分布式协调 / 系统课时
实现 Worker 优雅关闭
实现 Worker 优雅关闭
滚动发布真正要解决的不是“让进程退出”,而是让 Worker 收到终止信号后停止继续取新任务,并给已领取任务一个可控的收尾窗口。下面以 Temporal Go SDK 为例,把 WorkerStopTimeout、Activity 收尾和容器终止窗口对齐起来。
学习目标
- 配置
WorkerStopTimeout并正确处理SIGINT、SIGTERM - 理解关闭窗口内已领取任务与 Activity 上下文的行为
- 让 Kubernetes 的终止宽限期覆盖 Worker 的收尾时间
先把关闭窗口对齐
Worker 进入停止流程后,重点是“先停新增,再处理在途”。WorkerStopTimeout 给 Worker 一个等待窗口;Activity 还可以通过 activity.GetWorkerStopChannel 感知 Worker 正在关闭。若窗口耗尽,Activity 上下文会被取消,进程继续退出。
这不是 exactly-once 保证。进程被强杀、节点故障、关闭窗口不足或任务尚未确认时,Temporal 仍可能让任务在其他 Worker 上继续或重试,所以 Activity 依然要按幂等、可重试的方式设计。
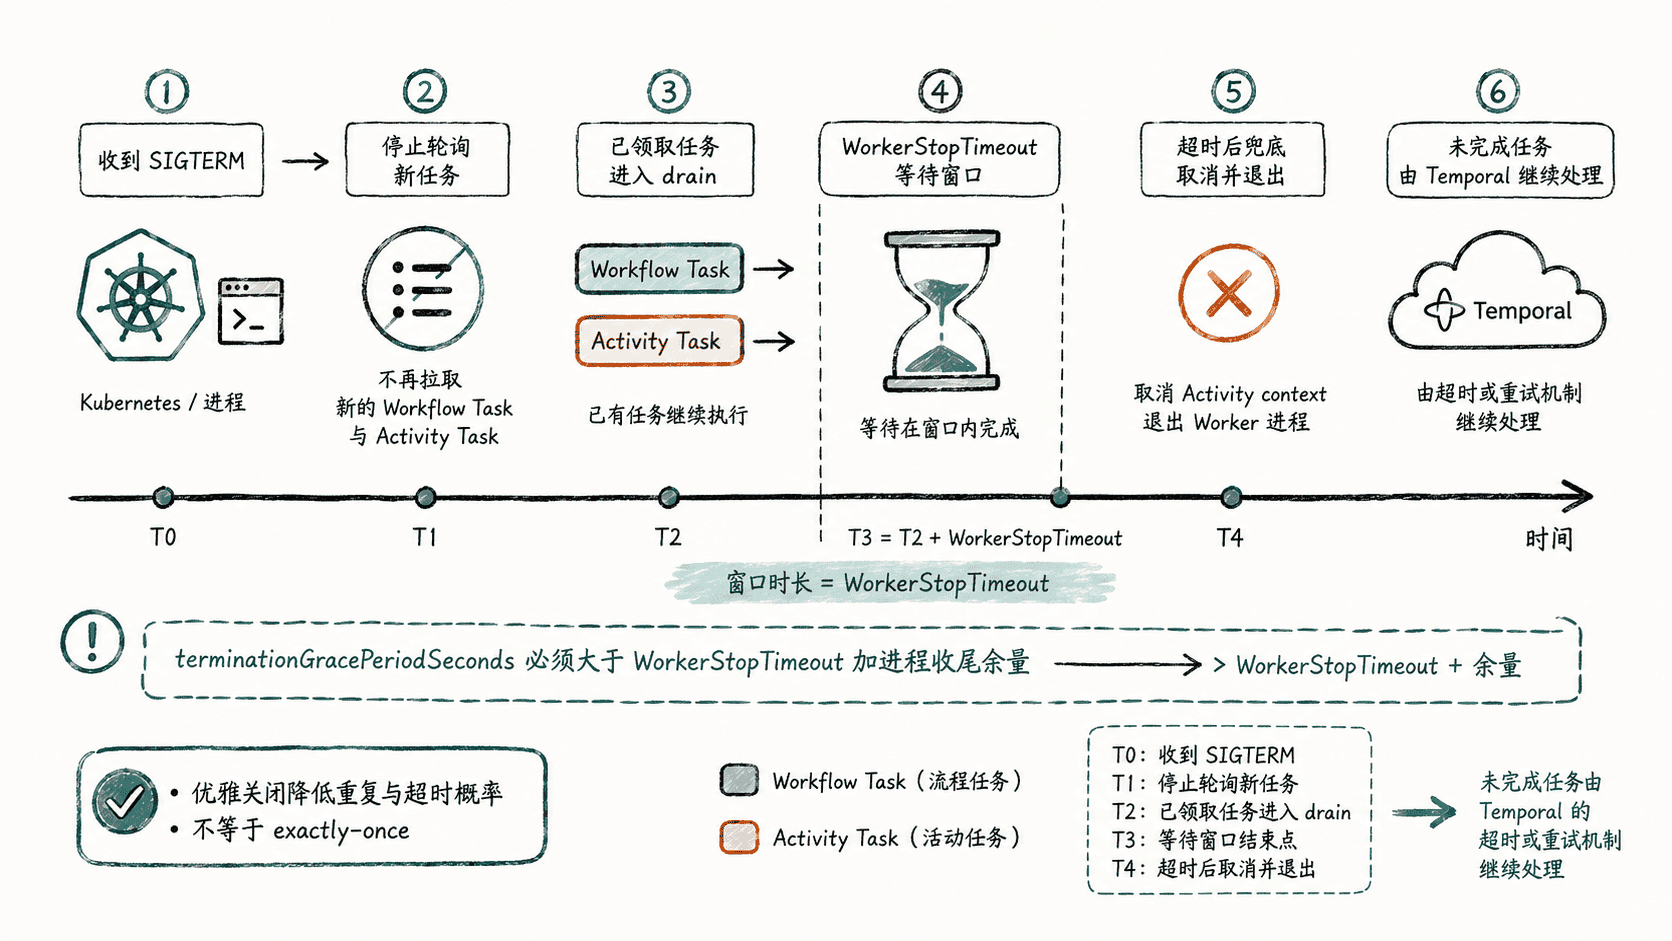
配置 Go Worker 的关闭策略
下面的完整示例注册一个 Workflow 和一个短 Activity。Activity 正常执行约 5 秒;如果 Worker 在执行期间收到终止信号,它会获知停止事件,并尝试在剩余窗口内完成一个很短的收尾动作。
package main

import (
	"context"
	"log"
	"time"

	"go.temporal.io/sdk/activity"
	"go.temporal.io/sdk/client"
	"go.temporal.io/sdk/worker"
	"go.temporal.io/sdk/workflow"
)

func CleanupWorkflow(ctx workflow.Context) error {
	ctx = workflow.WithActivityOptions(ctx, workflow.ActivityOptions{
		StartToCloseTimeout: 30 * time.Second,
	})
	return workflow.ExecuteActivity(ctx, CleanupActivity).Get(ctx, nil)
}

func CleanupActivity(ctx context.Context) error {
	select {
	case <-time.After(5 * time.Second):
		return nil
	case <-activity.GetWorkerStopChannel(ctx):
		// 只做能在关闭窗口内完成的短收尾,避免无限拖住进程退出。
		timer := time.NewTimer(2 * time.Second)
		defer timer.Stop()
		select {
		case <-timer.C:
			return nil
		case <-ctx.Done():
			return ctx.Err()
		}
	case <-ctx.Done():
		return ctx.Err()
	}
}

func main() {
	c, err := client.Dial(client.Options{})
	if err != nil {
		log.Fatal(err)
	}
	defer c.Close()

	w := worker.New(c, "orders", worker.Options{
		WorkerStopTimeout: 30 * time.Second,
	})
	w.RegisterWorkflow(CleanupWorkflow)
	w.RegisterActivity(CleanupActivity)

	log.Println("worker started; waiting for SIGINT/SIGTERM")
	if err := w.Run(worker.InterruptCh()); err != nil {
		log.Fatal(err)
	}
	log.Println("worker stopped cleanly")
}
假设项目已安装 Temporal Go SDK,且 Temporal Frontend 可访问。启动 Worker 后,从另一终端向实际进程发送终止信号:
kill -TERM <PID>预期结果:
kill 成功时通常没有标准输出;Worker 日志随后出现:
<TIME> worker stopped cleanly
<PID> 和 <TIME> 以实际值为准。若此时正有 Activity 执行,它可以在 WorkerStopTimeout 窗口内完成;超出窗口后不要期待进程继续无限等待。
把容器终止窗口留够
在 Kubernetes 中,terminationGracePeriodSeconds 应大于 WorkerStopTimeout,还要给日志、指标导出器和连接关闭留余量。下面把 Worker 等待设为 30 秒,Pod 宽限期设为 45 秒。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: temporal-worker
spec:
  template:
    spec:
      terminationGracePeriodSeconds: 45
      containers:
        - name: worker
          image: example/temporal-worker:<ID>
生效行为:Kubernetes 终止 Pod 时会向容器进程发送终止信号,并在宽限期耗尽后强制结束。镜像入口应让 Worker 进程直接接收信号,避免被不会转发信号的 shell 包装层截断。
用滚动发布验证关闭链路
对测试 Deployment 发起滚动重启,并等待新副本就绪:
kubectl rollout restart deployment/temporal-worker
kubectl rollout status deployment/temporal-worker
预期输出:
deployment.apps/temporal-worker restarted
deployment "temporal-worker" successfully rolled out
验证时同时观察 Worker 日志、Activity 超时/重试指标和 Task Queue backlog。理想结果是旧 Pod 收到终止信号后平滑退出,新 Pod 接管后吞吐恢复,而不是在发布时间窗出现明显的 Activity Timeout 或重试尖峰。
如果 Activity 本身可能运行数分钟,不应单纯把 WorkerStopTimeout 拉得非常长。更稳妥的做法是让 Activity 定期 heartbeat、保存可恢复进度,并把单次不可中断的临界区控制在可接受的关闭窗口内。