
服务注册与分布式协调 / 系统课时
使用 Continue-As-New 控制长历史
使用 Continue-As-New 控制长历史
本课解决 Workflow 长时间运行后事件历史持续膨胀的问题。通过 Continue-As-New,Workflow 在保留必要业务状态的同时启动一个新的 Run,让后续事件写入新历史,从而避免单个 Run 的 History 无限增长。
学习目标
- 理解 Continue-As-New 与普通 Workflow 重启、Retry 的区别
- 能判断哪些状态必须传给新的 Run,哪些状态无需跨 Run 保留
- 能在循环、Signal 累积或历史体积增长时安全执行 Continue-As-New
Continue-As-New 在解决什么问题
Temporal Workflow 的每次关键推进都会形成事件历史。一个 Workflow 如果长期运行,并不断接收 Signal、执行 Activity 或等待 Timer,History 会持续增加,读取和恢复成本也会随之上升。
Continue-As-New 不会把当前 Workflow 当成失败,也不是简单重新调用一个普通函数。它会结束当前 Run,并创建一个新的 Run;新的 Run 从传入的输入状态开始执行,而旧 Run 的历史不再继续增长。
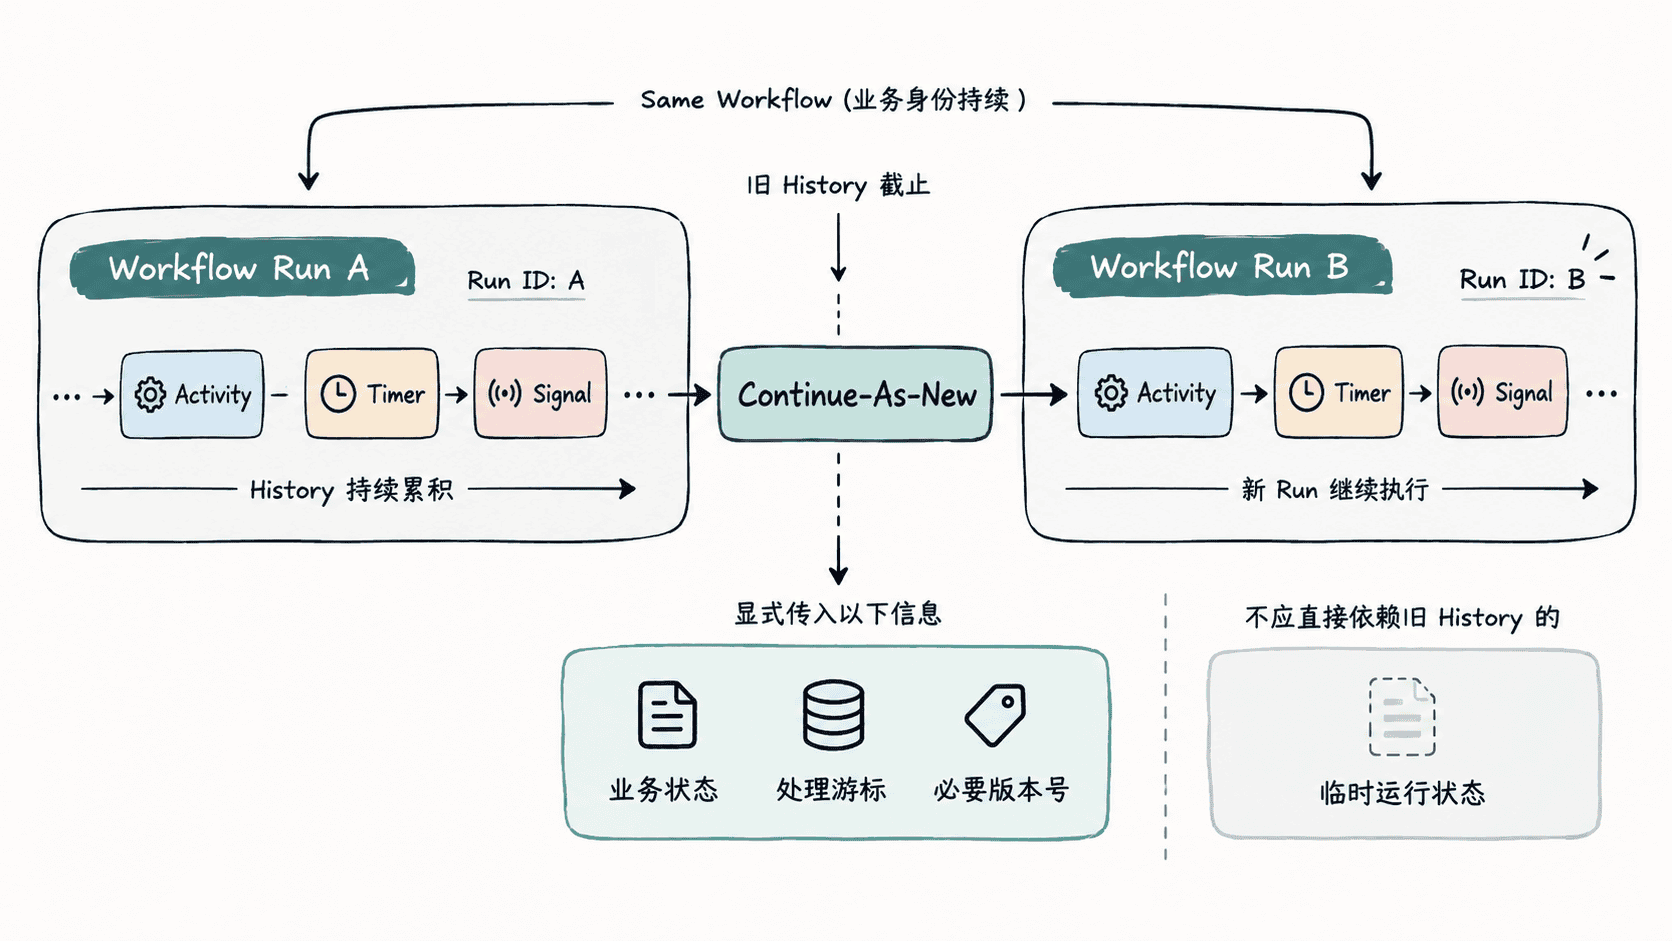
选择继续新 Run 的时机
最常见的触发条件有三类:循环处理次数达到阈值、累计 Signal 数量达到阈值,以及通过业务观测发现 History 已经增长到需要主动切段的程度。
不要只用“运行了很多天”作为唯一条件。时间本身并不直接等于历史体积;一个长期等待 Timer 的 Workflow 可能历史很小,而一个高频接收 Signal 的 Workflow 即使运行时间不长,也可能快速积累大量事件。
对于循环型 Workflow,可以维护一个简单计数器。达到阈值后直接返回 workflow.NewContinueAsNewError,并把下一 Run 需要的状态作为新的 Workflow 参数传入。
主示例:按处理批次切换 Run
下面是一个片段示例。假设 Workflow 每次从输入游标继续处理任务,并在处理到固定批次后执行 Continue-As-New。这样可以把一个无限循环拆成多个有限历史的 Run。
package workflow

import "go.temporal.io/sdk/workflow"

type BatchState struct {
	Cursor      string
	Processed   int
	WorkflowVer int
}

const maxEventsPerRun = 500

func WorkerWorkflow(ctx workflow.Context, state BatchState) error {
	for {
		// 每完成一批业务处理,就更新可恢复的游标。
		state.Cursor = nextCursor(state.Cursor)
		state.Processed++

		if state.Processed >= maxEventsPerRun {
			return workflow.NewContinueAsNewError(ctx, WorkerWorkflow, BatchState{
				Cursor:      state.Cursor,
				Processed:   0,
				WorkflowVer: state.WorkflowVer,
			})
		}

		if workflow.IsReplaying(ctx) {
			continue
		}
	}
}

func nextCursor(cursor string) string {
	if cursor == "" {
		return "cursor-1"
	}
	return cursor + "-next"
}
预期结果
Run A: Processed reaches 500 -> Continue-As-New
Run B: starts with the latest Cursor -> Processed resets to 0
Run C: repeats the same handoff pattern when the next threshold is reached
上面的 nextCursor 只是演示状态交接,不代表真实业务分页算法。生产代码必须让游标具有稳定语义,例如最后成功处理的业务主键、消息位置或时间窗口。
更关键的是,BatchState 中保存的是下一 Run 真正需要的事实。旧 Run 里的临时对象、缓存引用、已经完成的 Activity 结果等,不应该因为“之前在内存里存在过”就假设会自动延续。
与 Signal、Timer 和循环配合
Continue-As-New 最有价值的地方不是单独调用一次 API,而是把它放进长期运行的事件循环中。例如 Workflow 持续等待 Signal,每收到一个事件就更新状态;当累计事件达到阈值后,把尚未完成的业务状态带入新 Run。
这里要特别注意“阈值判断发生在哪里”。如果阈值依赖 Signal 数量,应把计数器作为 Workflow 确定性状态维护,而不是依赖 Worker 进程级变量。Workflow 可能发生恢复、重放或重新部署,进程内变量都不是可靠的持久状态。
如果 Workflow 同时等待 Timer 和 Signal,也应把“下一次 Continue-As-New 时应该从哪里继续”表示成显式业务状态。例如保存待处理队列游标、当前阶段和重试上下文,而不是试图读取旧 Run 的事件来恢复隐含状态。
Continue-As-New 的关键边界
第一,新的 Run 会拥有新的 Run ID。因此需要区分“同一个业务 Workflow”与“同一个具体 Run”。业务系统通常应该继续使用 Workflow ID 识别业务实体,而在审计或排查时再记录 Run ID。
第二,Continue-As-New 是一个确定性的 Workflow 控制流结果。不要在普通 goroutine 或 Activity 中随意调用;应由 Workflow 代码根据确定性的业务状态决定何时交接。
第三,跨 Run 状态必须足够小且稳定。把一个不断增长的完整数组重新作为输入传给新 Run,只是把“历史增长”换成了“输入增长”,并没有真正解决长期积累问题。更好的方式是保存摘要、游标、版本和少量待处理状态,把长期数据放在适合持久化的业务存储中。
验证长流程是否真正受控
验证时可以观察一个 Workflow 是否形成连续 Run,并检查每次 Continue-As-New 后的 Run ID 是否变化、业务游标是否连续、累计处理结果是否没有重复或遗漏。
一个可靠的验收条件是:无论 Workflow 在第几个 Run,给定相同的业务输入,下一步都能仅依赖当前 Run 输入和后续确定性事件继续执行;不需要“回看已经结束的旧 Run”才能知道应该做什么。
最终应把 Continue-As-New 看成一种历史分段机制:当前 Run 负责近期执行历史,显式状态负责跨 Run 的业务连续性。只要交接状态最小、游标明确、阈值可观测,长流程就能在保持业务身份连续的同时控制 History 增长。