
服务注册与分布式协调 / 系统课时
使用资源型 Slot Supplier 调优
使用资源型 Slot Supplier 调优
固定并发槽位很容易在实例规格变化或突发负载下失真:小实例可能被压垮,大实例又可能闲置。本篇用资源型 Slot Supplier 把 CPU、内存利用率变成动态发槽信号,并给出一套可验证的调优顺序。
学习目标
- 理解资源型 Slot Supplier 如何依据 CPU、内存决定是否继续发放执行槽位
- 使用 Go SDK 配置 Resource-Based Tuner,并避免与旧并发上限参数冲突
- 根据排队延迟、槽位和主机资源指标判断应该调目标值还是水平扩容
Slot Supplier 实际控制什么
Temporal Worker 在轮询到 Task 之前需要先获得对应类型的执行槽位。固定大小 Supplier 只看预设上限;资源型 Supplier 会持续观察本机或容器的 CPU、内存利用率,再决定是否允许更多 Workflow Task、Activity Task、Local Activity 或 Nexus Task 进入执行阶段。
资源目标不是硬限制。新 Task 获得槽位后会消耗多少 CPU 和内存无法提前精确知道,因此实际利用率可能短时越过目标值。生产配置要保留余量,尤其不能把内存目标直接设到容器 memory limit 附近。
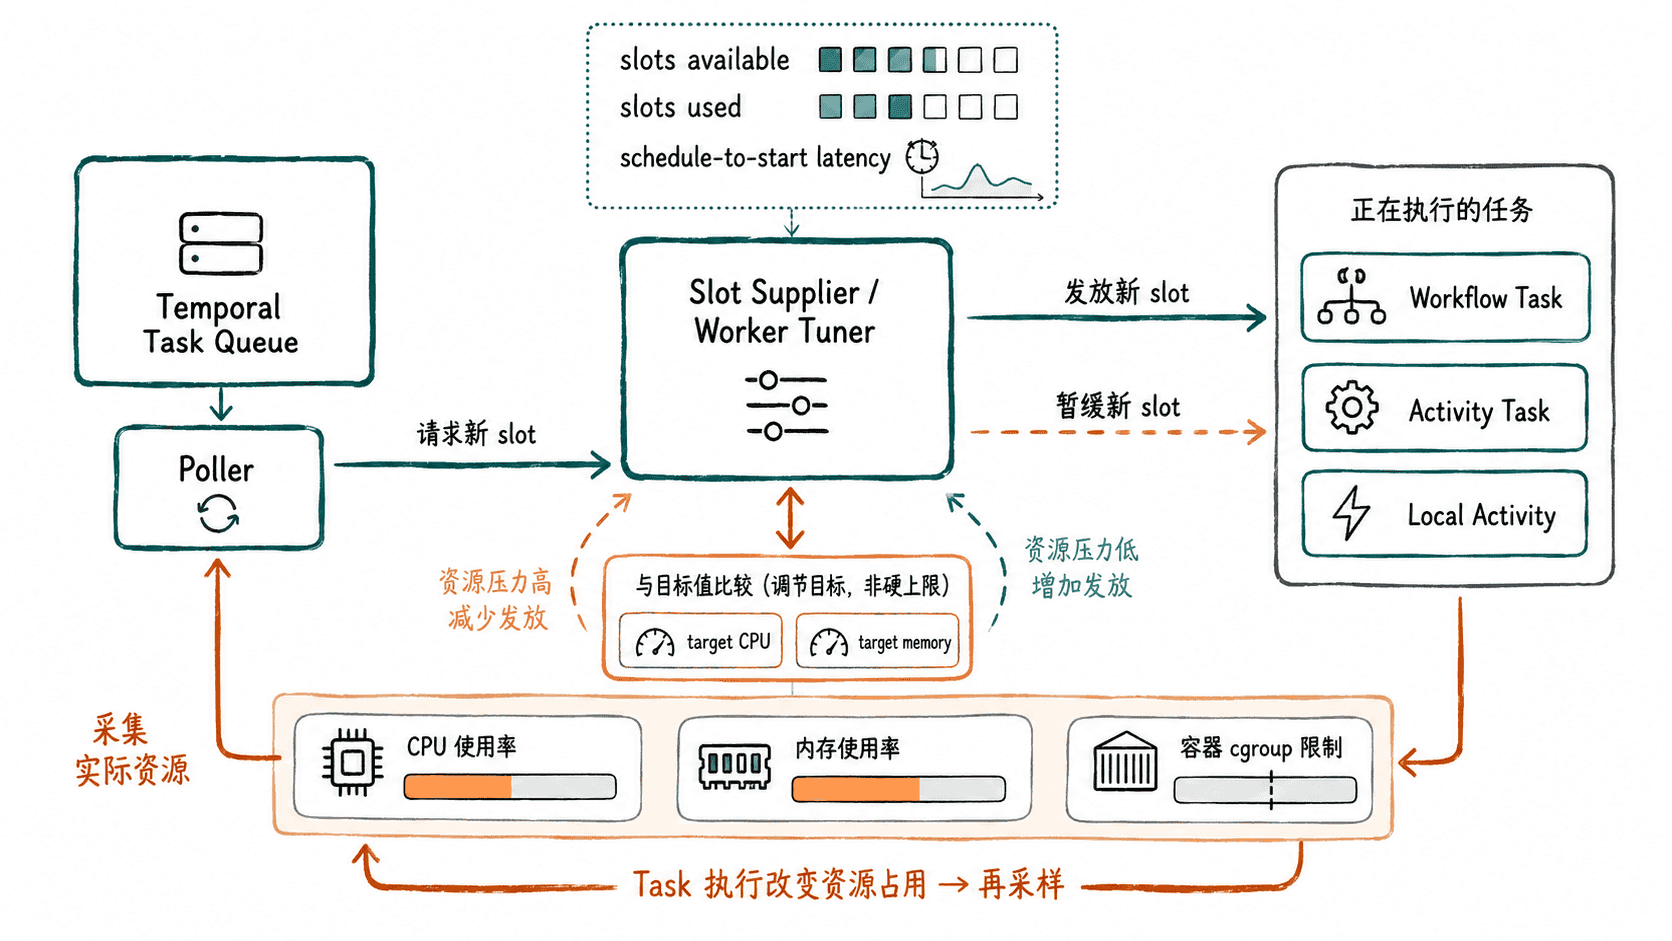
在容器环境中,资源型调节会依据信息提供器看到的 CPU 和内存约束工作,因此同一套 Worker 配置可随 Pod 规格变化调整可用槽位。但它解决的是单个 Worker 的本机容量利用率,不会替你决定何时增加 Worker 副本。
配置 Resource-Based Tuner
下面示例假设本机已有 Temporal Service,地址为 127.0.0.1:7233,Go 模块已经加入当前 go.temporal.io/sdk 与 go.temporal.io/sdk/contrib/sysinfo 依赖。TargetCpu 和 TargetMem 都使用 0~1 的比例值。
package main

import (
    "log"

    "go.temporal.io/sdk/client"
    "go.temporal.io/sdk/contrib/sysinfo"
    "go.temporal.io/sdk/worker"
    "go.temporal.io/sdk/workflow"
)

func HealthWorkflow(ctx workflow.Context) (string, error) {
    return "ok", nil
}

func main() {
    c, err := client.Dial(client.Options{HostPort: "127.0.0.1:7233"})
    if err != nil {
        log.Fatal(err)
    }
    defer c.Close()

    // 预留 CPU 与内存余量,避免把资源目标当成硬上限。
    tuner, err := worker.NewResourceBasedTuner(worker.ResourceBasedTunerOptions{
        TargetCpu:    0.80,
        TargetMem:    0.75,
        InfoSupplier: sysinfo.SysInfoProvider(),
    })
    if err != nil {
        log.Fatal(err)
    }

    w := worker.New(c, "resource-tuned", worker.Options{
        Tuner: tuner,
    })
    w.RegisterWorkflow(HealthWorkflow)

    log.Println("worker starting with resource-based tuner")
    if err := w.Run(worker.InterruptCh()); err != nil {
        log.Fatal(err)
    }
}
预期输出
<TIME> worker starting with resource-based tuner实际日志时间和 SDK 自身附加日志可能不同;看到这行后进程会持续运行并轮询 resource-tuned Task Queue。若 Worker 初始化时报并发配置冲突,先检查是否还设置了 MaxConcurrentWorkflowTaskExecutionSize、MaxConcurrentActivityExecutionSize 或 MaxConcurrentLocalActivityExecutionSize:使用 Tuner 时不要再同时使用这组旧式固定并发选项。
用指标闭环调目标值
资源型调优不能只看 CPU 曲线。至少把 temporal_worker_task_slots_available、Workflow/Activity 的 schedule-to-start latency、进程或容器 CPU、内存,以及资源型调节器观测到的 CPU/内存放在同一时间窗里判断。
- 先用稳定压测负载建立基线,记录吞吐、P95/P99 schedule-to-start、CPU、内存和可用槽位。
- 若排队持续升高、可用槽位接近零,而 CPU 和内存仍明显低于目标,先检查 poller、下游等待和其他并发边界;确认没有别的瓶颈后再提高资源目标。
- 若内存接近容器上限、GC 或 RSS 压力明显,即使 CPU 很空也应降低内存目标,而不是继续增加并发。
- 若 CPU、内存都已接近目标且 backlog 仍增长,继续提高 target 只会压缩安全余量,此时应增加 Worker 副本或拆分 Task Queue。
选择固定还是资源型 Supplier
负载资源消耗非常稳定、并且已经通过压测得出安全并发上限时,固定大小 Supplier 更简单。实例规格经常变化、Task 资源成本波动明显,或者同一镜像会部署到不同 CPU/内存规格时,资源型 Supplier 更有价值。
最终验收标准不是“CPU 正好等于 80%”,而是在真实负载下让排队延迟、吞吐和资源余量同时稳定。只要 backlog 已经说明单机容量不足,就应把垂直调优和水平扩容分开处理。