
服务注册与分布式协调 / 系统课时
注入故障并验证恢复能力
注入故障并验证恢复能力
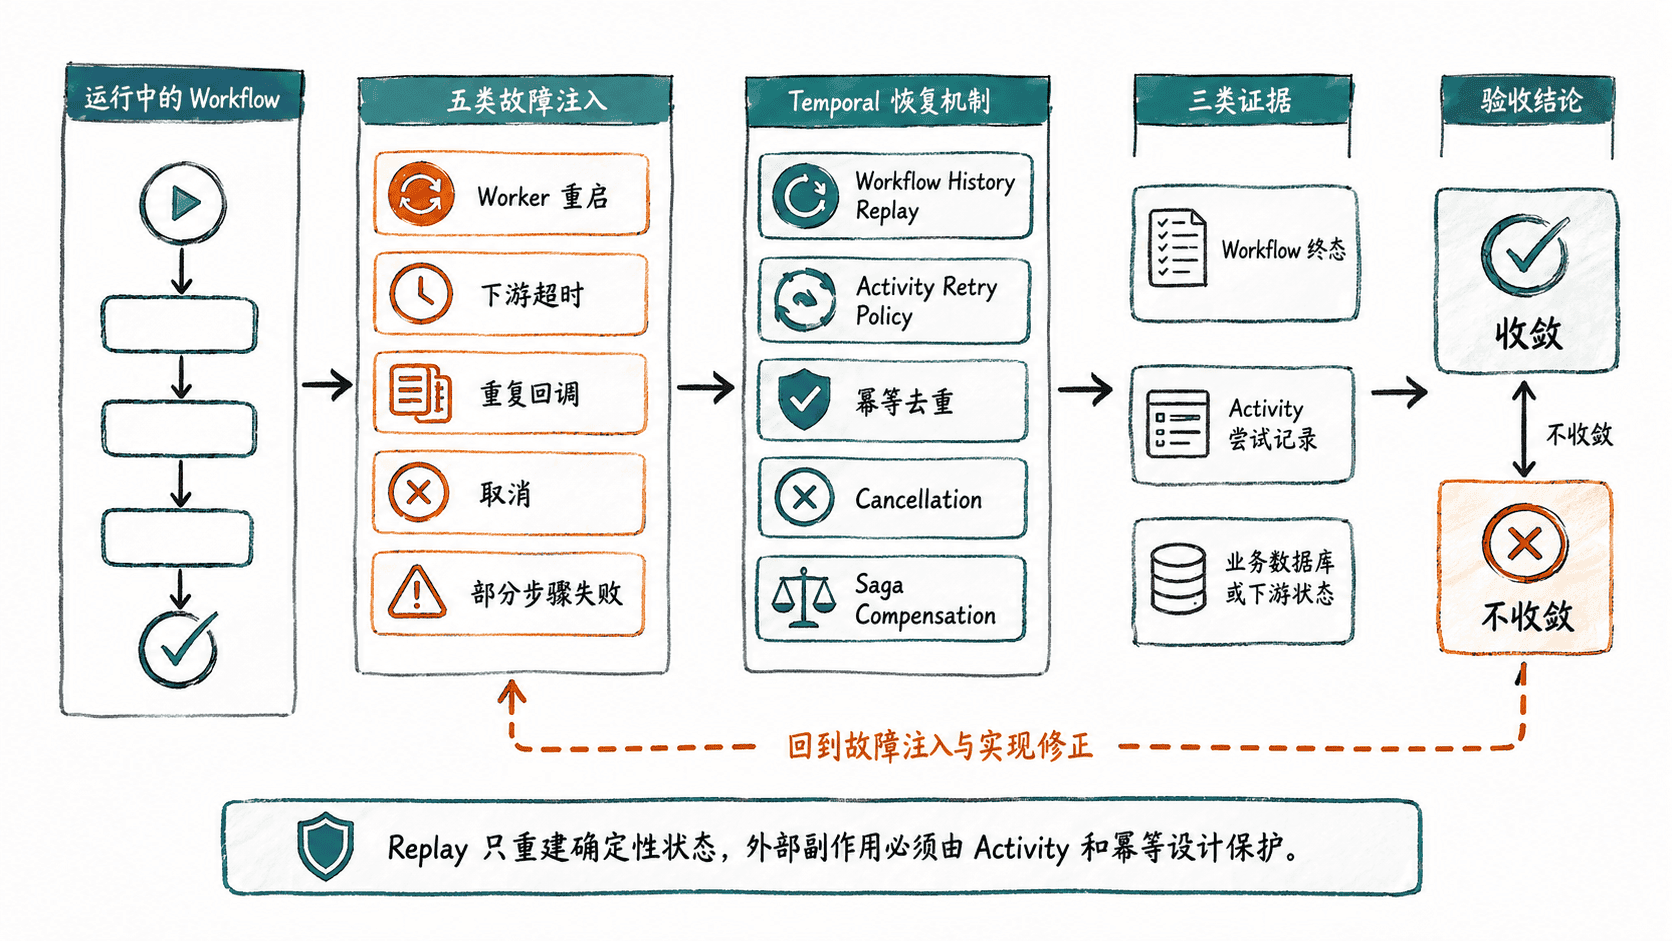
这一步不是证明“系统能重试”,而是验证真实故障发生后,Workflow 能从历史恢复、Activity 能按策略重试,重复输入不会推进两次状态,已经完成的副作用还能通过补偿最终收敛。
学习目标
- 为 Worker 重启、下游超时、重复回调、取消和部分失败定义可验证的恢复条件
- 按固定顺序注入故障,并从 Workflow、Activity 与业务状态三个层面采集证据
- 判断重试、Replay 或 Saga 补偿是否真正收敛,而不是暂时“看起来恢复”
先写清楚什么叫恢复成功
故障演练前先定义不变量,否则很容易把“Worker 又运行了”误判成恢复成功。可靠编排至少要同时满足:Workflow 最终进入预期终态;不可逆业务动作没有重复执行;Activity 的重试次数符合策略;补偿只针对已完成步骤执行,并且补偿本身可以安全重试。
| 故障 | 预期系统行为 | 验收证据 |
|---|---|---|
| Worker 重启 | 新 Worker 通过历史 Replay 恢复 Workflow 状态 | Workflow 继续推进,外部副作用没有重复 |
| 下游超时 | Activity 按 Retry Policy 重试 | 尝试次数增加,Workflow 不需要手写轮询重试 |
| 重复回调 | 相同业务事件只生效一次 | 状态机只推进一次,重复事件被幂等键拦截 |
| 取消 | Workflow 按取消语义停止或先补偿再停止 | 终态、补偿记录和 Activity 取消行为一致 |
| 部分步骤失败 | 已完成步骤按 Saga 规则补偿 | 最终业务状态回到允许的稳定状态 |
先验证 Worker 重启不会破坏执行
在预发布环境选一条正在等待或处理中间 Activity 的长流程,记录 Workflow ID,再重启 Worker Deployment。不要重启 Temporal Server,也不要删除 Workflow;目标是迫使新 Worker 接手后通过历史重放恢复执行。
set -euo pipefail

# 重启整个 Worker Deployment,验证新进程能接手已有执行
kubectl -n <K8S_NAMESPACE> rollout restart deployment/<WORKER_DEPLOYMENT>
kubectl -n <K8S_NAMESPACE> rollout status deployment/<WORKER_DEPLOYMENT> --timeout=120s
# 等待副本就绪后确认负责该任务队列的 Worker Pod 已恢复
kubectl -n <K8S_NAMESPACE> get pods -l app=<WORKER_LABEL>
预期输出
deployment.apps/<WORKER_DEPLOYMENT> restarted
deployment "<WORKER_DEPLOYMENT>" successfully rolled out
NAME                         READY   STATUS    RESTARTS   AGE
<WORKER_POD>                 1/1     Running   0          <TIME>
实际 Pod 名称和时间会不同。Worker 恢复后继续观察同一 Workflow:如果出现 nondeterminism、Workflow Task 持续失败,说明代码变更与历史不兼容;如果业务动作被再次执行,问题通常不在 Replay 本身,而在 Activity 或下游接口缺少幂等保护。
再按业务边界注入超时、重复与取消
下游超时应在可控的测试依赖、故障代理或预发布环境中注入。若验证客户端请求超时,让客户端超时短于 Activity 的 Start-To-Close;若验证 Temporal 的 Activity Timeout,则让故障持续超过对应 Timeout。不要在 Workflow 代码中用普通 sleep 加 while 循环模拟 Activity 重试,那会绕开 Temporal 的重试语义。
重复回调要使用稳定的业务幂等键,例如 paymentCallbackId 或订单事件 ID。回调进入 Workflow 后,先判断该键是否已经处理;即使调用方因为网络超时重复发送,也只能产生一次业务状态迁移。取消演练则要明确“立即停止”还是“先补偿再停止”,并检查长时间 Activity 是否通过 heartbeat 或取消检查及时响应;若取消后仍需执行补偿,应使用所用 SDK 提供的独立于已取消 Workflow Context 的补偿执行方式。
对于部分步骤失败,至少准备一个“前两步成功、第三步失败”的用例。补偿顺序应与副作用依赖一致,常见做法是逆序补偿;每个补偿 Activity 同样要幂等,因为补偿自身也可能超时并被重试。
用证据判断是否真正收敛
每个故障用例都要保留三组证据:Temporal 侧记录 Workflow 终态、Activity 尝试次数和失败原因;Worker 日志记录重启后的接管与异常;业务侧记录订单、库存、支付或通知等最终状态。只有三组证据相互一致,才算恢复能力通过。
Replay 的验收重点不是“日志里出现了 Replay”,而是同一历史在当前 Workflow 代码上可以确定性重放,并且重放不会再次执行已经记录过的外部副作用。上线前还应把本次演练得到的失败历史加入 Replay 回归集,后续每次修改 Workflow 代码都重新验证这些历史。