
服务注册与分布式协调 / 系统课时
排查 Task Queue 积压
排查 Task Queue 积压
Task Queue 积压的关键不是“队列里有多少任务”,而是任务为什么没有及时被 Worker 取走。本节从 backlog、Schedule-To-Start、Poller、执行槽位和主机资源入手,把容量不足、限速与 Worker 不健康分开定位,并给出修复后的验收方法。
学习目标
- 用 backlog 与 Schedule-To-Start 判断是否真的存在排队
- 结合 Poller、执行槽位和 Worker 资源区分不同瓶颈
- 按根因扩容、调参或恢复 Worker,并验证积压持续回落
先确认问题发生在排队阶段
Task 被写入 Task Queue 后,到 Worker 真正取走之前的等待时间就是 Schedule-To-Start。它持续升高,才说明任务在“等 Worker”;如果 Schedule-To-Start 正常,而 Activity 本身耗时很长,应转去检查执行逻辑或下游依赖。
backlog 也不能只看一个瞬时数字。连续观察 ApproximateBacklogCount、ApproximateBacklogAge、任务进入速率和派发速率:数量与最老任务年龄同时上升,并且进入速度长期高于派发速度,才是持续积压。Workflow Task 与 Activity Task 要分别看,避免把不同类型的负载混在一起。
按固定顺序检查 Task Queue 与 Worker
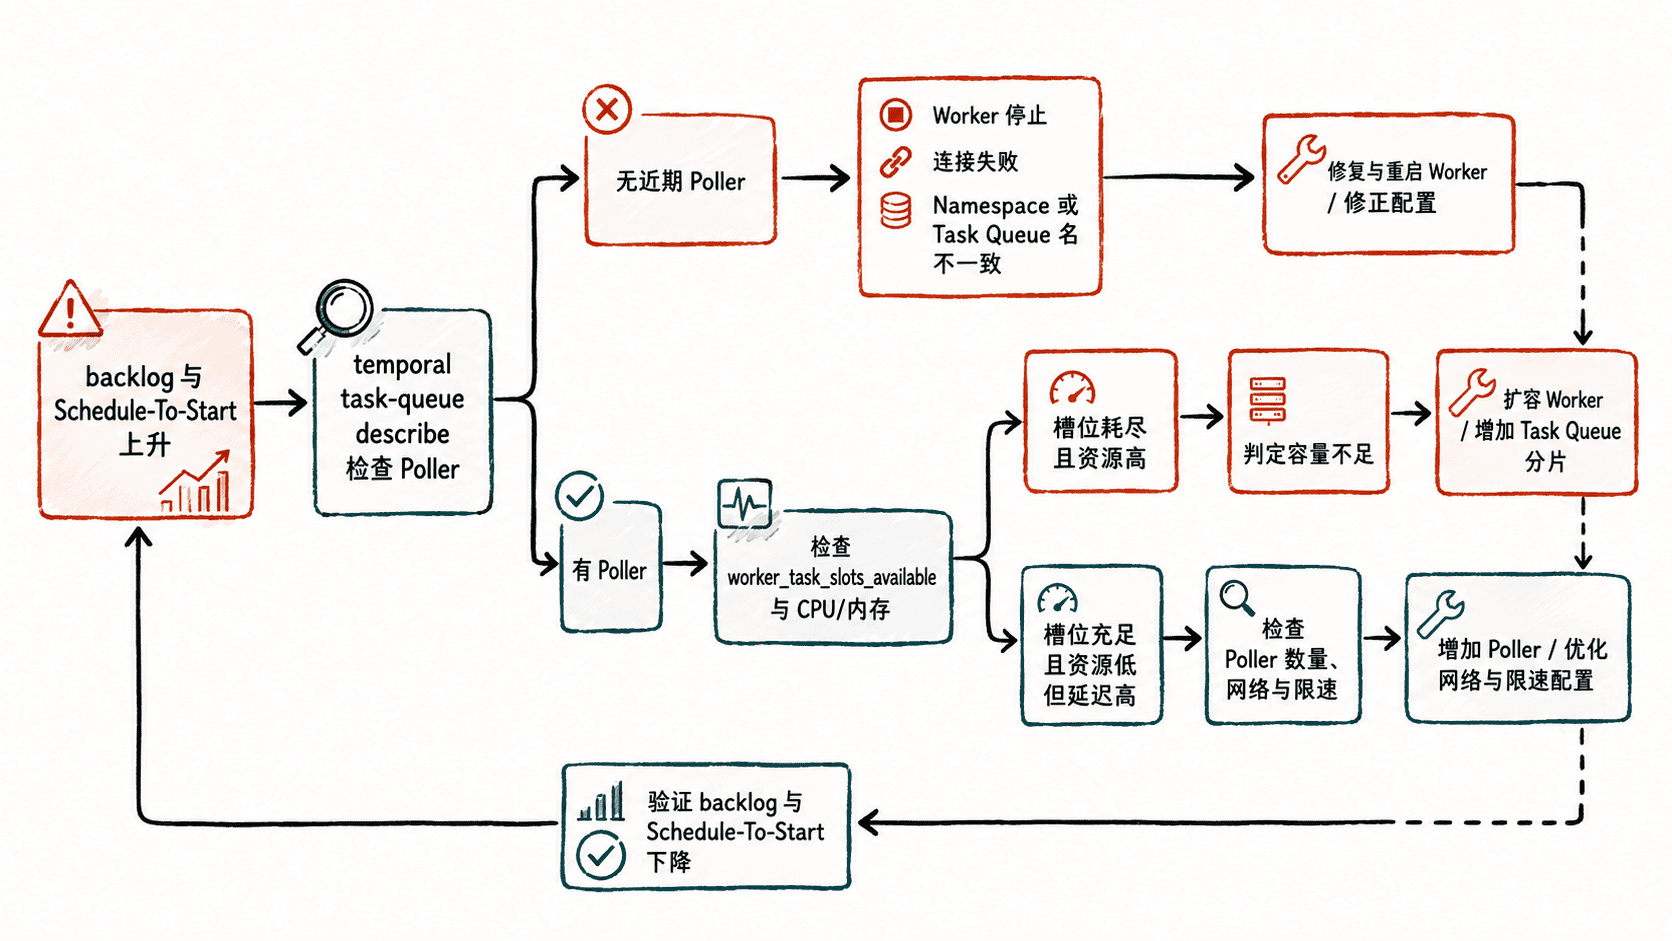
先直接描述目标 Task Queue,确认是否存在近期 Poller。以下命令假设已经配置好 Temporal CLI 的连接与认证信息。
temporal task-queue describe \
  --task-queue <TASK_QUEUE> \
  --namespace <NAMESPACE>
预期输出关键片段如下;具体 Worker 标识、任务类型和时间会因环境而变化。
Pollers:
  BuildID      TaskQueueType  Identity     LastAccessTime
  <BUILD_ID>   <TASK_TYPE>    <WORKER_ID>  <TIME>
如果没有 Poller,优先检查 Worker 进程、连接错误、Namespace 与 Task Queue 名是否一致。Temporal 的 Task Queue 按名称动态使用,客户端和 Worker 写错不同名字时,通常不会得到“队列不存在”的明显错误,而是形成两个互不相干的队列。
如果有 Poller,再看 Worker 的执行槽位与 CPU、内存。worker_task_slots_available 长期接近耗尽,同时主机 CPU 或其他关键资源接近上限,说明 Worker 已经吃满;若槽位仍大量空闲、主机也空闲,但 Schedule-To-Start 依然高,则要继续检查 Poller 数量、网络延迟与限速配置。
用信号组合判断根因
| 观测组合 | 更可能的根因 | 优先动作 |
|---|---|---|
| backlog、年龄和 Schedule-To-Start 上升;槽位少;CPU 高 | Worker 容量不足 | 增加 Worker 实例或资源,确认单机并发没有超过主机能力 |
| backlog 上升;主机空闲;槽位仍多;Poller 很少 | 拉取能力不足 | 优先启用 Poller 自动伸缩,或谨慎提高 Poller 数量 |
| Worker 与槽位都空闲,但任务仍排队 | Worker 或 Task Queue 限速 | 检查每 Worker、每 Task Queue 的 Activity 速率限制 |
| 没有近期 Poller | Worker 不健康或路由错误 | 恢复 Worker,核对连接、Namespace、Task Queue 名与部署版本 |
不要把“增加并发槽位”当成统一解法。CPU 密集型 Activity 在主机已经饱和时继续加槽位,只会放大上下文切换和下游压力;反过来,主机资源充足但槽位被配置得过小,则扩容实例不一定比调整槽位更有效。
Poller 也不是越多越好。Poller 负责把任务从服务端拉到可用执行槽位,真正执行仍受槽位和资源约束。大量空转 Poller 会增加无效长轮询,不能替代处理能力。
修复后验证积压真正消失
修复后不要只看 Worker “已启动”。在相同负载窗口内确认三件事:backlog 增长率从正值变为零或负值,最老任务年龄持续下降,Workflow Task 或 Activity Task 的 Schedule-To-Start 回到业务可接受区间。
如果扩容后 backlog 仍不下降,应再次比较任务进入速率与派发速率,并检查是否存在新的下游瓶颈或速率限制。不要通过缩短 Schedule-To-Start Timeout 来掩盖容量问题;那只会把等待转成超时失败,并不会创造新的 Worker 能力。