
服务注册与分布式协调 / 系统课时
排查 Activity 重试与超时风暴
排查 Activity 重试与超时风暴
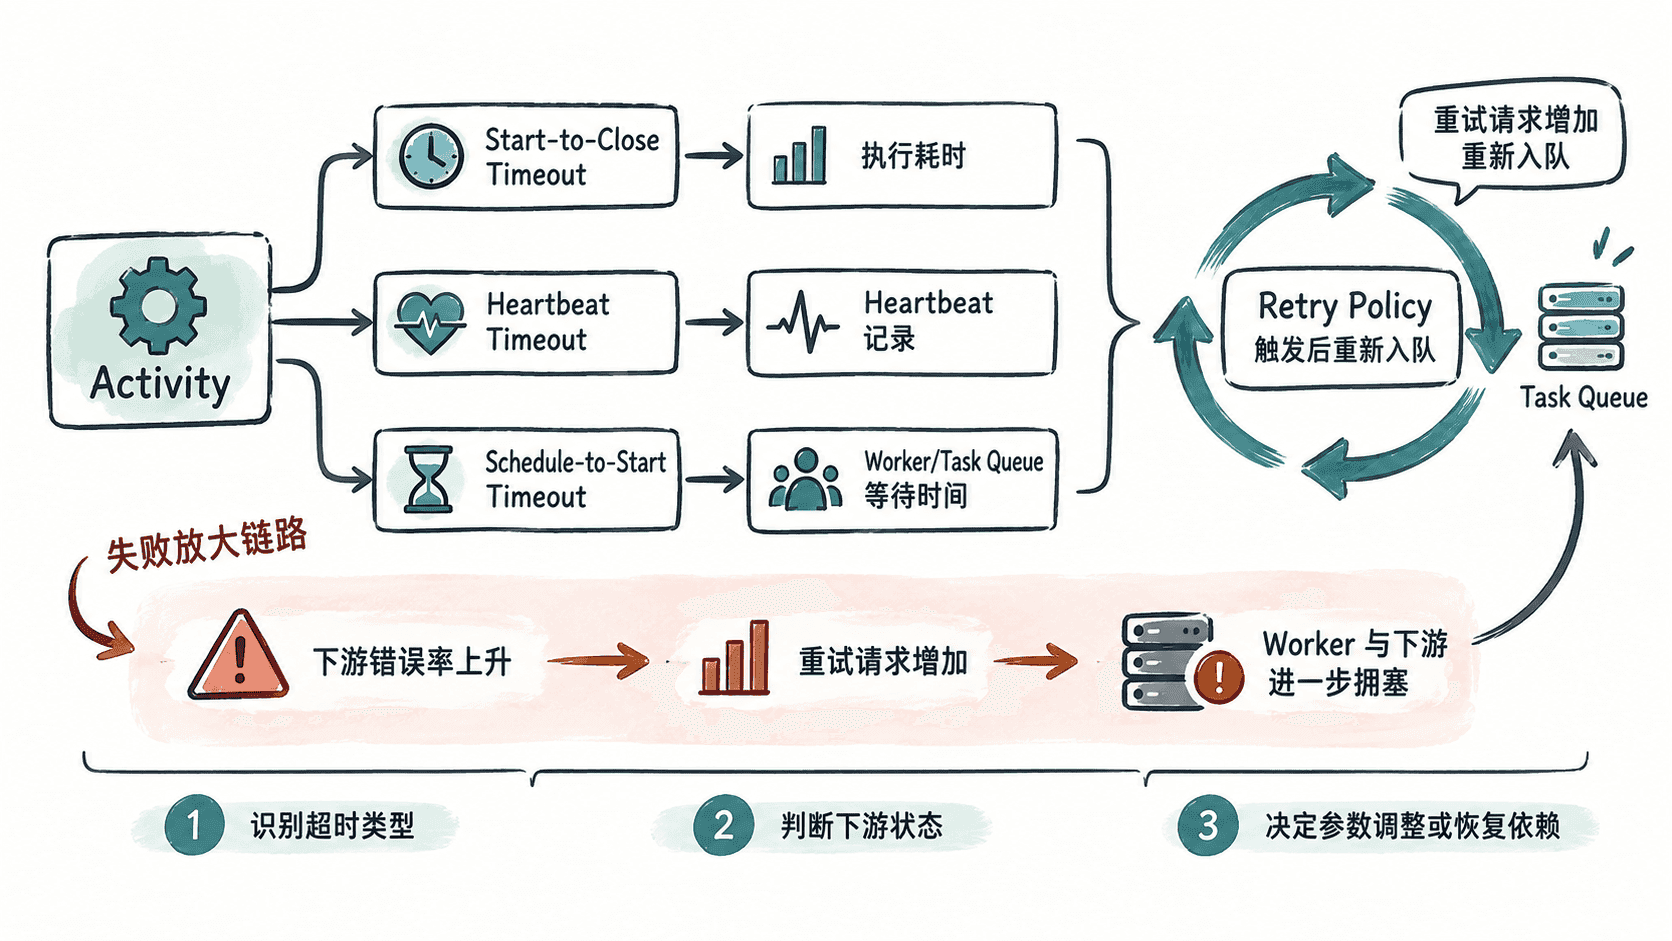
本课解决 Activity 大量超时、自动重试导致请求量继续上升的故障。排查重点不是先调大重试次数,而是沿着超时类型、重试策略、Heartbeat 和下游错误率定位失败放大路径,再决定改参数还是先恢复依赖服务。
学习目标
- 能区分 Start-to-Close、Schedule-to-Start 与 Heartbeat Timeout
- 能从 Retry Policy 判断失败是否会被持续放大
- 能根据下游错误率和 Activity 状态决定止损顺序
先判断是哪一种超时
Start-to-Close Timeout 限制一次 Activity Execution 从开始到完成所允许的最长时间;Heartbeat Timeout 用于长时间运行 Activity 的心跳保活;Schedule-to-Start Timeout 反映任务从进入队列到真正被 Worker 拉取前的等待时间。
三者对应的根因完全不同。执行时间持续过长,应检查 Activity 自身或下游耗时;Heartbeat Timeout 常提示长任务没有按预期发送心跳;Schedule-to-Start 持续升高,则更像 Worker 容量不足、任务队列堆积或分区压力。
从 Retry Policy 估算失败放大
重试不是免费保险。假设单个 Activity 初始调用失败后最多允许 4 次执行,那么一次业务请求最坏可能产生 4 次下游调用;当下游本身已经处于高错误率或限流状态时,自动重试会把负载继续推高。
下面的配置示例给一个保守的起点:限制最大尝试次数,同时让重试间隔指数退避,避免立即形成紧密重试环。
import { proxyActivities } from '@temporalio/workflow';
import type * as activities from './activities';

const { chargeCard } = proxyActivities<typeof activities>({
  startToCloseTimeout: '30 seconds',
  heartbeatTimeout: '10 seconds',
  retry: {
    maximumAttempts: 4,
    initialInterval: '2 seconds',
    maximumInterval: '30 seconds',
    backoffCoefficient: 2,
  },
});

export async function paymentWorkflow(): Promise<void> {
  await chargeCard();
}
预期结果
Activity 每次执行最多允许 4 次尝试;重试间隔从 2 秒开始按退避策略增长,最长不超过 30 秒。具体最大重试次数和超时时间不能机械照抄。它们必须小于业务可接受延迟,并与下游限流、幂等能力和服务恢复时间匹配。
用 Heartbeat 判断长任务是否真的活着
长时间运行的 Activity 不应单纯把 Start-to-Close Timeout 拉得很大,然后等待最终结果。更可靠的方式是设置合理的 Heartbeat Timeout,并在 Activity 执行期间周期性发送心跳,让 Temporal 知道任务仍然在推进。
排障时,如果大量 Activity 同时出现 Heartbeat Timeout,要重点检查 Worker 是否仍在执行、心跳调用是否被阻塞,以及 Activity 是否卡在外部 I/O。不要仅仅提高 Heartbeat Timeout 来掩盖 Worker 停顿。
判断应该改参数还是先恢复依赖
看到重试风暴时,先观察下游错误率、限流状态和 Worker 排队情况。如果下游返回大量连接失败、5xx、超时或明确限流,而 Worker 正常工作,此时继续增加 Retry Policy 往往会扩大故障面。优先恢复依赖、降低入口压力或暂时减少重试。
反过来,如果下游健康而 Activity 执行时间稳定超过当前 Start-to-Close Timeout,则参数可能设置过紧。此时应基于实际 p95/p99 执行时长调整 Timeout,并检查是否存在异常慢查询、网络调用或单次任务过大。
| 现象 | 更可能的方向 | 首要动作 |
|---|---|---|
| Start-to-Close Timeout 集中增加,下游错误率正常 | Activity 执行时间过长 | 检查执行耗时与外部调用 |
| Heartbeat Timeout 集中增加 | Activity 停顿或心跳异常 | 检查 Worker 与心跳路径 |
| Schedule-to-Start 持续升高 | Worker/Task Queue 堆积 | 检查 Worker 容量与并发 |
| 重试次数快速接近上限,下游同时报错 | 依赖故障或限流 | 先止损并恢复依赖 |
建立故障处置顺序
生产现场可以按“超时类型 → 下游健康度 → Worker/Task Queue → Retry Policy → 业务幂等性”的顺序定位。这样能先区分执行慢、排队慢和依赖失败,再判断自动重试是否正在扩大事故。
尤其不要在下游已经明显故障时同时提高 maximumAttempts、缩短 initialInterval 和放宽 Timeout。参数会互相叠加,可能让一次依赖故障演变成更大的连接、线程和队列压力。真正稳妥的处理是先控制失败放大,再根据证据调整单个参数,并用复测结果验证改变确实降低了故障率。