
服务注册与分布式协调 / 系统课时
理解 Sticky Execution 与缓存
理解 Sticky Execution 与缓存
本课解决 Workflow 为什么会偏向继续在原 Worker 上执行,以及缓存为什么既能降低 Replay 成本又会占用内存。掌握这两个关系后,你可以正确判断缓存命中、内存压力和 Worker 重启之间的性能权衡。
学习目标
- 理解 Sticky Execution 如何优先把 Workflow Task 交给已有执行上下文的 Worker
- 理解 Workflow 缓存与 Replay 成本之间的关系
- 能识别高缓存命中率与高内存占用之间的取舍
Sticky Execution 在解决什么问题
Workflow 代码需要保持确定性,因此 Worker 处理后续 Workflow Task 时,必要时可以通过 Replay 历史事件恢复执行状态。Replay 是可靠性的基础,但历史较长、事件较多时,它会带来额外 CPU 和延迟。
Sticky Execution 的核心思路是:如果某个 Worker 已经持有这个 Workflow 的执行上下文,就尽量继续把相关 Workflow Task 路由给它。这样可以提高缓存命中机会,减少从头构建执行上下文的成本。
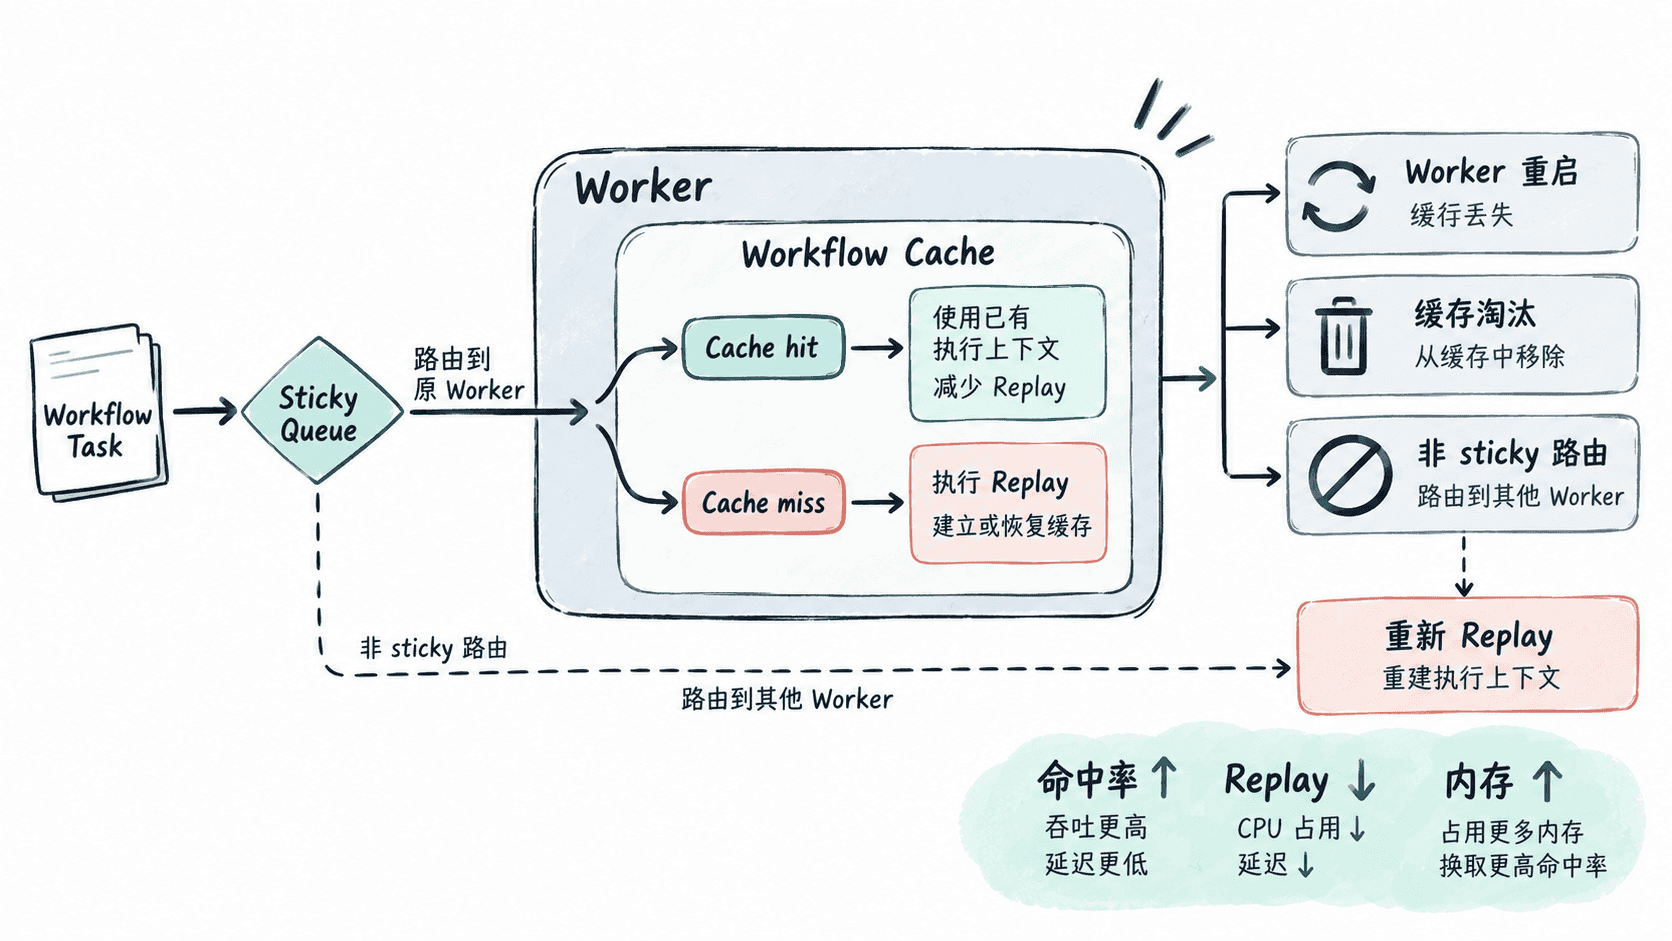
缓存命中不等于永远不 Replay
缓存命中时,Worker 可以复用已有 Workflow 执行上下文,因此通常能减少重复 Replay 工作。但缓存并不是永久状态:Worker 重启、缓存淘汰、内存压力或任务落到其他 Worker 后,都可能重新 Replay 历史事件。
这意味着容量设计不能简单追求“缓存越大越好”。缓存越大,命中机会通常越高,但 Worker 常驻内存也会上升;当进程接近内存上限时,频繁 GC、缓存淘汰甚至 OOM 都可能抵消收益。
从三个指标一起看缓存效果
只观察缓存命中率是不够的。至少要同时看 缓存命中情况、Worker 内存使用和 Replay 成本。例如命中率继续提升,但进程 RSS 接近内存上限,说明继续扩大缓存已经可能得不偿失。
一个简单的容量关系可以写成:
因此,Worker 的内存上限必须给 Replay 所需对象、SDK 运行时、线程以及其他缓存留出余量,不能把全部 limit 都留给 Workflow Cache。
一个配置思路
不同 Temporal SDK 的具体参数名称和默认值可能不同,下面用伪配置表达调优方法。这里重点是“先控制缓存容量,再结合监控验证”,不是直接套用某个 SDK 的参数名。
# 片段示例:表达 Worker 缓存调优意图,具体参数名以所用 SDK 版本为准
worker:
  workflowCache:
    enabled: true
    maxCachedWorkflows: <VALUE>
  resources:
    memoryLimit: <VALUE>
  metrics:
    export:
      - workflow_cache_hit
      - workflow_cache_eviction
      - replay_latency
预期结果
缓存开启后:已有执行上下文的 Workflow 更容易复用本地状态
缓存被淘汰或 Worker 重启后:相关 Workflow 需要重新构建执行上下文
监控中:能同时观察命中、淘汰、Replay 延迟和内存压力
这里的 <VALUE> 必须根据实际 SDK、Worker 进程规格和生产负载压测确定,不能直接照搬为固定数字。
Worker 重启为什么会影响短期性能
Worker 重启会清空进程内缓存。重启后的 Worker 虽然仍然可以正确处理 Workflow,但一段时间内会出现更多缓存未命中与 Replay,导致 CPU 消耗和处理延迟暂时升高。
因此,发布策略也会影响 Sticky Execution 的收益。频繁滚动重启、过度激进的扩缩容或实例寿命过短,都可能让缓存刚建立就被清掉。扩缩策略需要同时关注吞吐和缓存热度,而不是只看 CPU 使用率。
什么时候应该牺牲部分命中率
对于低频、短历史的 Workflow,Replay 本身可能很便宜,此时没有必要为了提高少量命中率而显著增加内存。相反,对高频、长历史、持续活跃的 Workflow,缓存带来的收益可能更明显。
判断标准应落在实际成本上:扩大缓存是否明显降低 Replay CPU 和延迟,同时又没有把内存压力推到危险区间。 当答案是否定的,就应接受部分 Replay,而不是继续堆缓存。
最终,Sticky Execution 是一种性能优化路径,不改变 Workflow 的正确性边界。正确的 Worker 容量设计应让缓存收益服务于吞吐和延迟目标,同时为缓存淘汰和 Worker 重启后的重新 Replay 保留足够资源。