
服务注册与分布式协调 / 系统课时
使用 Heartbeat 记录长任务进度
使用 Heartbeat 记录长任务进度
长时间 Activity 最怕“做了很久却因 Worker 崩溃而从头重跑”。本课把 Heartbeat 同时当作存活信号和安全检查点:任务定期上报已完成位置,重试时读取最后进度,只重做尚未确认的部分。
学习目标
- 配置
HeartbeatTimeout,理解 Heartbeat 与 Activity 重试的配合方式 - 用 Heartbeat details 保存紧凑、可恢复的进度检查点
- 在 Worker 中断后从最后安全位置继续,并避免检查点导致重复副作用
Heartbeat 解决的是“还活着”和“做到哪了”
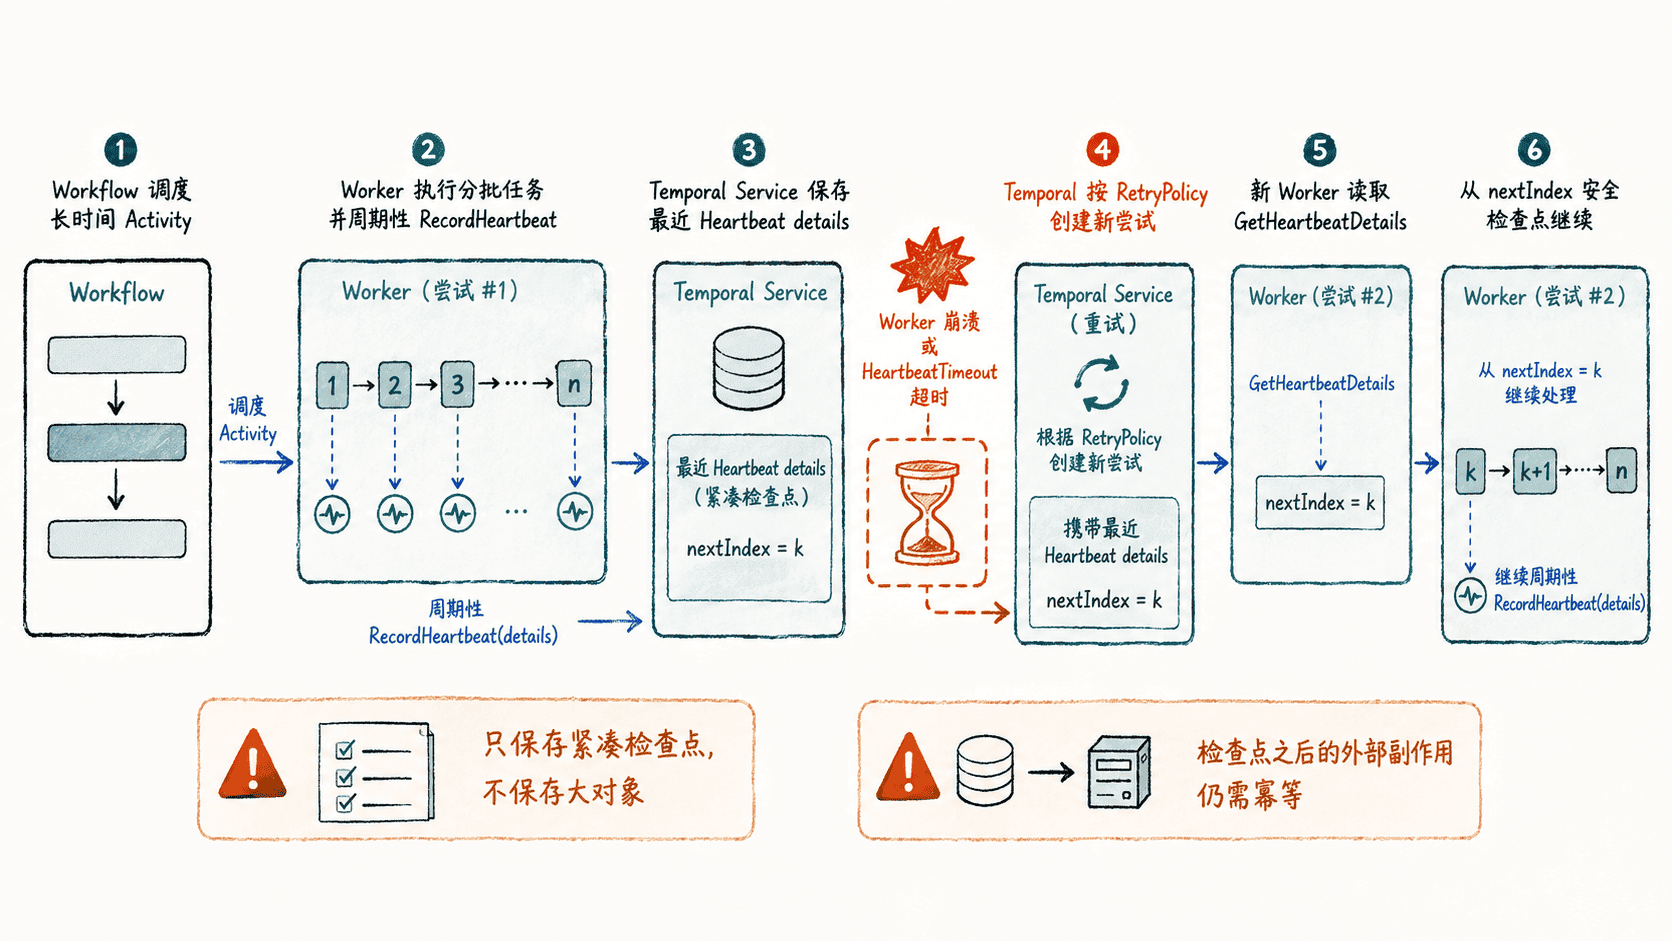
普通 Activity 只在结束时向 Temporal 返回结果。任务若运行几十分钟,中途 Worker 进程退出、主机失联或超过 Heartbeat 超时,Temporal 需要一种方式判断当前尝试已经失效。为 Activity 配置 HeartbeatTimeout 后,Activity 应在小于该超时的间隔内调用 activity.RecordHeartbeat。
Heartbeat details 可以携带可序列化的进度。重试尝试启动时,Go SDK 可通过 activity.HasHeartbeatDetails 和 activity.GetHeartbeatDetails 读取上一失败尝试留下的最后进度,因此“重试”不必等于“从第 0 项重新执行”。
把检查点定义成可重复解释的业务位置
检查点要表达“哪些工作已经安全完成”,而不是只表达“循环执行到了哪里”。最简单的批处理可以保存 nextIndex:索引小于它的项目都已完成,重试从该索引继续。这样比保存“lastIndex”更不容易产生加一减一错误。
如果每个项目会写数据库、发消息或调用第三方接口,Heartbeat 本身不会回滚这些副作用。应让单项操作具备幂等键、唯一约束或去重机制,再在副作用确认成功后推进检查点。检查点数据应保持小而稳定,例如索引、游标、分页 token 或最后成功的业务 ID,不要把整个输入集合塞进 Heartbeat details。
在 Go Activity 中恢复进度
以下为片段示例,依赖已经注册 ProcessBatch 的 Temporal Go Worker。代码把 NextIndex 定义为下一条待处理记录,并在每项成功后上报;Workflow 同时设置 Heartbeat 超时和有限重试策略。
package batch

import (
    "context"
    "fmt"
    "time"

    "go.temporal.io/sdk/activity"
    "go.temporal.io/sdk/temporal"
    "go.temporal.io/sdk/workflow"
)

type BatchProgress struct {
    NextIndex int
}

func ProcessBatch(ctx context.Context, items []string) error {
    progress := BatchProgress{}

    if activity.HasHeartbeatDetails(ctx) {
        if err := activity.GetHeartbeatDetails(ctx, &progress); err != nil {
            return fmt.Errorf("decode heartbeat details: %w", err)
        }
        activity.GetLogger(ctx).Info("恢复检查点", "nextIndex", progress.NextIndex)
    }

    for i := progress.NextIndex; i < len(items); i++ {
        if err := processOne(ctx, items[i]); err != nil {
            return err
        }

        // 只有当前项已安全完成后,才推进“下一项”检查点。
        progress.NextIndex = i + 1
        activity.RecordHeartbeat(ctx, progress)
    }

    activity.GetLogger(ctx).Info("Activity 完成", "total", len(items))
    return nil
}

func processOne(ctx context.Context, item string) error {
    timer := time.NewTimer(2 * time.Second)
    defer timer.Stop()

    select {
    case <-ctx.Done():
        return ctx.Err()
    case <-timer.C:
        return nil
    }
}

func BatchWorkflow(ctx workflow.Context, items []string) error {
    options := workflow.ActivityOptions{
        StartToCloseTimeout:    30 * time.Minute,
        ScheduleToCloseTimeout: 2 * time.Hour,
        HeartbeatTimeout:       10 * time.Second,
        RetryPolicy: &temporal.RetryPolicy{
            InitialInterval:    time.Second,
            BackoffCoefficient: 2,
            MaximumAttempts:    5,
        },
    }

    ctx = workflow.WithActivityOptions(ctx, options)
    return workflow.ExecuteActivity(ctx, ProcessBatch, items).Get(ctx, nil)
}
预期结果:假设首个 Worker 已成功处理前 37 项并上报 NextIndex=37 后退出,新的尝试不会再次从第 0 项开始。忽略 SDK 日志前缀后,关键业务日志应类似:
<TIME> 恢复检查点 nextIndex=37
<TIME> Activity 完成 total=100
实际时间戳、尝试编号和日志前缀会因运行环境不同而变化。若一次处理可能超过 HeartbeatTimeout,不要只在“处理完一项”后心跳;应在单项内部也定期上报,确保最长无心跳间隔始终明显小于超时值。
用故障注入验证恢复点
验证时不要只看“最终成功”,而要主动破坏第一次尝试。准备一批足够长的输入,让 Activity 至少产生数次 Heartbeat;确认日志中的 nextIndex 已推进后终止 Worker,再启动同一 Task Queue 的 Worker。新的 Activity 尝试应读取已有 Heartbeat details,并从该位置继续。
验收重点有三个:已确认项目没有因重试产生不可接受的重复副作用;未确认项目最终全部完成;Heartbeat 间隔小于配置的超时。满足这三点,Heartbeat 才真正把长任务从“只能整段重试”改造成“可从安全检查点恢复”的 Activity。