
服务注册与分布式协调 / 系统课时
设计可关联的结构化日志
设计可关联的结构化日志
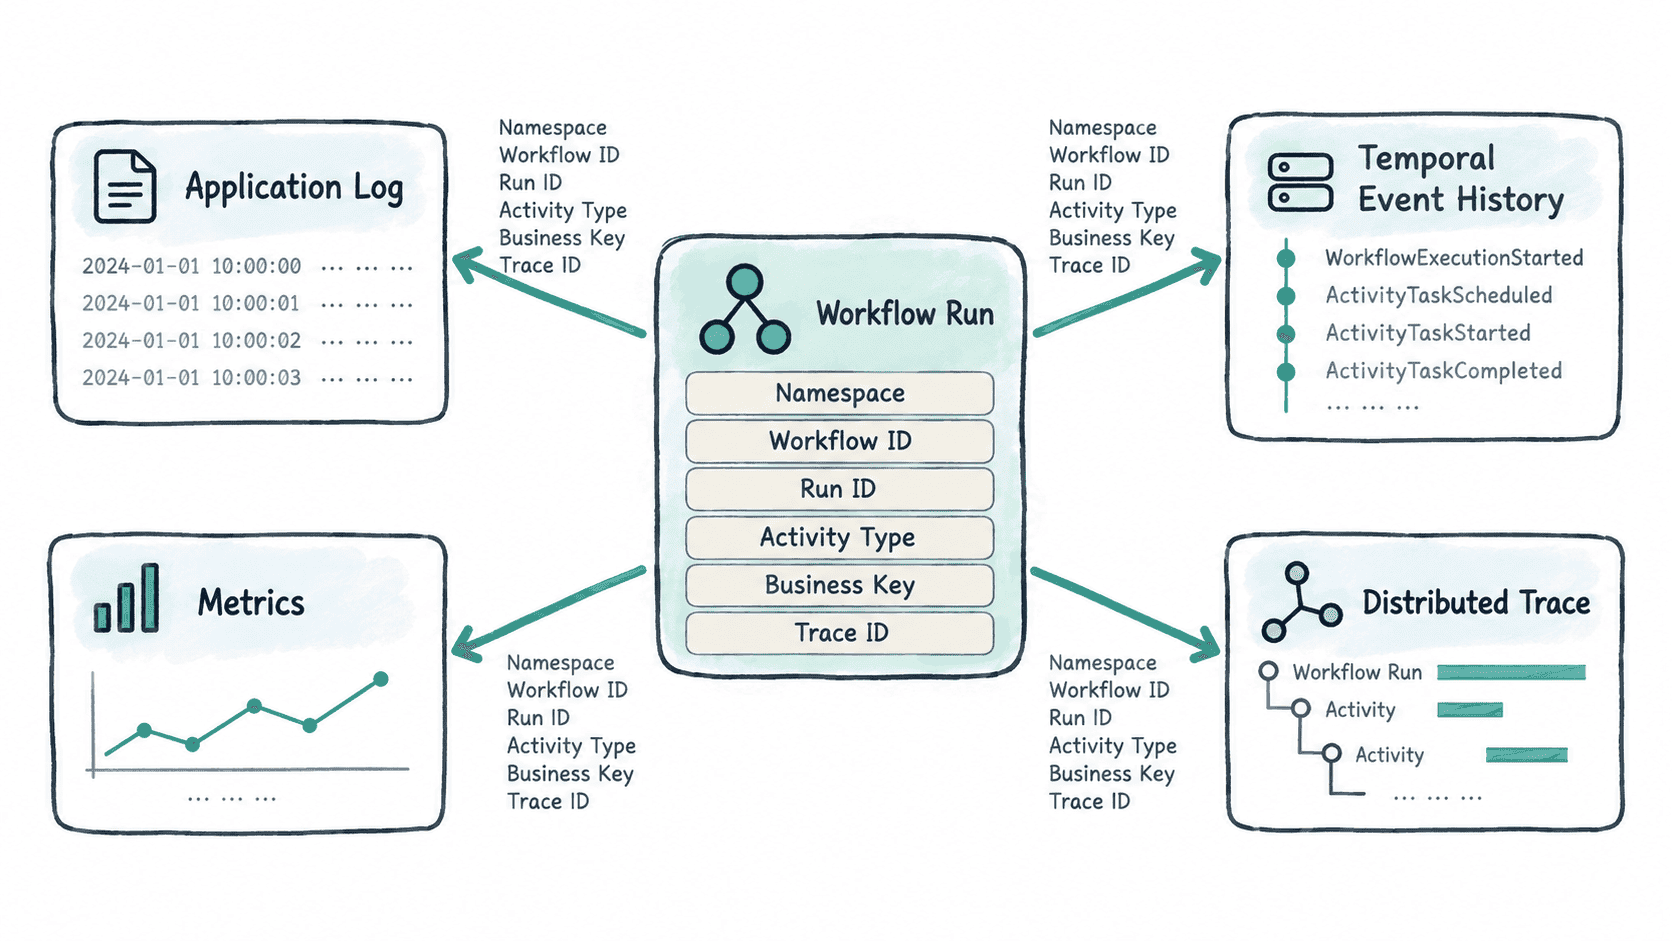
本课解决“日志看到了,却无法对应到具体 Workflow 执行”的问题。通过统一记录 Namespace、Workflow ID、Run ID、Activity 类型和业务关联键,让一次业务请求可以从应用日志一路关联到事件历史、指标和 Trace。
学习目标
- 能确定 Temporal 结构化日志中必须稳定记录的关联字段
- 能区分 Workflow ID、Run ID 与业务关联键各自的用途
- 能设计便于检索、聚合和跨观测系统跳转的日志格式
先定义稳定的关联字段
结构化日志首先要回答“这条日志属于哪一次执行”。对于 Temporal 应用,最重要的是 Namespace、Workflow ID 和 Run ID;记录 Activity 类型后,可以进一步定位到具体任务。业务关联键则把技术执行映射回订单、用户、任务或请求等业务对象。
建议把字段职责固定下来,不要不同模块使用不同名称。一个简单约定如下:
| 字段 | 作用 |
|---|---|
namespace |
定位 Temporal 逻辑隔离范围 |
workflow_id |
定位业务工作流执行身份 |
run_id |
定位一次具体 Workflow Run |
activity_type |
定位执行中的 Activity 类型 |
business_key |
把技术执行关联到业务对象 |
trace_id |
关联分布式 Trace |
其中 workflow_id 更适合业务级检索,run_id 更适合精确定位一次实际执行。两者同时记录,可以避免只知道一个业务 Workflow ID 却无法判断当前是哪次 Run 的问题。
让日志字段真正进入每条关键日志
字段设计完成后,关键是保持字段出现的一致性。不要只在 Workflow 启动日志里打印 Workflow ID,Activity 开始、成功、失败和业务关键节点也应沿用同一组上下文。
下面是一个 Python 日志结构的片段示例。它展示字段组织方式,实际的 Temporal SDK 上下文注入方式应结合你的 SDK 和日志框架实现。
import json
import logging

logger = logging.getLogger(__name__)


def log_activity_event(
    event: str,
    namespace: str,
    workflow_id: str,
    run_id: str,
    activity_type: str,
    business_key: str,
    trace_id: str,
) -> None:
    # 字段名固定后,日志平台才能稳定检索和聚合。
    payload = {
        "event": event,
        "namespace": namespace,
        "workflow_id": workflow_id,
        "run_id": run_id,
        "activity_type": activity_type,
        "business_key": business_key,
        "trace_id": trace_id,
    }
    logger.info(json.dumps(payload, ensure_ascii=False))
预期结果
日志事件包含稳定的关联字段,例如:
{"event":"activity_failed","namespace":"<NAMESPACE>","workflow_id":"<ID>","run_id":"<ID>","activity_type":"ChargePayment","business_key":"<ID>","trace_id":"<ID>"}
这里的 <ID>、<NAMESPACE> 是动态值,实际运行时会被真实标识替换。关键不是日志文本长什么样,而是字段可以被日志系统按精确字段检索,而不是必须依赖字符串匹配。
统一检索入口,减少跨系统跳转成本
一条生产日志最好能够支持多种查询路径。例如先按 business_key 找到业务对象,再按 workflow_id 聚合整个业务执行,最后用 run_id 缩小到具体一次执行。发现 Activity 失败后,再用 trace_id 对齐同一请求链路中的服务调用。
因此,日志字段设计不能只服务日志平台本身。它应该与指标标签、Trace 属性以及 Temporal 执行标识保持语义一致。字段名称可以因工具限制而不同,但字段含义必须一一对应。
避免两个常见关联陷阱
第一,不要把业务 ID 当成唯一技术执行身份。一次业务对象可能经历多次 Workflow Run,只记录业务 ID 会把不同执行混在一起。
第二,不要把过度动态的信息全部做成指标标签。像 Run ID 这样的高基数字段非常适合日志和 Trace 检索,但直接放进高流量指标的标签可能导致时间序列数量快速膨胀。指标负责聚合趋势,日志和 Trace 负责精确定位。
最终应形成一个稳定的关联闭环:业务关联键负责从业务入口找到执行,Workflow ID 和 Run ID 负责锁定 Temporal 执行,Activity 类型负责缩小到具体任务,Trace ID 负责继续追踪跨服务调用。这样日志不再是孤立文本,而是连接执行历史、指标和 Trace 的索引入口。